La prima volta che il binario mi ha morso per davvero, non era in un corso di informatica-scienza - era in un bug di produzione Un plugin WordPress che mantengo stava memorizzando una stringa corta in un modo che ha mutilato qualsiasi carattere non inglese, e per capire dove è avvenuta la corruzione ho dovuto guardare i byte effettivi Ho incollato la stringa rotta in un & quot; testo in binario" scatola che ho trovato online, ho recuperato un muro di uno e zero e ho immediatamente realizzato che lo strumento aveva gestito solo i caratteri ASCII e lasciato cadere silenziosamente quelli accentati I byte che mi mostrava erano una bugia, e ho sprecato un pomeriggio inseguendo lo strato sbagliato dello stack.
Questo è il problema della conversione binaria: sembra un giocattolo e la maggior parte degli strumenti gratuiti lo trattano come uno. Un traduttore adeguato deve codificare l'intera gamma di caratteri che le persone effettivamente digitano - accenti, emoji, cinese, arabo - attraverso UTF-8, la codifica su cui funziona il Web moderno e deve decodificarli byte per byte. Costruisco Toolz.dev, il plug-in WP Admin e una discreta quantità di Laravel e React, quindi mi sposto tra il testo e la sua rappresentazione di byte più di quanto vorrei, e ho costruito il traduttore binario Per eseguire correttamente la conversione per ogni personaggio, non solo per il facile 128.
tl; dr: Un traduttore binario trasforma il testo in quelli e zeri un computer memorizza e trasforma quelli e gli zeri in testo. La catch è la codifica dei caratteri: ASCII copre solo 128 caratteri, mentre il testo reale ha bisogno di UTF-8, dove un carattere può essere da uno a quattro byte. la traduttore binario codifica e decodifica l'intero Unicode gamma - tra cui emoji - in binario, esadecimale, decimale e ottale, interamente nel browser, e ti dice esattamente quale token è sbagliato quando una pasta non riesce a decodificare.
Cos'è davvero un traduttore binario?
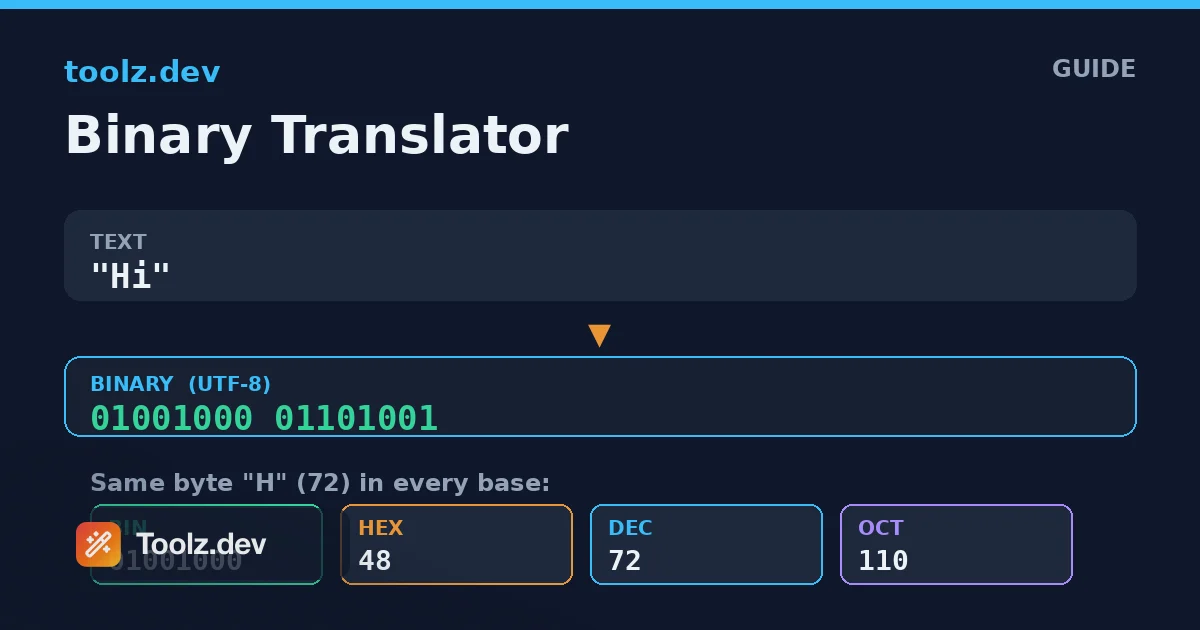
Un traduttore binario è un convertitore tra testo leggibile dall'uomo e la rappresentazione numerica che un computer utilizza per memorizzare quel testo Ogni carattere digitato viene memorizzato come uno o più byte - numeri da 0 a 255 - e ogni byte può essere scritto in binario (base 2), esadecimale (base 16), decimale (base 10) o ottale (base 8) Traducendo & quot; Hi" in binario dà 01001000 01101001; i due gruppi di otto bit sono i due byte per "h" e "i".
La parola & quot;translate" sta facendo un vero lavoro qui, perché c'è una tabella di traduzione coinvolta Un valore di byte di 72 non significa intrinsecamente la lettera & quot; H" - significa & quot; H" solo perché lo dice una codifica di caratteri Per le lettere inglesi di base, le cifre e la punteggiatura comune, quella mappatura è ASCII, uno standard degli anni '60 che assegna 128 caratteri ai valori da 0 a 127. ASCII è il motivo per cui & quot; H" è 72 e uno spazio è 32, ed è la parte della conversione binaria che tutti ottengono a destra.
I problemi iniziano sopra il valore 127. il mondo digita molto più di 128 caratteri distinti e la codifica che gestisce il resto - quella che il tuo browser, il tuo database e il tuo JSON quasi certamente usano - è UTF-8. un buon traduttore binario è davvero un codec UTF-8 con un livello di conversione di base sopra. il traduttore binario è costruito esattamente in questo modo, motivo per cui può andare a round trip una stringa contenente un'emoji e restituirti il carattere identico.
Come funziona effettivamente la conversione del testo in binario?
Trasformare il testo in binario è una pipeline in due fasi e la comprensione delle fasi spiega tutto ciò che fa lo strumento. La prima fase è Codificare i caratteri in byte, e il secondo è Scrivendo ogni byte nella base scelta.
La codifica è dove vive UTF-8. UTF-8 è una codifica a lunghezza variabile: un carattere prende un byte se si tratta di un carattere ASCII semplice, due byte per la maggior parte delle lettere con accenti latini e molti simboli, tre byte per la maggior parte delle script del mondo tra cui cinese, giapponese e coreano e quattro byte per caratteri meno comuni ed emoji. Quindi "A" è un byte, "É" è due, "中" è tre e un'emoji facciale è quattro. L'encoder attraversa la stringa e per i caratteri al di fuori dell'intervallo di base produce la sequenza multi-byte corretta, completa di bit iniziali che segnano quanti byte seguono.
Il secondo stadio è pura aritmetica. Una volta che hai un elenco di valori di byte, scrivendoli in binario significa esprimere ogni numero da 0 a 255 come otto bit, zero imbottito in modo che ogni byte abbia la stessa larghezza. Hexadecimal scrive ogni byte esattamente come due caratteri (da 00 a FF), motivo per cui HEX è il preferito compatto per la visualizzazione dei dati grezzi. Ottale utilizza tre cifre per byte e decimale mostra solo il numero semplice. la traduttore binario ti consente di passare istantaneamente da una base all'altra perché i byte sottostanti sono gli stessi: cambia solo il formato di visualizzazione.
In che modo il traduttore decodifica il binario al testo?
La decodifica inverte la pipeline ed è la direzione in cui la maggior parte degli strumenti fallisce silenziosamente. Innanzitutto lo strumento deve Leggi il tuo input nei valori dei byte, allora deve Decodifica quei byte come UTF-8 in caratteri.
Leggere l'input significa tokenizzare Se incolli binario con spazi tra i byte, ogni gruppo è un byte Se incolli una lunga serie continua di bit, lo strumento li raggruppa in otto - che funziona solo se la lunghezza totale è un multiplo di otto, quindi viene contrassegnata una lunghezza dispari anziché essere letta in modo errato silenziosamente La stessa logica si applica all'esadecimale: due caratteri per byte, quindi un numero dispari di cifre esadecimali è un errore Commas, spaces, tabs e interruzioni di riga funzionano tutti come separatori, quindi puoi incollare qualunque formato hai copiato senza prima riformattarlo.
Il secondo stadio ricostruisce i caratteri dai byte, ed è qui che la struttura di UTF-8' s conta Un byte nell'intervallo 0-127 è un carattere autonomo Un byte con uno specifico pattern ad alto bit segnala l'inizio di una sequenza di due, tre o quattro byte, e i byte che seguono devono avere un proprio pattern di continuazione Se non lo fanno - perché manca un byte, o la sequenza è stata tagliata, o i dati non erano mai validi UTF-8 per cominciare - il traduttore binario Riferisce che la sequenza di byte non è testo valido anziché emettere caratteri sostitutivi o spazzatura. Questa onestà è il punto: quando una decodifica fallisce, vuoi sapere che i dati sono sbagliati, non fissare Mojibake chiedendoti se lo strumento si è rotto.
Binario, esadecimale, decimale o ottale - quale dovrei usare?
Rappresentano tutti gli stessi byte, quindi la scelta riguarda chi sta leggendo e a cosa sono abituati. Ogni base ha una nicchia dove è la vestibilità naturale.
| zoccolo | cifre per byte | Meglio per | Esempio per "H" (72) |
|---|---|---|---|
| binario (2) | 8 | Apprendimento, lavoro a livello di bit, che mostra la struttura esatta | 01001000 |
| esadecimale (16) | 2 | Visualizzazione di dati grezzi, debug, dump di colori e byte | 48 |
| decimale (10) | 1–3 | Valori di byte a misura di uomo, riferimento rapido | 72 |
| ottale (8) | 3 | Autorizzazioni di file Unix, alcuni sistemi legacy | 110 |
Binary è il più esplicito e il migliore per l'insegnamento, perché si può vedere ogni bit, ma è verboso - otto caratteri per byte somma veloce Esadecimale è quello che effettivamente utilizzerai di più in pratica: è compatto, si mappa in modo pulito a byte a due caratteri ciascuno, ed è il formato hex editor, dump di memoria, e codici colore tutti parlano decimale è utile quando si vuole solo conoscere un carattere's valore numerico Octal è un holdover di nicchia, più familiare da Unix permessi bit come 755, ed è qui principalmente così lo strumento è completo. la traduttore binario Passa da un punto all'altro senza che tu reinserisca nulla, in modo da poter confrontare le rappresentazioni fianco a fianco.
Perché UTF-8 è così importante per la conversione binaria?
Perché & quot;text to binary" non ha senso finché non decidi attraverso quale codifica stai convertendo, e per il web moderno quella risposta è quasi sempre UTF-8. uno strumento che gestisce solo ASCII sembrerà funzionare - convertirà felicemente il testo inglese - e poi ti tradirà nel momento in cui i dati del mondo reale si presentano.
Considera l'accento "É". In UTF-8 è di due byte, 11000011 10101001, o c3 a9 in esadecimale. Uno strumento che tratta ogni personaggio come un singolo byte ASCII non può rappresentarlo affatto; nel migliore dei casi lascia cadere il personaggio, nel peggiore dei casi produce un byte sbagliato. Ora considera un emoji, che è di quattro byte in UTF-8. Gli strumenti ingenui li gestiscono completamente. Perché il traduttore binario è un vero codec UTF-8, "Café" produce i cinque byte corretti e incolla esattamente i cinque byte indietro di ritorno "café" esattamente.
Questo non è accademico. Chiunque tocchi contenuti internazionalizzati, dati generati dall'utente o qualsiasi cosa con un emoji colpirà immediatamente i personaggi a più byte. Se vuoi lo sfondo più profondo, il Guida alla codifica Base64 Copre lo stesso pensiero a livello di byte per una codifica correlata e la comprensione di uno fa clic sull'altro. La versione breve: i byte sono universali, ma la mappatura tra byte e caratteri è una scelta e UTF-8 è la scelta del Web fatto.
Casi di uso comune in cui un traduttore binario guadagna la sua mastio
Imparare e insegnare come i computer memorizzano il testo
Il motivo più comune per cui le persone cercano un traduttore binario è capire il concetto. Digitare il tuo nome e guardarlo diventare byte rende l'astrazione concreta in un modo che una lezione non può. Poiché lo strumento mostra i gruppi esatti a otto bit e consente di passare a esadecimale e decimale, funge anche da supporto didattico per il modo in cui si relazionano la codifica e le basi numeriche. Gli studenti possono vedere che "A" è 65, 01000001, e 41 in esadecimale tutto in una volta.
Problemi di codifica del debug
È qui che lo raggiungo Quando una stringa è corrotta - il classico & quot; é si presenta come ín©& quot; mojibake - il modo più veloce per diagnosticarlo è guardare i byte Codifica la stringa spezzata rivela se i dati erano a doppia codifica, troncati a metà carattere o maciullati da un sistema che assumeva la codifica sbagliata Vedere i byte grezzi trasforma un vago & quot; i caratteri sono sbagliati" in una diagnosi specifica e fissabile.
Lavorare con formati e protocolli di basso livello
Un sacco di lavoro tecnico implica la lettura direttamente dei byte: pacchetti di rete, intestazioni di file, protocolli binari e sistemi embedded parlano tutti in esadecimale e binario. Essere in grado di trasformare rapidamente uno snippet di testo nella sua rappresentazione di byte o decodificare una stringa esadecimale acquisita in testo leggibile, salva il costante cambio di contesto. La vista esadecimale in particolare si allinea con ciò che mostrano gli editor e i debugger esadecimali.
Puzzle, CTF e messaggi nascosti
Binary e hex sono un punto fermo delle competizioni di cattura della bandiera, escape room e puzzle geek Una stringa di uno e zero è un modo comune per nascondere un breve messaggio, ed essere in grado di incollarlo e decodificarlo - in una qualsiasi delle quattro basi, con input continui o distanziati - rende breve il lavoro di questi I messaggi di errore chiari aiutano quando l'input del puzzle ha un errore di battitura o un separatore inaspettato.
Perché convertire nel browser anziché su un server?
la traduttore binario funziona interamente lato client Il testo che codifichi e le stringhe di byte che decodifichi non lasciano mai la tua macchina e lo strumento continua a funzionare con la tua connessione spenta una volta caricata la pagina Ciò conta più di quanto appaia per la prima volta: le stringhe che le persone convertono sono spesso token, identificatori interni, frammenti di dati utente o byte di protocollo acquisiti - esattamente il tipo di cosa che non dovresti incollare in un server casuale L'elaborazione in-browser significa che non c'è server in cui incollare Il Privacy dei dati negli strumenti online La guida sostiene più insistente per insistere su questo.
La conversione binaria si affianca anche a un gruppo di attività di codifica correlate. la Encoder/decoder Base64 Gestisce la codifica utilizzata per spostare binarie attraverso canali di solo testo come e-mail e URL di dati. la Encoder/decoder URL Copre la codifica percentuale per le stringhe di query. E il Generatore di hash Trasforma il testo in digeszioni a lunghezza fissa quando hai bisogno di un'impronta digitale anziché di una rappresentazione reversibile. Per il kit più ampio tengo aperto durante la costruzione, il Toolkit per sviluppatori web Roundup è un buon punto di partenza.
FAQ
Come faccio a convertire il testo in binario?
Apri il traduttore binario, scegli "testo in binario, mantieni la base impostata su binario e digita il testo. Ogni carattere è codificato nel valore del byte UTF-8 e mostrato come gruppi a 8 bit, quindi "A" diventa 01000001. L'output si aggiorna durante la digitazione e può essere copiato con un clic e puoi passare a esadecimale, decimale o ottale senza reinserire nulla.
Come faccio a convertire il binario in testo?
Seleziona "Binario a Testo" e incolla il tuo binario. Puoi separare i byte con spazi, virgole o interruzioni di riga o incollare una corsa continua di bit fintanto che la lunghezza totale è un multiplo di otto. Lo strumento raggruppa i bit in byte e li decodifica come UTF-8 per ricostruire i caratteri originali e segnala un errore se la lunghezza è errata o un carattere non è valido.
Quale codifica dei caratteri utilizza il traduttore binario?
Utilizza UTF-8, la codifica utilizzata dal moderno Web e dalla maggior parte dei linguaggi di programmazione. I caratteri ASCII prendono un byte, la maggior parte delle lettere accentate ne prendono due e molti script e tutte le emoji prendono tre o quattro byte. Ciò significa che lo strumento gestisce correttamente molto più dell'inglese semplice, a differenza di semplici strumenti che mappano solo i 128 caratteri ASCII.
Può convertirsi anche in esadecimale, decimale e ottale?
si. Un selettore di base commuta l'output tra binario, esadecimale, decimale e ottale e la decodifica accetta una di queste basi come input. L'esadecimale mostra due caratteri per byte, tre cifre ottali, decimale il valore normale da 0 a 255 e binario gli otto bit completi. Tutti e quattro rappresentano gli stessi byte sottostanti.
Perché non ha mai decodificato il mio binario?
I due motivi più comuni sono una lunghezza di bit che non è un multiplo di otto e caratteri vaganti che non sono validi per la base scelta Lo strumento ti dice esattamente quale token non è valido o che la lunghezza è sbagliata, quindi puoi risolverlo Anche una sequenza di byte che non è valida UTF-8 - ad esempio un carattere multi-byte che è stato tagliato - viene contrassegnata anziché decodificata in spazzatura.
Il traduttore binario supporta emoji e testo non inglese?
si. Poiché codifica attraverso UTF-8, i caratteri al di fuori dell'intervallo ASCII sono rappresentati come la sequenza corretta di due, tre o quattro byte e la decodifica riassembla nel carattere originale. Un emoji diventa quattro byte e andata e ritorno allo stesso emoji, e il testo latino cinese, arabo o accentato funziona allo stesso modo.
È sicuro convertire il testo sensibile qui?
si. Ogni conversione viene eseguita in JavaScript all'interno del browser, quindi nulla di cui si inserisce viene caricato, registrato o archiviato e lo strumento continua a funzionare senza connessione Internet una volta caricata. Puoi convertire in sicurezza token, identificatori interni o messaggi privati senza che escano il tuo dispositivo.
Qual è la differenza tra ASCII e UTF-8 in questo strumento?
ASCII è un set a 7 bit che copre 128 caratteri inglesi, mentre UTF-8 è una codifica a lunghezza variabile che include tutto ASCII più ogni altro carattere Unicode. Poiché UTF-8 è un superset di ASCII, il testo inglese produce esattamente i byte che una tabella ASCII prevede, mentre le lettere accentate, altri script ed emoji ottengono le sequenze multi-byte corrette che ASCII semplicemente non può rappresentare.


