Первый раз бинарный бит меня по-настоящему, это не в компьютер-наука класса - это было в производственной ошибке. плагин WordPress я поддерживаю хранил короткую строку таким образом, что исказил любой неанглийский символ, и чтобы выяснить, где произошло повреждение я должен был посмотреть на фактические байты. я вставил сломанную строку в "текст в бинарный " поле Я нашел в Интернете, получил обратно стену из единиц и нулей, и сразу понял, что инструмент только обработал символы ASCII и тихо уронил акцентированные. Байты, которые он показал мне, были ложью, и я потратил день на погоню за неправильным слоем стека.
Вот в чем дело двоичного преобразования: это выглядит как игрушка, и большинство бесплатных инструментов относятся к нему как к одному. Правильный переводчик должен кодировать весь спектр символов, которые люди на самом деле печатают - акценты, смайлики, китайский, арабский - через UTF-8, кодировка современной сети работает дальше, и ему приходится декодировать их обратно по байтам. Я строю Toolz.dev, плагин WP adminify, и изрядное количество laravel и react, поэтому я перемещаюсь между текстом и его байтовым представлением больше, чем хотелось бы, и я построил бинарный переводчик Чтобы сделать преобразование правильно для каждого персонажа, а не только Easy 128.
TL;DR: Бинарный переводчик превращает текст в единицы и нули, которые хранит компьютер, и превращает эти и нули обратно в текст. Захват — это кодировка символов: ASCII охватывает всего 128 символов, в то время как реальный текст нуждается в UTF-8, где один символ может содержать от одного до четырех байтов. выше бинарный переводчик кодирует и декодирует полную Юникод диапазон, включая смайлы, в двоичном, шестнадцатеричном, десятичном и восьмеричном формате полностью в вашем браузере и точно указывает, какой токен ошибается, когда вставка не может декодироваться.
Что такое бинарный переводчик, на самом деле?
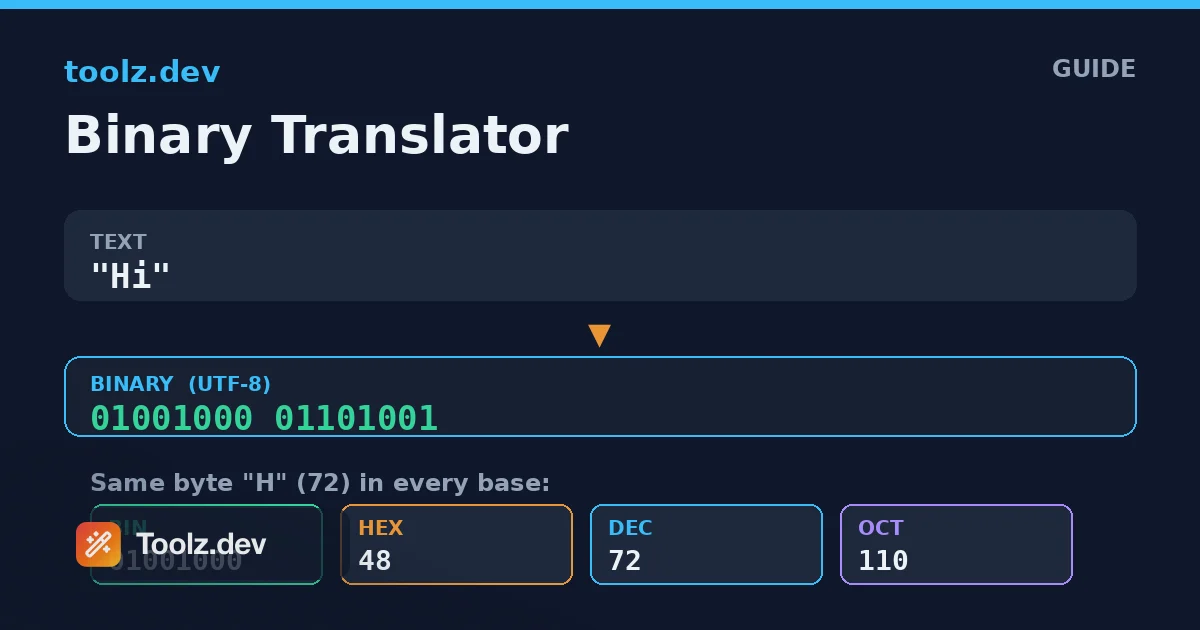
Двоичный переводчик - это преобразователь между читаемым человеком текстом и числовым представлением, которое компьютер использует для хранения этого текста. Каждый вводимый вами символ хранится в виде одного или нескольких байтов - чисел от 0 до 255 - и каждый байт может быть записан в двоичном (по основанию 2), шестнадцатеричном (по основанию 16), десятичном (по основанию 10) или восьмеричном (по основанию 8).Перевод & quot;Hi& quot; в двоичный дает 01001000 011010012 группы по восемь битов - это два байта для "h" и "i"
Слово & quot;перевести& quot; здесь делает реальную работу, потому что здесь задействована таблица перевода Значение байта 72 по своей сути не означает букву & quot;H & quot; - оно означает & quot;H & quot; только потому, что кодировка символов говорит так. Для основных английских букв, цифр и общей пунктуации, что отображение является ASCII, стандартом 1960-х годов, который присваивает значениям от 0 до 127 128 символов. ASCII - это почему & quot;H & quot; равно 72, а пробел равен 32, и это часть двоичного преобразования, которую все получают правильно.
Проблемы начинаются выше значения 127. мир набирает гораздо больше чем 128 различных символов, и кодировка, которая обрабатывает остальные - тот, который ваш браузер, ваша база данных, и ваш JSON почти наверняка используют - это UTF-8. хороший двоичный переводчик действительно кодек UTF-8 с базовым уровнем преобразования наверху бинарный переводчик Построен именно таким образом, поэтому он может обеспечите строку, содержащую смайлик, и вернуть вам идентичный символ.
Как на самом деле работает преобразование текста в двоичный файл?
Превращение текста в двоичный файл — это двухэтапный конвейер, и понимание этапов объясняет все, что делает инструмент. Первый этап Кодирование символов в байты, а второй есть Запись каждого байта в выбранной вами базе, йо-
Кодировка — это место, где живет UTF-8. UTF-8 — это кодировка переменной длины: символ принимает один байт, если он представляет собой простой символ ASCII, два байта для большинства букв с латинским акцентом и множество символов, три байта для большей части сценариев мира, включая китайский, японский и корейский, и четыре байта для менее распространенных символов и эмодзи. Так что "a" один байт, "е" - два, "я" - три, а фасад - четыре. Кодировщик проходит через строку, а для символов, выходящих за пределы основного диапазона, он создает правильную многобайтовую последовательность, в комплекте с ведущими битами, которые отмечают, сколько байтов следует за байтами.
Второй этап — чистая арифметика. После того, как у вас есть список байтов, запись их в двоичном формате означает, что каждое число от 0 до 255, равное 8 битам, с нулевой шириной, чтобы каждый байт был одинаковой шириной. Шестнадцатеричная запись каждого байта ровно как два символа (от 00 до FF), поэтому HEX является компактным избранным для просмотра необработанных данных. В Octal используется три цифры на байт, а десятичные числа просто показывают простое число. выше бинарный переводчик позволяет мгновенно переключаться между всеми четырьмя базами, поскольку базовые байты одинаковы - меняется только формат отображения.
Как переводчик декодирует двоичный файл обратно в текст?
Декодирование меняет конвейер и это направление, в котором большинство инструментов тихо терпят неудачу. Сначала инструмент должен Прочтите ввод в байтовые значения, то это должно Декодируйте эти байты как utf-8 обратно в символы, йо-
Чтение ввода означает токенизацию Если вы вставляете двоичный с пробелами между байтами, каждая группа - один байт Если вы вставляете один длинный непрерывный пробег битов, инструмент группирует их в восьмерки - что работает только в том случае, если общая длина кратна восьми, поэтому нечетная длина помечается, а не молча неправильно читается. та же логика применима к шестнадцатеричному: два символа на байт, поэтому нечетное количество шестнадцатеричных цифр является ошибкой. Запятые, пробелы, вкладки и разрывы строк работают как разделители, поэтому вы можете вставить любой формат, с которого вы скопировали, не переформатируя его сначала.
Второй этап перестраивает символы из байтов, и здесь имеет значение структура UTF-8's. Байт в диапазоне 0-127 является автономным символом. байт с определенным высокобитным шаблоном сигнализирует о начале последовательности из двух, трех или четырех байтов, и следующие байты должны иметь свой собственный шаблон продолжения. если они этого не делают - потому что байт отсутствует, или последовательность была обрезана, или данные никогда не были действительными UTF-8, чтобы начать с - бинарный переводчик Сообщает, что последовательность байтов не является допустимым текстом, а не излучает замещающие символы или мусор. В том, что честность в том, что когда декодирование не удается, вы хотите знать, что данные неверны, а не смотреть на Mojibake, задаваясь вопросом, сломался ли инструмент.
Двоичный, шестнадцатеричный, десятичный или восьмеричный - что мне использовать?
Все они представляют одинаковые байты, поэтому выбор заключается в том, кто читает и к чему они привыкли. Каждая база имеет нишу, где она естественная.
| база | цифры на байт | лучше для | Пример "H" (72) |
|---|---|---|---|
| бинарный (2) | 8 | Обучение, работа на уровне битов, показывающая точную структуру | 01001000 |
| Шестнадцатеричная (16) | 2 | Просмотр необработанных данных, отладки, цветных и байтовых дампов | 48 |
| десятичная (10) | 1–3 | Значения байтов, удобных для человека, краткая ссылка | 72 |
| Восьмеричный (8) | 3 | Разрешения на файлы Unix, некоторые устаревшие системы | 110 |
Бинарный является наиболее явным и лучшим для обучения, потому что вы можете видеть каждый бит, но он многословный - восемь символов на байт складывается быстро. Шестнадцатеричный - это то, что вы на самом деле будете использовать больше всего на практике: он компактен, он чисто отображается в байты по два символа каждый, и это формат шестнадцатеричные редакторы, дампы памяти и цветовые коды все говорят. Десятичный удобен, когда вы просто хотите знать символ и #39;s числовое значение. Octal - это удержание ниши, наиболее знакомое по битам разрешения Unix, как 755, и он здесь в основном, чтобы инструмент был завершен. выше бинарный переводчик Переключается между всеми четырьмя, не вводя ничего, чтобы вы могли сравнивать представления рядом.
Почему UTF-8 так много значит для двоичного преобразования?
Потому что & quot;text to binary& quot; бессмысленен, пока вы не решите, через какую кодировку вы конвертируете, а для современной сети этот ответ почти всегда UTF-8. Инструмент, который обрабатывает только ASCII, будет казаться работающим - он с радостью преобразует английский текст - а затем выдаст вас в тот момент, когда появятся реальные данные.
Рассмотрим акцентированное "é". В UTF-8 это два байта, 11000011 10101001, или c3 a9 в гексе. Инструмент, который рассматривает каждый символ как один байт ASCII, не может его представлять вообще; в лучшем случае он падает, в худшем — он производит один неверный байт. Теперь рассмотрим эмодзи, который составляет четыре байта в UTF-8. Наивные инструменты полностью искажают их. Потому что бинарный переводчик Настоящий кодек UTF-8, "Café" выдает правильные пять байтов, и вставляет эти пять байтов обратно "Café" ровно.
Это не академическое. Любой, кто прикасается к интернационализованному контенту, пользовательским данным или чем-то еще, что с эмодзи, сразу же попадет в многобайтовые символы. Если вы хотите более глубокий фон, Руководство по кодированию Base64 Покрывает то же мышление на уровне байтов для связанной кодировки, а понимание одного делает другой кликом. Краткая версия: байты универсальны, но сопоставление между байтами и символами — выбор, а UTF-8 — это выбор, который сделал веб-сайт.
Распространенные случаи использования, когда бинарный переводчик зарабатывает
Изучение и обучение тому, как компьютеры хранят текст
Наиболее распространенная причина, по которой люди ищут бинарный переводчик, — это понять концепцию. Ввод вашего имени и просмотр его становятся байтами, делает абстракция конкретной так, как лекция не может. Поскольку инструмент показывает точные восьмибитные группы и позволяет переключаться на шестнадцатеричные и десятичные, он удваивается как обучающее средство для того, как связаны кодирование и базы чисел. Студенты могут видеть, что «А» 65 лет, 01000001, и 41 в шестидесятилетнем возрасте.
Проблемы с кодированием отладки
Вот куда я тянусь к нему Когда строка повреждена - классический & quot;é отображается как é & quot; mojibake - самый быстрый способ диагностировать это - посмотреть на байты Кодировка сломанной строки показывает, были ли данные дважды закодированы, усечены в середине символа или искажены системой, которая приняла неправильное кодирование Видение необработанных байтов превращает расплывчатый & quot; символы неправильные & quot; в конкретный, фиксируемый диагноз.
Работа с низкоуровневыми форматами и протоколами
Много технической работы включает в себя непосредственное считывание байтов: сетевые пакеты, заголовки файлов, двоичные протоколы и встроенные системы — все это в шестнадцатеричном и двоичном формате. Возможность быстро превратить фрагмент текста в его байтовое представление или декодировать захваченную шестнадцатеричную строку обратно в читаемый текст, сохраняет постоянную коммутацию контекста. В частности, шестнадцатеричное представление совпадает с тем, что показывают редакторы и отладчики.
Головоломки, CTF и скрытые сообщения
Двоичный и шестнадцатеричный являются основным продуктом соревнований по захвату флага, квест-комнат и гиковских головоломок. Строка единиц и нулей - это распространенный способ скрыть короткое сообщение, а возможность вставить его и декодировать - в любой из четырех баз, с непрерывным или разнесенным вводом - делает их короткой работой. Четкие сообщения об ошибках помогают, когда вход головоломки имеет опечатку или неожиданный разделитель.
Зачем конвертировать в браузере, а не на сервере?
выше бинарный переводчик работает полностью на стороне клиента Текст, который вы кодируете, и строки байтов, которые вы декодируете, никогда не покидают вашу машину, и инструмент продолжает работать с вашим соединением после загрузки страницы. Это имеет большее значение, чем кажется на первый взгляд: строки, которые люди конвертируют, часто являются токенами, внутренними идентификаторами, фрагментами пользовательских данных или захваченными байтами протокола - именно то, что вы не должны вставлять в случайный сервер. обработка в браузере означает, что нет сервера, в который можно вставить.The Конфиденциальность данных в онлайн-инстру Руководство делает более полную аргументацию в том, чтобы настаивать на этом.
Двоичное преобразование также находится рядом с кластером связанных задач кодирования. выше Base64 кодировщик/декодер Обрабатывает кодировку, используемую для перемещения двоичного файла по текстовым каналам, таким как электронная почта и URL-адреса данных. выше кодер/декодер URL Покрывает кодирование процента для строк запроса. и тот хэш-генератор Превращает текст в дайджесты фиксированной длины, когда вам нужен отпечаток, а не обратимое представление. Для более широкого комплекта я держу открытой во время строительства, Набор инструментов для веб-разработчиков Своеобразие — хорошая отправная точка.
часто задаваемые вопросы
Как преобразовать текст в двоичный?
Откройте двоичный переводчик, выберите "текст в двоичный", сохраните базовый набор в двоичный файл и введите текст. Каждый символ закодирован в байтовом байте UTF-8 и отображается как 8-битные группы, поэтому «A» становится 01000001. Вывод обновляется по мере ввода и может быть скопирован одним щелчком мыши, и вы можете переключаться на HEX, DECIMAL или OUTAL, не вводя ничего.
Как преобразовать двоичный файл обратно в текст?
Выберите "Два бинарного в текст" и вставьте двоичный файл. Вы можете разделить байты пробелами, запятыми или разрывами строк или вставить один непрерывный запуск битов, если общая длина кратна восьми. Инструмент группирует биты в байты и декодирует их как UTF-8 для перестройки исходных символов, и сообщает об ошибке, если длина неверна или символ недействителен.
Какой кодирование символов использует бинарный переводчик?
В нем используется UTF-8, кодирование, используемое современными веб-сайтами и большинством языков программирования. Символы ASCII принимают один байт, большинство букв с акцентом — два, а многие скрипты и все смайлики — три или четыре байта. Это означает, что инструмент правильно обрабатывает гораздо больше, чем простой английский, в отличие от простых инструментов, которые сопоставляют только 128 символов ASCII.
Может ли он конвертироваться в шестнадцатеричную, десятичной и восьмеричной тоже?
да. Базовый селектор переключает выходные данные между двоичными, шестнадцатеричными, десятичными и восьмерными, а декодирование принимает любую из этих баз в качестве входных данных. Шестнадцатеричная показывает два символа на байт, восьмеричные три цифры, десятичную равнину от 0 до 255, и двоичное число полных восьми битов. Все четыре представляют одинаковые базовые байты.
Почему мой двоичный код не декодируется?
Две наиболее распространенные причины - это битовая длина, которая не кратна восьми, и блуждающие символы, которые не действительны для выбранной базы. инструмент точно сообщает вам, какой токен недействителен или что длина неверна, поэтому вы можете исправить это. Последовательность байтов, которая не является действительной UTF-8 - например, многобайтовый символ, который был отрезан - также помечается, а не декодируется в мусор.
Поддерживает ли бинарный переводчик смайлики и неанглийский текст?
да. Поскольку он кодируется через UTF-8, символы за пределами диапазона ASCII представлены как правильная последовательность двух, трех или четырех байтов, а декодирование повторно собирает их в исходный символ. Эмодзи становится четыре байта и обратно в один и тот же смайлик, а китайский, арабский или акцентированный текст на латинском языке работает точно так же.
Безопасно ли конвертировать здесь чувствительный текст?
да. Каждое преобразование выполняется в JavaScript внутри вашего браузера, поэтому ничего, что вы вводите, не загружается, регистрируется или сохраняется, а инструмент продолжает работать без подключения к Интернету после загрузки. Вы можете безопасно конвертировать токены, внутренние идентификаторы или личные сообщения, не покидая ваше устройство.
В чем разница между ASCII и UTF-8 в этом инструменте?
ASCII — это 7-битный набор, охватывающий 128 английских символов, а UTF-8 — кодирование переменной длины, которое включает в себя все ASCII плюс любой другой символ Unicode. Поскольку UTF-8 является надмножеством ASCII, английский текст создает именно те байты, которые таблица ASCII предсказывает, в то время как буквенные буквы, другие скрипты и эмодзи получают правильные многобайтовые последовательности, которые ASCII просто не может представлять.


