Das erste Mal, als Binärdatei mich real gebissen hat, war es nicht in einem Computer-Wissenschaftskurs - es war in einem Produktionsfehler Ein WordPress-Plugin, das ich betreue, speicherte eine kurze Zeichenfolge auf eine Weise, die jedes nicht-englische Zeichen verstümmelte, und um herauszufinden, wo die Korruption passiert war, musste ich mir die tatsächlichen Bytes ansehen. Ich fügte die gebrochene Zeichenfolge in ein & quot; Text zu binary" Box ein, die ich online fand, bekam eine Wand mit Einsen und Nullen zurück und erkannte sofort, dass das Tool nur die ASCII-Zeichen bearbeitet hatte und ließ die akzentuierten Zeichen leise fallen. Die Bytes, die es mir zeigte, waren eine Lüge, und ich wurde an einem Nachmittag lang, und ich wurde ich der falschen Schicht des Stapels hinterhergejagt.
Das ist die Sache mit der binären Konvertierung: Sie sieht aus wie ein Spielzeug, und die meisten kostenlosen Tools behandeln es wie eines Ein richtiger Übersetzer muss die gesamte Bandbreite an Zeichen kodieren, die Menschen tatsächlich eingeben - Akzente, Emoji, Chinesisch, Arabisch - bis UTF-8, die Kodierung des modernen Webs läuft weiter, und er muss sie Byte für Byte zurückdekodieren Ich baue Toolz.dev, das WP Adminify Plugin und eine ganze Menge Laravel und Reagieren, also bewege ich mich mehr zwischen Text und seiner Byte-Darstellung als ich möchte, und ich habe das gebaut Binärübersetzer Um die Konvertierung für jeden Charakter korrekt durchzuführen, nicht nur für die einfache 128.
tl; dr: Ein binärer Übersetzer verwandelt Text in Einsen und Nullen, die ein Computer speichert, und verwandelt diese Einsen und Nullen wieder in Text. Der Fang ist die Zeichenkodierung: ASCII deckt nur 128 Zeichen ab, während realer Text UTF-8 benötigt, wobei ein Zeichen ein bis vier Byte sein kann. der Binärübersetzer Kodiert und dekodiert das Ganze Unicode Bereich - einschließlich Emoji - in Binär-, Hex-, Dezimal- und Oktalbereich, vollständig in Ihrem Browser, und zeigt Ihnen genau an, welcher Token falsch ist, wenn eine Paste nicht dekodiert werden kann.
Was ist wirklich ein Binärübersetzer?
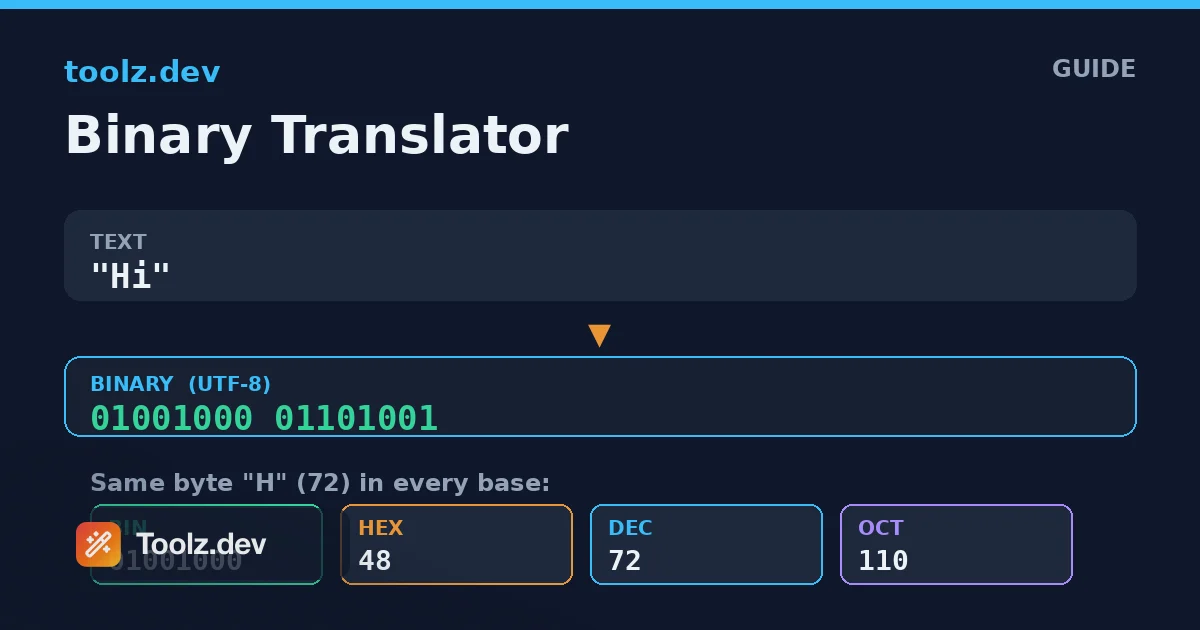
Ein Binärübersetzer ist ein Konverter zwischen für Menschen lesbarem Text und der numerischen Darstellung, die ein Computer zum Speichern dieses Textes verwendet Jedes von Ihnen eingegebene Zeichen wird als ein oder mehrere Bytes - Zahlen von 0 bis 255 - gespeichert und jedes Byte kann binär (Basis 2), hexadezimal (Basis 16), dezimal (Basis 10) oder oktal (Basis 8) geschrieben werden. Übersetzen von & quot; Hi" zu binär gibt 01001000 01101001; Die beiden Gruppen von acht Bits sind die zwei Bytes für "H" und "I".
Das Wort & quot; translate" leistet hier echte Arbeit, denn es handelt sich um eine Übersetzungstabelle Ein Bytewert von 72 bedeutet nicht per se den Buchstaben & quot; H" - es bedeutet " H" nur weil eine Zeichenkodierung dies sagt Für die grundlegenden englischen Buchstaben, Ziffern und die übliche Interpunktion ist diese Abbildung ASCII, ein Standard aus den 1960 er Jahren, der den Werten 0 bis 127 128 Zeichen zuweist. ASCII ist der Grund dafür, dass " 72 und ein Leerzeichen 32 ist, und es ist der Teil der Binärkonvertierung, die jeder bekommt.
Die Probleme beginnen oberhalb des Wertes 127. Die Welt gibt weit mehr als 128 verschiedene Zeichen ein, und die Kodierung, die den Rest verarbeitet - die, die Ihr Browser, Ihre Datenbank und Ihr JSON mit ziemlicher Sicherheit verwenden - ist UTF-8. Ein guter Binärübersetzer ist wirklich ein UTF-8-Codec mit einer Basis-Konvertierungsschicht obenauf Die Binärübersetzer Genau so gebaut, kann eine Zeichenfolge mit einem Emoji umlaufen und Ihnen das identische Zeichen zurückgeben.
Wie funktioniert das Konvertieren von Text in Binär?
Das Verwandeln von Text in Binär ist eine zweistufige Pipeline, und das Verstehen der Stufen erklärt alles, was das Tool tut. Die erste Phase ist Codierung der Zeichen in Bytes, und der zweite ist Schreiben Sie jedes Byte in die von Ihnen gewählte Basisdrohen
Bei der Codierung lebt UTF-8. UTF-8 ist eine Codierung mit variabler Länge: Ein Charakter nimmt ein Byte, wenn es sich um eine einfache ASCII-Zeichen handelt, zwei Bytes für die meisten Buchstaben mit lateinamerikanischer Akzent und viele Symbole, drei Bytes für den Großteil der Weltskripte, einschließlich Chinesisch, Japanisch und Koreanisch, und vier Bytes für weniger gängige Zeichen und Emoji. "A" ist also ein Byte, "é" ist zwei, "中" ist drei und ein Gesichts-Emoji ist vier. Der Encoder geht durch die Zeichenfolge und erzeugt für Zeichen außerhalb des Basisbereichs die richtige Multi-Byte-Sequenz mit den führenden Bits, die angeben, wie viele Bytes folgen.
Die zweite Stufe ist reine Arithmetik. Sobald Sie eine Liste von Bytewerten haben, bedeutet das Schreiben in binärer Bedeutung, jede Zahl von 0 bis 255 als acht Bit auszudrücken, nullgepolstert, sodass jedes Byte die gleiche Breite hat. Hexadezimal schreibt jedes Byte als genau zwei Zeichen (00 bis ff), weshalb Hex der kompakte Favorit für die Anzeige von Rohdaten ist. Octal verwendet drei Ziffern pro Byte, und Dezimalzahl zeigt nur die einfache Zahl. der Binärübersetzer Lassen Sie sofort zwischen allen vier Basen wechseln, da die zugrunde liegenden Bytes gleich sind - nur das Anzeigeformat ändert sich.
Wie dekodiert der Übersetzer die Binärdatei zurück in den Text?
Das Dekodieren kehrt die Pipeline um und es ist die Richtung, in der die meisten Werkzeuge leise ausfallen. Zuerst muss das Werkzeug Lesen Sie Ihre Eingabe in Byte-Werte, dann muss es Dekodieren Sie diese Bytes als UTF-8 wieder in Zeichendrohen
Das Lesen der Eingabe bedeutet Tokenisieren, Wenn Sie Binär mit Leerzeichen zwischen den Bytes einfügen, ist jede Gruppe ein Byte Wenn Sie einen langen kontinuierlichen Bitlauf einfügen, gruppiert das Tool sie in Achter - was nur funktioniert, wenn die Gesamtlänge ein Vielfaches von acht ist, also eine ungerade Länge markiert wird, anstatt stillschweigend falsch gelesen zu werden Die gleiche Logik gilt für Hex: zwei Zeichen pro Byte, also ist eine ungerade Anzahl von Hex-Ziffern ein Fehler Kommas, Leerzeichen, Tabulatoren und Zeilenumbrüche funktionieren alle als Trennzeichen, sodass Sie jedes Format einfügen können, von dem Sie kopiert haben, ohne es zuerst neu zu formatieren.
Die zweite Stufe baut Zeichen aus Bytes wieder auf, und hier kommt es auf die Struktur von UTF-8's an Ein Byte im Bereich 0-127 ist ein eigenständiges Zeichen Ein Byte mit einem bestimmten High-Bit-Muster signalisiert den Beginn einer Zwei, Drei - oder Vier-Byte-Sequenz, und die folgenden Bytes müssen ein eigenes Fortsetzungsmuster haben, wenn sie nicht - weil ein Byte fehlt, oder die Sequenz abgeschnitten wurde, oder die Daten von Anfang an nie gültig waren UTF-8 - die Binärübersetzer Berichtet, dass die Byte-Sequenz kein gültiger Text ist, anstatt Ersatzzeichen oder Müll auszusenden. Diese Ehrlichkeit ist der Punkt: Wenn eine Dekodierung fehlschlägt, möchten Sie wissen, dass die Daten falsch sind, und nicht auf Mojibake starren und sich fragen, ob das Werkzeug kaputt ist.
Binär, Hex, Dezimal oder Oktal - was sollte ich verwenden?
Sie alle repräsentieren die gleichen Bytes, also geht es bei der Wahl darum, wer liest und woran sie gewöhnt sind. Jede Basis hat eine Nische, in der sie die natürliche Passform ist.
| gründen | Ziffern pro Byte | am besten für | Beispiel für "H" (72) |
|---|---|---|---|
| binär (2) | 8 | Lernen, Bit-Level-Arbeit, genaue Struktur zeigen | 01001000 |
| Hexadezimal (16) | 2 | Anzeigen von Rohdaten, Debugging, Farb- und Byte-Dumps | 48 |
| Dezimal (10) | 1–3 | Menschenfreundliche Bytewerte, Schnellreferenz | 72 |
| Oktal (8) | 3 | Unix-Dateiberechtigungen, einige ältere Systeme | 110 |
Binär ist das explizitste und das beste für den Unterricht, denn man kann jedes Bit sehen, aber es ist ausführlich - acht Zeichen pro Byte summieren sich schnell Hexadezimal ist das, was Sie in der Praxis tatsächlich am meisten verwenden werden: Es ist kompakt, es bildet sich sauber auf Bytes mit jeweils zwei Zeichen ab, und es sprechen die Format-Hex-Editoren, Speicherausscheidungen und Farbcodes. Dezimal ist praktisch, wenn Sie nur einen Zeichen- und #39-Wert kennen möchten. Octal ist ein Nischenüberbleibsel, der vor allem aus Unix-Berechtigungsbits bekannt ist wie 755, und es ist hier hauptsächlich so, dass das Werkzeug vollständig ist. der Binärübersetzer Wechselt zwischen allen vier, ohne dass Sie etwas erneut eingeben, sodass Sie Darstellungen nebeneinander vergleichen können.
Warum ist UTF-8 für die binäre Konvertierung so wichtig?
Denn & quot; text to binary" ist bedeutungslos, bis Sie entscheiden, durch welche Kodierung Sie konvertieren, und für das moderne Web lautet diese Antwort fast immer UTF-8. Ein Tool, das nur ASCII verarbeitet, scheint zu funktionieren - es wird gerne englischen Text konvertieren - und Sie dann verraten, sobald reale Daten angezeigt werden.
Betrachten Sie das akzentuierte "é" ; In UTF-8 sind es zwei Bytes, 11000011 10101001, oder c3 a9 in Hex. Ein Werkzeug, das jeden Charakter als ein einzelnes ASCII-Byte behandelt, kann es überhaupt nicht darstellen, es lässt den Charakter bestenfalls fallen, im schlimmsten Fall erzeugt es ein falsches Byte. Betrachten Sie nun ein Emoji, das vier Bytes in UTF-8 ist. Naive Werkzeuge verwüsten diese vollständig. Weil der Binärübersetzer ist ein echter UTF-8-Codec, "Café" erzeugt die richtigen fünf Bytes und fügen diese fünf Bytes zurück "Café" genau.
Das ist nicht akademisch. Jeder, der internationalisierte Inhalte, vom Benutzer generierte Daten oder etwas mit einem Emoji berührt, trifft sofort auf Multi-Byte-Zeichen. Wenn Sie den tieferen Hintergrund wollen, Base64-Codierungshandbuch Deckt das gleiche Denken auf Byte-Ebene für eine verwandte Codierung ab, und das Verstehen eines Klicks zum anderen. Die Kurzversion: Bytes sind universell, aber die Zuordnung zwischen Bytes und Zeichen ist eine Wahl, und UTF-8 ist die Wahl, die das Web getroffen hat.
Häufige Anwendungsfälle, bei denen ein binärer Übersetzer seine Unterbrechung verdient
Lernen und Lehren, wie Computer Text speichern
Der häufigste Grund, warum Menschen nach einem binären Übersetzer suchen, ist das Verständnis des Konzepts. Wenn Sie Ihren Namen eingeben und ihn zu Bytes sehen, wird die Abstraktion auf eine Weise konkret, wie es eine Vorlesung nicht kann. Da das Tool die genauen Acht-Bit-Gruppen anzeigt und Sie zu Hex und Dezimal wechseln lässt, dient es als Lehrmittel für die Beziehungsverschlüsselung und Zahlenbasis. Die Schüler können sehen, dass "A" 65 ist, 01000001, und 41 In Hex auf einmal.
Debuggen von Codierungsproblemen
Hier greife ich danach Wenn eine Zeichenfolge beschädigt ist - die klassische & quot; e erscheint als -©" mojibake - die schnellste Methode, sie zu diagnostizieren, ist das Betrachten der Bytes. Durch die Kodierung der gebrochenen Zeichenfolge wird angezeigt, ob die Daten doppelt kodiert, in der Mitte des Zeichens abgeschnitten oder von einem System verstümmelt wurden, das die falsche Kodierung angenommen hat. Wenn man die Rohbytes sieht, wird ein vages & quot; Die Zeichen sind falsch" in eine bestimmte, feststellbare Diagnose umgewandelt.
Arbeiten mit Low-Level-Formaten und Protokollen
Viel technische Arbeit beinhaltet das direkte Lesen von Bytes: Netzwerkpakete, Datei-Header, Binärprotokolle und eingebettete Systeme sprechen alle in Hex und binär. Wenn Sie einen Textausschnitt schnell in seine Bytedarstellung verwandeln oder eine erfasste Hex-Zeichenfolge wieder in lesbaren Text dekodieren können, wird eine ständige Kontextumschaltung gespeichert. Insbesondere die Hex-Ansicht stimmt mit dem überein, was Hex-Editoren und Debugger zeigen.
Rätsel, CTFs und versteckte Nachrichten
Binär und Hex sind ein Grundnahrungsmittel von Capture-the-Flag-Wettbewerben, Escape Rooms und geekigen Rätseln. Eine Reihe von Einsen und Nullen ist eine gängige Möglichkeit, eine kurze Nachricht zu verbergen und sie einzufügen und zu dekodieren - in jeder der vier Basen, mit kontinuierlicher oder beabstandeter Eingabe - macht daraus kurze Arbeit. Die klaren Fehlermeldungen helfen, wenn die Puzzle-Eingabe einen Tippfehler oder einen unerwarteten Trenner hat.
Warum im Browser statt auf einem Server konvertieren?
der Binärübersetzer Läuft komplett clientseitig Der Text, den Sie kodieren und die Byte-Strings, die Sie dekodieren, verlassen Ihren Computer nie, und das Tool arbeitet weiter mit Ihrer Verbindung aus, sobald die Seite geladen wurde Das ist wichtiger, als es zuerst erscheint: Die Strings, die Menschen konvertieren, sind oft Token, interne Identifikatoren, Snippets von Benutzerdaten oder erfasste Protokollbytes - genau die Art von Dingen, die Sie nicht in einen zufälligen Server einfügen sollten In-Browser-Verarbeitung bedeutet, dass es keinen Server gibt, in den Sie einfügen können Die Datenschutz in Online-Tools Guide macht den vollen Fall, wenn er darauf besteht.
Die binäre Konvertierung befindet sich auch neben einem Cluster verwandter Codierungsaufgaben. der Base64-Encoder/Decoder Verarbeitet die Codierung, die zum Verschieben von Binärdateien verwendet wird, über Textkanäle wie E-Mail- und Daten-URLs. der URL-Encoder/Decoder Deckt die Prozent-Codierung für Abfragezeichenfolgen ab. und das Hash-Generator Verwandelt Text in Digests mit fester Länge, wenn Sie einen Fingerabdruck anstelle einer reversiblen Darstellung benötigen. Für das breitere Kit halte ich beim Bauen offen Webentwickler-Toolkit Roundup ist ein guter Ausgangspunkt.
FAQ
Wie konvertiere ich Text in Binär?
Öffnen Sie den Binärübersetzer, wählen Sie "Text zu Binär" aus, halten Sie die Basis auf binär und geben Sie Ihren Text ein. Jedes Zeichen wird auf seinen UTF-8-Byte-Wert codiert und als 8-Bit-Gruppen dargestellt, so dass "A" 01000001 wird. Die Ausgabe wird während der Eingabe aktualisiert und kann mit einem Klick kopiert werden. Sie können zu Hex, Dezimal oder Oktal wechseln, ohne erneut einzugeben.
Wie konvertiere ich binäre zurück in Text?
Wählen Sie "Binär zu Text" aus und fügen Sie Ihre Binärdatei ein. Sie können Bytes durch Leerzeichen, Kommas oder Zeilenumbrüche trennen oder einen kontinuierlichen Lauf von Bits einfügen, solange die Gesamtlänge ein Vielfaches von acht ist. Das Werkzeug gruppiert die Bits in Bytes und dekodiert sie als UTF-8, um die Originalzeichen neu zu erstellen, und es meldet einen Fehler, wenn die Länge falsch oder ein Zeichen nicht gültig ist.
Welche Zeichenkodierung verwendet der binäre Übersetzer?
Es verwendet UTF-8, die Codierung, die vom modernen Web und den meisten Programmiersprachen verwendet wird. ASCII-Zeichen nehmen ein Byte, die meisten Akzentbuchstaben nehmen zwei und viele Skripte und alle Emojis nehmen drei oder vier Bytes an. Dies bedeutet, dass das Werkzeug weit mehr als einfaches Englisch verarbeitet, im Gegensatz zu einfachen Tools, die nur die 128 ASCII-Zeichen zuordnen.
Kann es auch hexadezimal, dezimal und oktal umwandeln?
Ja. Ein Basis-Selektor schaltet die Ausgabe zwischen binär, hexadezimal, dezimal und oktal um, und die Dekodierung akzeptiert eine dieser Basen als Eingabe. Hexadezimal zeigt zwei Zeichen pro Byte, drei oktale drei Ziffern, dezimal den Wert von 0 bis 255 und binär die vollen acht Bits. Alle vier repräsentieren die gleichen zugrunde liegenden Bytes.
Warum wird meine binäre Dekodierung nicht?
Die beiden häufigsten Gründe sind eine Bitlänge, die kein Vielfaches von acht ist und Streufiguren, die für die gewählte Basis nicht gültig sind, das Tool sagt dir genau, welcher Token ungültig ist oder dass die Länge falsch ist, also kannst du ihn beheben Eine Bytefolge, die nicht gültig ist UTF-8 - zum Beispiel ein abgeschnittenes Multibyte-Zeichen - wird ebenfalls markiert, anstatt in Müll zu dekodieren.
Unterstützt der binäre Übersetzer Emoji und nicht-englische Texte?
Ja. Da es über UTF-8 codiert, werden Zeichen außerhalb des ASCII-Bereichs als die richtige Folge von zwei, drei oder vier Bytes dargestellt, und die Dekodierung setzt sie wieder in das ursprüngliche Zeichen zusammen. Ein Emoji wird zu vier Bytes und Hin- und Rückfahrten zurück zum gleichen Emoji, und chinesischer, arabischer oder akzentuierter lateinischer Text funktioniert genauso.
Ist es sicher, hier sensible Texte zu konvertieren?
Ja. Jede Konvertierung wird in Javascript in Ihrem Browser ausgeführt, sodass nichts, was Sie eingeben, hochgeladen, protokolliert oder gespeichert wird, und das Tool funktioniert nach dem Laden ohne Internetverbindung weiter. Sie können Token, interne Identifier oder private Nachrichten sicher konvertieren, ohne dass sie Ihr Gerät verlassen.
Was ist der Unterschied zwischen ASCII und UTF-8 in diesem Tool?
ASCII ist ein 7-Bit-Set mit 128 englischen Zeichen, während UTF-8 eine Codierung mit variabler Länge ist, die alle ASCII-Plus plus alle anderen Unicode-Zeichen enthält. Da UTF-8 eine ASCII-Obermenge ist, erzeugt englischer Text genau die Bytes, die eine ASCII-Tabelle vorhersagen würde, während Akzentbuchstaben, andere Skripte und Emoji die richtigen Multi-Byte-Sequenzen erhalten, die ASCII einfach nicht darstellen kann.


