User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
Che cos'è un generatore robots.txt?
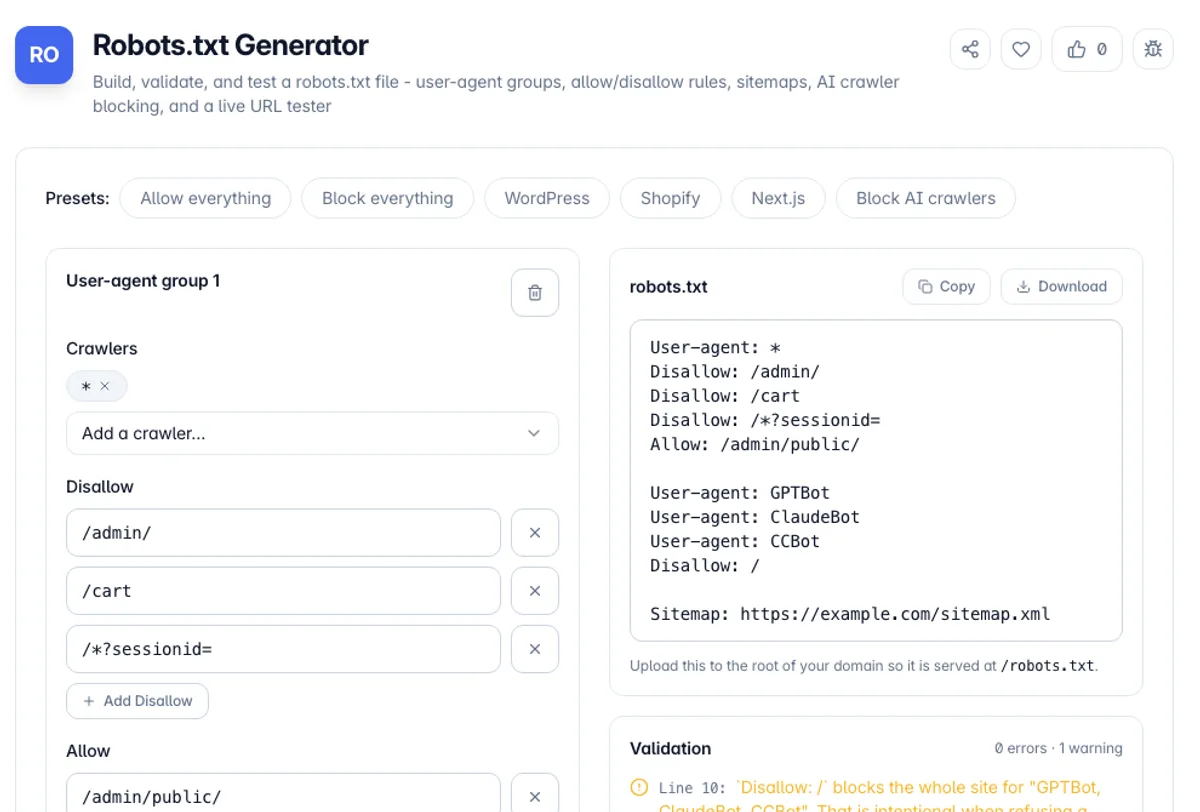
Un generatore robots.txt crea il file di testo in chiaro che si trova alla radice del tuo dominio e indica ai crawler quali parti del tuo sito possono recuperare. Il formato sembra semplice - una riga `user-agent:` seguita da regole `consenti:` e `disallow:` - ma i dettagli mordono: le regole si applicano solo all'interno di un gruppo, i percorsi devono iniziare con una barra, `*` e `$` comportarsi in modi specifici e un singolo `disallow: /` sotto `user-agent: *` può estrarre un intero sito da Google. Questo strumento crea il file da un modulo strutturato in modo che la sintassi sia corretta per costruzione.
Fa tre lavori oltre la generazione. Lancia il tuo file e segnala i veri pistole: regole che fluttuano al di fuori di qualsiasi gruppo, percorsi relativi, un 'non consentire:' che significa silenziosamente "consenti tutto", URL della mappa del sito che non siano assoluti, direttive sconosciute e blocchi di coperta. Analizza un robots.txt esistente in gruppi modificabili, in modo da poter incollare ciò che è live oggi e risolverlo. E mette alla prova un URL rispetto alle tue regole con la stessa precedenza che i crawlers di corrispondenza più lunga usano - il modello di corrispondenza più specifico vince e consente i battiti non consentiti sui pareggi - in modo da poter dimostrare che una pagina è raggiungibile prima di distribuire.
Una cosa che vale la pena affermare chiaramente: robots.txt controlla la scansione, non l'indicizzazione e non è un confine di sicurezza. Un URL bloccato può ancora apparire nei risultati di ricerca se altre pagine si collegano ad esso, perché Google può indicizzare un URL che non ha mai recuperato. Per mantenere una pagina fuori dall'indice è necessario un meta tag `noindex` o un'intestazione di tag x-robots - che il crawler può vedere solo se è consentito recuperare la pagina. E il file è pubblico: chiunque può leggere il tuo su /robots.txt, quindi elencare una directory segreta lo pubblicizza lì. Usa l'autenticazione per qualsiasi cosa privata.
Come utilizzare il generatore robots.txt?
Inizia da un preset o incolla il tuo file corrente
Scegli un preset - Consenti tutto, blocca tutto, WordPress, Shopify, Next.js o Blocca i crawler AI - per compilare il modulo in un clic o incolla il tuo Live Robots.txt e lascia che lo strumento lo ripartisca in gruppi modificabili.
Costruisci i tuoi gruppi di agenti utente
Aggiungi un gruppo per crawler o un set di crawler, scegliendo dall'elenco dei bot conosciuti o digitando un token. Assegna a ciascun gruppo il suo disabilita e consenti i percorsi e un ritardo di scansione se il motore che stai prendendo di mira ne onora uno.
Aggiungi le mappe del sito e leggi il validatore
Aggiungi uno o più URL della mappa del sito assoluti. Il validatore viene eseguito su ogni sequenza di tasti e segnala errori, avvisi e note con i numeri di riga: correggi qualsiasi cosa rossa prima della spedizione.
Testare un URL, quindi copiare o scaricare
Inserisci un percorso e un agente utente per vedere consentito o non consentito e esattamente quale regola l'ha deciso. Quando si comporta come ti aspetti, copia il file o scarica robots.txt e caricalo nella radice del tuo dominio.
Caratteristiche principali
Tester di URL più longevi
Verifica qualsiasi percorso contro qualsiasi agente utente che utilizza la precedenza RFC 9309 - il modello di corrispondenza più lungo vince, consente le interruzioni - e nomina la regola esatta che l'ha deciso
Validatore integrato
Cattura le regole al di fuori di un gruppo, percorsi relativi, linee di non allow vuote, URL della mappa del sito non assoluti, direttive sconosciute e un disabilitante generale: / che disinnegherebbe il tuo sito
Preset con un clic
Consenti tutto, blocca tutto, WordPress, Shopify, Next.js e Block AI Crawlers riempiono l'intero modulo con un punto di partenza sensato e corretto
Controlli del crawler AI
Blocca GptBot, Claudebot, PerplexityBot, CCBot, Google Extended, Bytespider e Anthropic-A in un click mantenendo i motori di ricerca benvenuti
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!