Er is geen standaard mapping tussen de twee. XML 1.0 heeft attributen, naamruimten, geordende gemengde inhoud en opmerkingen; RFC 8259 heeft zes soorten en geen attributen Elke converter vindt zijn eigen brug uit, daarom zijn twee van hen het daar niet mee eens.
De integratie die me leerde om XML-naar-JSON-conversie te respecteren, was een API van een vervoerder. Moderne rust overal elders in de stapel, en dan dit ene verouderde eindpunt dat zeep sprak en enveloppen retourneerde die ik moest inklappen in een JSON-pijplijn. "Het is gewoon XML voor JSON", dacht ik, en reikte naar een one-line converter. Toen kwamen de randgevallen aan: a <Package> Element dat soms een enkel object was en soms een lijst, afhankelijk van het aantal pakketten dat in de volgorde stond. een id Kenmerk dat mijn naïeve converter volledig is gevallen omdat er alleen naar elementtekst werd gekeken. a <Description> verpakt in CDATA omdat het een ampersand bevatte. Elk van deze beschadigde de gegevens stilletjes - de JSON kwam er plausibel uit en had het mis op manieren die slechts drie diensten stroomafwaarts vertoonden.
XML en JSON zien eruit alsof ze triviaal in elkaar moeten omzetten, en dat doen ze ook & #39; t, omdat ze gegevens modelleren met verschillende primitieven JSON heeft objecten, arrays, strings, getallen, booleans en null - een kleine, schone set XML heeft elementen, attributen, tekstknooppunten, gemengde inhoud, naamruimten, CDATA, opmerkingen en verwerkingsinstructies, en cruciaal is dat het dat ook heeft Geen arrays en Geen soorten. Dus een converter moet beslissingen nemen die een verliesloos formaat niet zou doen: waar gaan attributen heen als JSON er geen idee van heeft? Hoe vertel je een enkel element uit een lijst met één item wanneer XML beide op dezelfde manier markeert? Wat gebeurt er met een element dat zowel attributen als tekst heeft?
een XML naar JSON-converter dat maakt die beslissingen bewust - en consequent - is het verschil tussen een schone integratie en een week van downstream debuggen Die ik heb gebouwd voor Toolz.dev wijst attributen toe aan vooraf ingestelde sleutels zodat er niets verloren gaat, stort herhaalde tags in JSON-arrays zodat de structuur behouden blijft, houdt tekst met gemengde inhoud onder een speciale sleutel en leest CDATA woordelijk En het doet dit allemaal met een afhankelijkheid-vrije parser die in uw browser draait, wat belangrijk is omdat integratie-payloads precies het soort gegevens zijn dat u zou moeten doen 't uploaden naar een vreemde ' s server.
Deze gids behandelt hoe de conversie omgaat met de structurele eigenaardigheden van XML, wanneer herhaalde elementen arrays worden, hoe om te gaan met attributen en naamruimten, en de SOAP- en RSS-workflows waar deze conversie constant plaatsvindt.
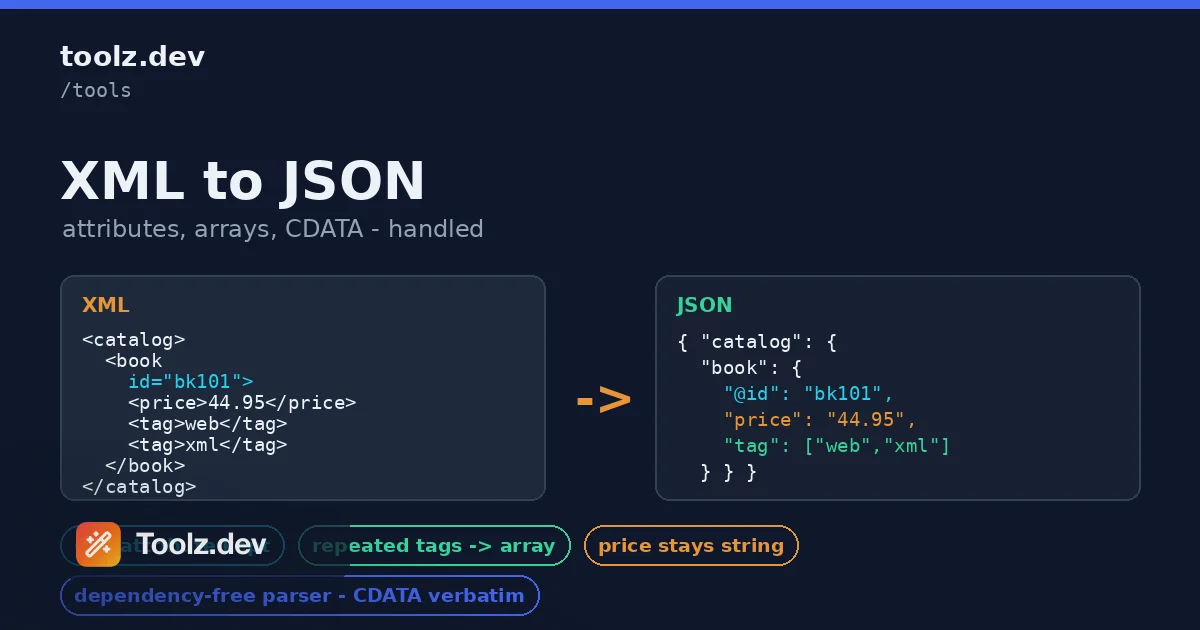
tl;dr: Plak XML in de Toolz.dev xml naar json-converter, kies inspringing en krijg schone json waar attributen worden
@-Voorgefixeerde sleutels, herhaalde tags worden arrays, tekst met gemengde inhoud zit onder#text, en cData wordt letterlijk gelezen. Optionele type parseren beurten"44.95"in een echt getal. Het maakt gebruik van een afhankelijkheidsvrije parser, draait 100% client-side, dus SOAP en integratie payloads uploaden nooit, en paren met json naar yaml en de JSON-formatter voor de volgende stap in uw pijplijn.
Waarom is niet XML voor JSON een eenvoudige één-op-één-mapping?
De intuïtie dat XML en JSON uitwisselbaar zijn, komt voort uit hun gedeelde taak - die gestructureerde gegevens vertegenwoordigt - en breekt op hun verschillende bouwstenen. De mismatch verschijnt op vier specifieke plaatsen, en een converter' De kwaliteit gaat volledig over hoe het ermee omgaat.
Attributen hebben geen JSON-equivalent. <book id="bk101">War and Peace</book> heeft een attribuut (id) en tekstinhoud (War and Peace). JSON heeft geen idee van een attribuut; alles is een sleutel-waardepaar. Een converter moet een conventie uitvinden, en de wijdverbreide conventie is het voorafvoegen van attribuutsleutels { "book": { "@id": "bk101", "#text": "War and Peace" } }. Laat de attributen vallen, zoals naïeve converters dat doen, en je bent stil gegevens kwijt.
JSON heeft arrays; XML niet. In XML is een lijst slechts dezelfde tag die herhaald wordt: drie <item> elementen onder één ouder. Maar een enkele <item> ziet er structureel identiek uit aan een lijst van één. JSON moet weten of hij een object of een array moet uitzenden, en het enige beschikbare signaal is voorkomen - dus herhaalde tags worden arrays en enkele tags blijven objecten.
gemengde inhoud. Een element kan zowel onderliggende elementen als losse tekst bevatten. JSON-objecten kunnen niet op natuurlijke wijze "dit object hebben ook een kale stringwaarde", dus de tekst gaat onder een gereserveerde sleutel zoals #text.
Typen bestaan niet in XML. Elke waarde in XML is tekst. <price>44.95</price> is de touwtje "44.95", geen getal, tenzij een converter ervoor kiest het te dwingen - en die keuze kan verkeerd zijn, omdat <zip>08544</zip> moet een string blijven of zijn voorloop nul verliezen.
de bekeerder Behandelt elk van deze expliciet in plaats van te doen alsof ze niet bestaan. Dat is de reden waarom de output trouw blijft aan de bron in plaats van stilletjes de delen van XML te laten vallen waar JSON geen slot voor heeft.
Wanneer worden herhaalde elementen arrays?
Dit is het meest verwarrende deel van XML-naar-JSON-conversie, en het is het begrijpen waard in plaats van verrast te worden. De regel de bekeerder Gebruikt op voorval: Als een bepaalde bovenliggende ouder, als een tagnaam meer dan eens verschijnt, de waarden samenvouwen tot een JSON-array; als deze precies één keer verschijnt, blijft deze een enkel object of een waarde.
dus <catalog> met twee <book> kinderen produceert { "catalog": { "book": [ {...}, {...} ] } } - een array. Maar een <catalog> met een <book> produceert { "catalog": { "book": {...} } } - een gewoon object, geen array.
Het gevolg om te plannen voor: Een lijst met één item lijkt niet op een lijst. Als uw downstream-code verwacht catalog.book om altijd een array te zijn en eroverheen te herhalen, zal een reactie van één boek het breken, omdat book zal een object zijn die bepaalde tijd Dit is & # 39; een bug in de conversie - it& # 39; is een onvermijdelijk gevolg van XML die geen lijsten markeert - maar het & # 39; is een echte gotcha in integraties waarbij het aantal items varieert Mijn ramp met de verzenddrager was precies dit: bestellingen met één pakket retourneerden een object waarbij bestellingen met meerdere pakketten een array retourneerden, en mijn code nam een array aan.
Het defensieve patroon in uw consumerende code is om te normaliseren: als een veld dat ook zou kunnen zijn, dwing het dan tot een array voordat u het itereert ([].concat(catalog.book)). schrander waarom De vorm varieert waardoor je die bewaker kunt schrijven in plaats van je erdoor te verbranden.
Hoe worden attributen en naamruimten afgehandeld?
Attributen converteren naar objectsleutels met een @ voorvoegsel. <user role="admin" active="true"> HALD { "user": { "@role": "admin", "@active": "true" } }. Het voorvoegsel houdt attributen visueel verschillend van onderliggende elementen en voorkomt een botsing waarbij een attribuut en een onderliggende element een naam delen. Als u don't überhaupt attributen nodig heeft - u wilt alleen de elementgegevens - de bekeerder Heeft een "negere attributen" optie die ze volledig laat vallen voor een schoner resultaat.
Naamspaties komen door als onderdeel van de tagnaam. <soap:Body> wordt een sleutel letterlijk met de naam "soap:Body", en xmlns:soap="..." is een attribuut zoals elke andere, landend onder @xmlns:soap. Dit is de pragmatische keuze: het volledig oplossen van naamruimten voor hun URI's zou onhandelbare sleutels opleveren en komt zelden overeen met wat integratiecode eigenlijk wil, namelijk aanpakken soap:Body door zijn bekende voorvoegsel. Als je SOAP of SVG of een andere naamwoordsvocabulaire verwerkt, zijn de voorvoegsels die je kent van de XML de sleutels die je in de JSON krijgt.
CDATA secties - de <![CDATA[ ... ]]> blokken waarmee XML onbewerkte tekst met speciale tekens kan bevatten - worden woordelijk gelezen, zonder entiteitsdecodering, wat precies hun doel is. A <script> of <description> Verpakt in CDATA om de ampersands en hoekbeugels te beschermen, komt door met die personages intact. Buiten CDATA, standaard entiteiten (<, &, en vrienden) en numerieke referenties (é, é) worden gedecodeerd tot hun eigenlijke karakters.
Hoe converteer je XML naar JSON met de tool?
Stap 1: Plak uw XML
Elke goed opgemaakte XML werkt - met of zonder de <?xml ?> Verklaring, met of zonder naamruimten. De declaratie-, doctype-, opmerkingen- en verwerkingsinstructies worden herkend en overgeslagen, zodat u een volledig document rechtstreeks uit een API-antwoord of een bestand kunt plakken. De knop Voorbeeld laden geeft u een catalogus met attributen, geneste elementen en een herhaalde tag, zodat u elk conversiegedrag tegelijk kunt zien.
Stap 2: Kies uw opties
Kies 2- of 4-space-inspringing voor de JSON. Bepaal of u attributen wilt opnemen of laat vallen. En kies of je typen wilt ontleden: laat het uit en elke waarde blijft een string (veilig, lossless); zet het aan en ondubbelzinnige nummers en booleans worden echte JSON-nummers en booleans. Uit is de juiste standaard wanneer waarden zoals postcodes of ID's voorloopnullen kunnen hebben die u moet behouden.
Stap 3: Converteren en beoordelen
De converter parseert eerst en rapporteert verkeerd opgemaakte markup - een niet-overeenkomende afsluitende tag, een niet-gesloten element, een niet-beëindigd CDATA-blok - met een specifiek bericht in plaats van afval te produceren JSON. Na succes verschijnt de JSON met regel- en bytetellingen. Schakel hem in om te bevestigen dat de array-vs-objectbeslissingen overeenkomen met uw verwachtingen.
Stap 4: Kopiëren of downloaden
Kopieer de JSON naar je klembord om in code te plakken, of download het als een .json bestand. Vanaf hier valt het in een verzoektekst, een gegevensopslag of de volgende fase van uw pijplijn. Als de volgende stap een configuratie-indeling is, wordt de JSON naar YAML-converter gaat verder.
Wat zijn de gemeenschappelijke workflows voor deze conversie?
Integreren van oude zeep-API's
SOAP is nog steeds overal in Enterprise, Banking, Logistics en Government Systems, en het spreekt exclusief XML. Wanneer een moderne JavaScript- of node-service een SOAP-respons moet gebruiken, is het converteren van de XML-envelop naar JSON stap één. De conversie betekent voor naamruimtebehouden soap:Body en soap:Envelope Houd hun bekende namen en de attribuutafhandeling behoudt de metadata die Soap graag aan elementen hangt. Dit is dezelfde categorie lijmwerk die in de API-foutopsporingsgids.
RSS- en atoomfeeds lezen
RSS- en Atom-feeds zijn XML, en het trekken ervan in een JavaScript-app betekent ze converteren. een feed <item> elementen zijn het geval met herhaalde tags uit het leerboek - ze worden een JSON-array van items, precies wat je wilt .map() over om een lijst weer te geven. Attributen zoals een behuizing url en type worden bewaard onder hun vooraf ingestelde sleutels, dus podcast- en mediafeeds houden hun audiolinks intact.
Config- en gegevensbestanden migreren
Oudere applicaties slaan configuratie en gegevens op in XML - denk .config Bestanden, sitemaps, geëxporteerde datasets, Office Open XML-fragmenten. Deze converteren naar JSON is de eerste zet bij het moderniseren van een systeem of het importeren van legacy-gegevens in een JSON-native store. De optie Typeparsing is hier handig wanneer u herkennen De numerieke velden zijn echt numeriek en willen dat ze in de bestemming worden getypt.
Testen en prototyping
Wanneer u ' een gegevensstroom aan het bedraden bent en alleen de vorm van een XML-payload als JSON hoeft te zien - om een TypeScript-interface te ontwerpen, om een antwoord te bespotten, om een veldpad te controleren - een snelle conversie in de browser verslaat het schrijven van wegwerpparsercode Converteer, lees de structuur, schrijf uw typen ertegen.
XML en JSON: Wanneer past elk formaat?
| XML | Json | |
|---|---|---|
| Primair tijdperk & ecosysteem | Enterprise, zeep, documenten | Web-Apis, JavaScript, Config |
| kenmerken | prima | Geen - toegewezen aan vooraf ingestelde toetsen |
| invallen | Geen - herhaalde tags impliceren lijsten | prima |
| gierogen | Alle tekst | Strings, getallen, booleans, null |
| nadere beschouwing | ondersteund | niet in de specificaties |
| Naamruimten | prima | Geen - bewaard als voorvoegsel sleutelnamen |
| wijdlopigheid | Hoger - tags sluiten, attributen | Onder - beugels en beugels |
| natuurlijke habitat | SOAP, RSS/Atoom, Office-indelingen, Config | REST API's, front-end gegevens, package.json |
Het patroon achter de tabel: XML is gebouwd voor documenten en bedrijfsuitwisseling waarbij structuur, validatie en zelfbeschrijving van belang zijn; JSON is gebouwd voor het web waar lichtheid en een directe kaart naar JavaScript-objecten ertoe doen De conversierichting is overwegend XML-naar-JSON, omdat de beweging in de industrie plaatsvindt van oudere op XML gebaseerde systemen naar JSON-native front-ends en services - you' het ontmoeten van oudere gegevens waar deze zich bevinden en het in een moderne pijplijn brengen De bredere set formattools voor die pijplijn bevindt zich in de Handleiding voor coderingshulpmiddelen.
Is het veilig om XML te converteren die gevoelige gegevens bevat?
Integratiepaadloads zijn vol met dingen die u niet wilt lekken: SOAP-reacties met klantrecords, configuratiebestanden met interne eindpunten en inloggegevens, gegevensexport met persoonlijke informatie. En dit zijn precies wat wordt geplakt in online converters, meestal halverwege de integratie, meestal haast.
de Toolz.dev-converter parseert en converteert volledig in uw browser met een afhankelijkheidsvrije parser - nee DOMParser, geen serveroproep, geen gegevens die de pagina verlaten. Verbreek uw netwerk nadat de pagina is geladen en het werkt nog steeds. Dat is een architectonisch feit over hoe de tool is gebouwd, geen belofte in een beleidsdocument, en het is het browser-eerste principe achter de hele gereedschapskist, gedetailleerd in de Gids voor gegevensprivacy.
Het standaard voorbehoud is van toepassing: client-side conversie beschermt de conversiestap Wat je daarna met de JSON doet - waar je het plakt, waar je het naartoe stuurt - is een aparte beslissing Maar de transformatie zelf houdt je XML op je machine.
FAQ
Hoe converteer ik XML naar JSON Online?
Plak je XML in de XML naar JSON Converter en klik op Converteren De tool parseert de XML, converteert deze naar JSON met de door jou gekozen inspringing en opties, en laat je het resultaat kopiëren of downloaden De verwerking is 100% in-browser - er wordt niets geüpload.
Hoe worden XML-attributen weergegeven in de JSON-uitvoer?
Attributen worden objectsleutels die vooraf zijn gefixeerd, dus een boekelement met id="bk101" converteert naar een "@id" Dit houdt attributen onderscheiden van onderliggende elementen. U kunt de attribuutuitvoer volledig uitschakelen met de optie Negeren-kenmerken als u alleen de elementgegevens nodig heeft.
Waarom worden sommige XML-elementen arrays en blijven andere objecten?
JSON kan niet markeren dat een element kan worden herhaalt, dus de converter gebruikt gebeurtenis: als een tag meer dan eens onder dezelfde bovenliggende bovenliggende staat, wordt het een array en als deze verschijnt zodra deze een enkel object blijft. Dit weerspiegelt de bron getrouw, hoewel het betekent dat een lijst met één item eruitziet als een enkel object in plaats van een array.
Behandelt de converter CDATA-secties en XML-entiteiten?
Ja. CData-blokken worden letterlijk gelezen zonder entiteitsdecodering, wat hun doel is. Buiten CDATA worden de standaard entiteiten zoals <, >, &, ", en ' en numerieke karakterreferenties zoals &é en &é worden gedecodeerd in hun eigenlijke karakters.
Kan ik een SOAP-respons of RSS-feed converteren naar JSON?
Ja. SOAP-enveloppen en RSS- of Atom-feeds zijn gewone XML, dus ze converteren net als elk ander document. Tags met naamspatie behouden hun voorvoegsel in de sleutelnaam - soap: Body wordt een " soap:Body" sleutel - en herhaalde elementen zoals RSS-items worden een JSON-array die u kunt in kaart brengen.
Blijven nummers en booleans na conversie als tekst?
Standaard ja, omdat XML geen typesysteem heeft en waarden zoals "007" of "1.10" kunnen zinvol zijn als tekst. Schakel de optie Typeparsing in om ondubbelzinnige numerieke en Booleaanse tekst om te zetten in echte JSON-nummers en booleans wanneer dat is wat u wilt.
Is het veilig om XML te converteren die gevoelige gegevens bevat?
Ja. de parser draait volledig in JavaScript in uw browser - geen enkel netwerkverzoek draagt uw gegevens, niets wordt gelogd of opgeslagen en de tool werkt offline XML met klantrecords, interne identificatiegegevens of integratiegeheimen verlaat uw machine nooit.
Wat is het verschil tussen XML en JSON?
XML is een opmaaktaal met het openen en sluiten van tags, attributen, naamruimten en opmerkingen, ontworpen voor documenten en bedrijfsgegevensuitwisseling. JSON is een lichter formaat dat is opgebouwd uit objecten, arrays en primitieve waarden, en is de standaard voor moderne web-API's. Het converteren van XML naar JSON is gebruikelijk bij het integreren van oudere SOAP- of feedgebaseerde systemen met JavaScript-frontends.
XML en JSON zien er uitwisselbaar uit en aren' t, omdat JSON geen attributen, geen arrays-voor-herhaling en geen tekst-naast-kinderen heeft - de exacte plaatsen waar een naïeve conversie geruisloos gegevens verliest Een converter die deze zaken met opzet afhandelt, geeft je JSON that's trouw aan de bron: Plak je XML, controleer hoe het de attributen en herhaalde tags in kaart bracht, en breng schone gegevens in uw pijplijn in plaats van een plausibel ogende corruptie.


