A primeira vez que o binário me mordeu de verdade, não foi em uma aula de ciência da computação - foi em um bug de produção Um plugin WordPress que EU mantenho foi armazenar uma string curta de uma forma que mutilou qualquer caractere não-Inglês, e para descobrir onde a corrupção aconteceu EU tive que olhar para os bytes reais Eu colei a string quebrada em um & quot; texto para binário" caixa que encontrei on-line, recuperei uma parede de uns e zeros, e imediatamente percebi que a ferramenta só tinha lidado com os caracteres ASCII e silenciosamente larguei os acentuados Os bytes que me mostrou eram uma mentira, e perdi uma tarde perseguindo a camada errada da pilha.
Essa é a coisa sobre a conversão binária: parece um brinquedo, e a maioria das ferramentas gratuitas tratá-lo como um Um tradutor adequado tem que codificar toda a gama de caracteres que as pessoas realmente digitam - acentos, emoji, chinês, árabe - através UTF-8, a codificação da web moderna é executado sobre, e ele tem que decodificá-los de volta byte-para-byte Eu construir Toolz.dev, o plugin WP Adminify e uma boa quantidade de Laravel e React, então eu me movo entre o texto e sua representação de bytes mais do que gostaria, e construí o tradutor binário Para fazer a conversão corretamente para cada personagem, não apenas para o Easy 128.
tl;dr: Um tradutor binário transforma texto em um e zera um computador armazenado em um computador, e transforma esses e zeros em texto. O problema é codificação de caracteres: ASCII cobre apenas 128 caracteres, enquanto o texto real precisa de UTF-8, onde um personagem pode ter um a quatro bytes. o tradutor binário codifica e decodifica o completo Unicode intervalo - incluindo emoji - em binário, hexadecimal, decimal e octal, inteiramente no seu navegador, e informa exatamente qual token está errado quando uma pasta não consegue decodificar.
O que é um tradutor binário, realmente?
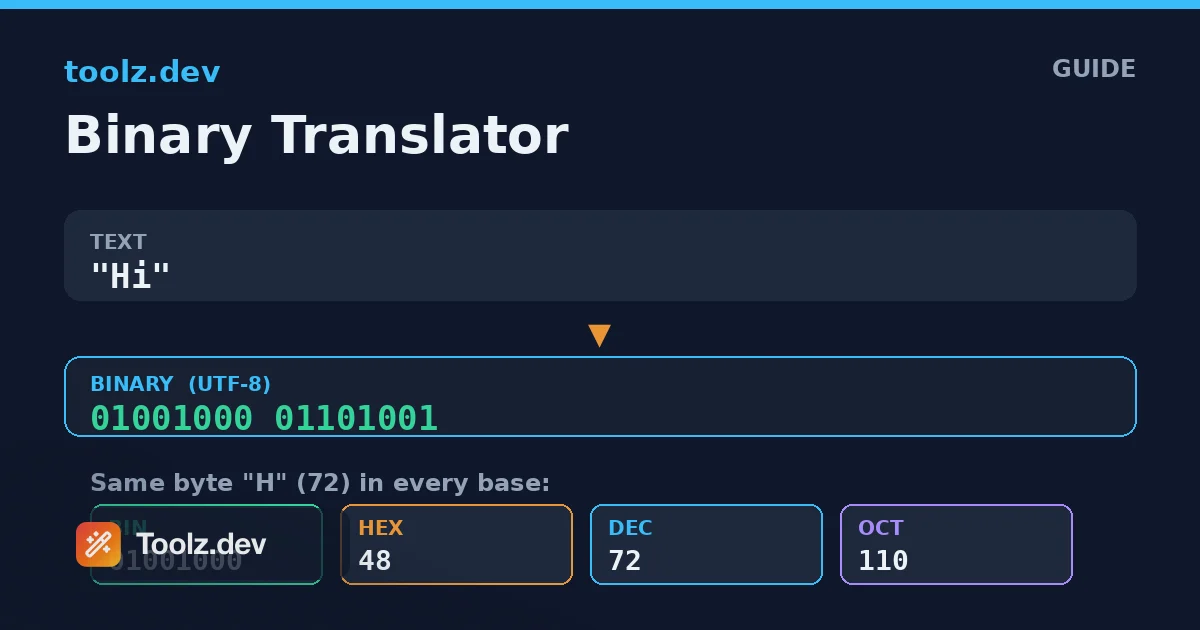
Um tradutor binário é um conversor entre texto legível por humanos e a representação numérica que um computador usa para armazenar esse texto Cada caractere que você digita é armazenado como um ou mais bytes - números de 0 a 255 - e cada byte pode ser escrito em binário (base 2), hexadecimal (base 16), decimal (base 10) ou octal (base 8).Traduzindo " Hi" para binário dá 01001000 01101001; Os dois grupos de oito bits são os dois bytes para "h" e "i".
A palavra & quot; translate" está a fazer um trabalho real aqui, porque há uma tabela de tradução envolvida Um valor de byte de 72 não significa inerentemente a letra & quot; H & quot; - significa & quot; H & quot; apenas porque uma codificação de caracteres diz que Para as letras, dígitos e pontuação comum em inglês básicos, esse mapeamento é ASCII, um padrão da década de 1960 que atribui 128 caracteres aos valores de 0 a 127. ASCII é o motivo pelo qual o & quot; H & quot; é 72 e um espaço é 32, e é a parte da conversão binária que todos acertam.
Os problemas começam acima do valor 127. o mundo digita muito mais de 128 caracteres distintos, e a codificação que lida com o resto - aquele que seu navegador, seu banco de dados e seu JSON quase certamente usam - é UTF-8. um bom tradutor binário é realmente um codec UTF-8 com uma camada de conversão de base no topo tradutor binário É construído exatamente dessa maneira, e é por isso que ele pode fazer uma viagem de ida e volta com um emoji e devolvê-lo com o mesmo caráter.
Como a conversão de texto em binário realmente funciona?
Transformar texto em binário é um pipeline de dois estágios, e entender os estágios explica tudo o que a ferramenta faz. A primeira etapa é Codificando os caracteres em bytes, e o segundo é Escrevendo cada byte na base escolhida.
A codificação é onde mora o UTF-8. UTF-8 é uma codificação de comprimento variável: um personagem leva um byte se for um caractere ASCII simples, dois bytes para a maioria das letras com detalhes em latim e muitos símbolos, três bytes para a maior parte dos scripts do mundo, incluindo chinês, japonês e coreano e quatro bytes para menos caracteres comuns e emoji. Então, "a" é um byte, "é" é dois, "é três, e um emoji de rosto é quatro. O codificador percorre a string e, para personagens fora do intervalo básico, ele produz a sequência de bytes correta, completa com os bits principais que marcam quantos bytes seguem.
A segunda etapa é pura aritmética. Depois de ter uma lista de valores de bytes, escrevê-los em binário significa expressar cada número de 0 a 255 como oito bits, com preenchimento zero para que cada byte tenha a mesma largura. Hexadecimal grava cada byte exatamente como dois caracteres (00 a FF), e é por isso que o HEX é o favorito compacto para visualizar dados brutos. Octal usa três dígitos por byte, e Decimal apenas mostra o número simples. o tradutor binário permite alternar entre todas as quatro bases instantaneamente porque os bytes subjacentes são iguais - apenas o formato de exibição muda.
Como o tradutor decodifica o binário de volta ao texto?
A decodificação reverte o pipeline e é a direção em que a maioria das ferramentas falha silenciosamente. Primeiro a ferramenta deve Leia sua entrada em valores de byte, então tem que Decodifique esses bytes como UTF-8 de volta em personagens.
Ler a entrada significa tokenizar Se você colar binário com espaços entre os bytes, cada grupo é um byte Se você colar uma longa execução contínua de bits, a ferramenta os agrupa em oitos - o que só funciona se o comprimento total for um múltiplo de oito, então um comprimento ímpar é sinalizado em vez de silenciosamente mal lido A mesma lógica se aplica ao hex: dois caracteres por byte, então um número ímpar de dígitos hexadecimais é um erro As vírgulas, espaços, abas e quebras de linha funcionam todas como separadores, para que você possa colar qualquer formato que tenha copiado sem reformatá-lo primeiro.
O segundo estágio reconstrói caracteres a partir de bytes, e é aqui que a estrutura UTF-8 & #39; s importa Um byte no intervalo 0-127 é um caractere autônomo Um byte com um padrão específico de alto bit sinaliza o início de uma sequência de dois, três ou quatro bytes, e os bytes que se seguem devem ter seu próprio padrão de continuação Se não o fizerem - porque um byte está faltando, ou a sequência foi cortada, ou os dados nunca foram válidos UTF-8 para começar - o tradutor binário Relata que a seqüência de bytes não é um texto válido em vez de emiter caracteres de substituição ou lixo. Essa honestidade é o ponto: quando uma decodificação falha, você quer saber que os dados estão errados, não olhar para Mojibake se perguntando se a ferramenta quebrou.
Binário, hexadecimal, decimal ou octal - o que devo usar?
Todos eles representam os mesmos bytes, então a escolha é sobre quem está lendo e com o que eles estão acostumados. Cada base tem um nicho onde é o ajuste natural.
| base | dígitos por byte | melhor para | Exemplo para "h" (72) |
|---|---|---|---|
| binário (2) | 8 | Aprendizagem, trabalho em nível de bits, mostrando a estrutura exata | 01001000 |
| hexadecimal (16) | 2 | Visualizando dados brutos, depuração, cor e byte dumps | 48 |
| Decimal (10) | 1–3 | Valores de byte amigável para humanos, referência rápida | 72 |
| octal (8) | 3 | Permissões de arquivo UNIX, alguns sistemas legados | 110 |
Binário é o mais explícito e o melhor para ensinar, porque você pode ver cada bit, mas é prolixo - oito caracteres por byte soma rápido Hexadecimal é o que você realmente vai usar mais na prática: é compacto, mapeia de forma limpa para bytes em dois caracteres cada, e é o formato hex editores, despejos de memória, e códigos de cores todos falam Decimal é útil quando você só quer saber um personagem' s numérico valor Octal é um nicho remanescente, mais familiar a partir de bits de permissão Unix como 755, e está aqui principalmente para que a ferramenta esteja completa. o tradutor binário Alternou entre todos os quatro sem você entrar novamente em nada, para que você possa comparar as representações lado a lado.
Por que o UTF-8 é tão importante para a conversão binária?
Porque o & quot; text para binary" não tem sentido até que decida por que codificação está a converter, e para a Web moderna essa resposta é quase sempre UTF-8 Uma ferramenta que apenas lida com ASCII parecerá funcionar - irá converter o texto em inglês alegremente - e depois traí-lo-á no momento em que os dados do mundo real aparecerem.
Considere o "é" acentuado. No UTF-8, são dois bytes, 11000011 10101001, ou c3 a9 em hex. Uma ferramenta que trata cada personagem como um único byte ASCII não pode representá-lo; na melhor das hipóteses, ele deixa cair o personagem, na pior das hipóteses, produz um byte errado. Agora considere um emoji, que é de quatro bytes no UTF-8. Ferramentas ingênuas mutilam-se completamente. Porque o tradutor binário É um codec UTF-8 real, "Café" produz os cinco bytes corretos e colando esses cinco bytes de volta, "café" exatamente.
Isso não é acadêmico. Qualquer pessoa que toque em conteúdo internacionalizado, dados gerados pelo usuário ou qualquer coisa com um emoji atingirá caracteres de vários bytes imediatamente. Se você deseja o fundo mais profundo, o Guia de codificação de base64 Abrange o mesmo pensamento em nível de byte para uma codificação relacionada, e entender um faz o outro clique. A versão curta: os bytes são universais, mas o mapeamento entre bytes e personagens é uma escolha, e UTF-8 é a escolha feita pela web.
Casos de uso comuns em que um tradutor binário ganha seu suporte
Aprendendo e ensinando como os computadores armazenam texto
A razão mais comum pela qual as pessoas procuram um tradutor binário é entender o conceito. Digitar seu nome e vê-lo se tornar bytes torna a abstração concreta de uma forma que uma palestra não pode. Como a ferramenta mostra os grupos exatos de oito bits e permite que você mude para hexadecimal e decimal, ela funciona como um auxiliar de ensino para como a codificação e as bases dos números se relacionam. Os alunos podem ver que "a" é 65, 01000001, e 41 Em hexagonal tudo de uma vez.
Problemas de codificação de depuração
É aqui que EU o alcance Quando uma cadeia de caracteres é corrompida - o clássico & quot; é aparece como é & quot; mojibake - a maneira mais rápida de diagnosticá - lo é olhar para os bytes A codificação da cadeia de caracteres quebrada revela se os dados foram codificados em dobro, com caracteres médios truncados ou mutilados por um sistema que assumiu a codificação errada Ver os bytes brutos transforma um & quot; os caracteres estão errados & quot; num diagnóstico específico e fixável.
Trabalhando com formatos e protocolos de baixo nível
Muitos trabalhos técnicos envolvem a leitura direta de bytes: pacotes de rede, cabeçalhos de arquivos, protocolos binários e sistemas embarcados falam em hexadecimal e binário. Ser capaz de transformar rapidamente um trecho de texto em sua representação de bytes ou decodificar uma string hexagonal capturada de volta em texto legível, economizando constantes trocas de contexto. A visualização hexadecimal em particular se alinha com o que os editores hexadecimais e depuradores mostram.
Quebra-cabeças, CTFs e mensagens ocultas
Binário e hex são um grampo de competições de captura de bandeira, salas de fuga e quebra-cabeças geeks Uma sequência de uns e zeros é uma maneira comum de esconder uma mensagem curta, e ser capaz de colá-la e decodificá-la - em qualquer uma das quatro bases, com entrada contínua ou espaçada - faz um trabalho curto destes As mensagens de erro claras ajudam quando a entrada do quebra-cabeça tem um erro de digitação ou um separador inesperado.
Por que converter no navegador em vez de em um servidor?
o tradutor binário corre inteiramente do lado do cliente O texto que você codifica e as cadeias de bytes que você decodifica nunca saem da sua máquina, e a ferramenta continua trabalhando com sua conexão desligada depois que a página é carregada Isso importa mais do que parece à primeira vista: as cadeias de caracteres que as pessoas convertem são frequentemente tokens, identificadores internos, trechos de dados do usuário ou bytes de protocolo capturados - exatamente o tipo de coisa que você não deve colar em um servidor aleatório O processamento no navegador significa que não há servidor para colar Privacidade de dados em ferramentas online Guia é o caso mais completo para insistir nisso.
A conversão binária também se encaixa em um conjunto de tarefas de codificação relacionadas. o Codificador/decodificador Base64 Lida com a codificação usada para mover o binário por meio de canais somente de texto, como e-mail e URLs de dados. o Codificador/decodificador de URL Abrange a codificação por cento para strings de consulta. e o gerador de haxixe Transforma o texto em resumos de comprimento fixo quando você precisa de uma impressão digital em vez de uma representação reversível. Para o kit mais amplo que mantenho aberto durante a construção, o Kit de ferramentas para desenvolvedores web Roundup é um bom ponto de partida.
FAQ
Como faço para converter texto em binário?
Abra o tradutor binário, escolha "Texto para binário", mantenha a base definida como binário e digite seu texto. Cada caractere é codificado para o valor de byte UTF-8 e mostrado como grupos de 8 bits, então "a" se torna 01000001. A saída é atualizada conforme você digita e pode ser copiado com um clique, e você pode mudar para hexadecimal, decimal ou octal sem entrar novamente em nada.
Como faço para converter o binário de volta em texto?
Selecione "Binary to Text" e cole seu binário. Você pode separar bytes com espaços, vírgulas ou quebras de linha ou colar uma execução contínua de bits, desde que o comprimento total seja múltiplo de oito. A ferramenta agrupa os bits em bytes e os decodifica como UTF-8 para reconstruir os caracteres originais e relata um erro se o comprimento estiver errado ou se um caractere não for válido.
Qual codificação de caractere o tradutor binário usa?
Ele usa UTF-8, a codificação usada pela web moderna e pela maioria das linguagens de programação. Os personagens ASCII levam um byte, a maioria das letras acentuadas leva dois, e muitos scripts e todos os emojis levam três ou quatro bytes. Isso significa que a ferramenta lida corretamente com muito mais do que o inglês simples, ao contrário de ferramentas simples que mapeiam apenas os 128 caracteres ASCII.
Pode converter em hexadecimal, decimal e octal também?
Sim. Um seletor de bases alterna a saída entre binário, hexadecimal, decimal e octal, e a decodificação aceita qualquer uma dessas bases como entrada. Hexadecimal mostra dois caracteres por byte, três dígitos octais, decimal o valor simples de 0 a 255 e binário os oito bits completos. Todos os quatro representam os mesmos bytes subjacentes.
Por que não decodificará meu binário?
As duas razões mais comuns são um comprimento de bit que não é um múltiplo de oito e caracteres perdidos que não são válidos para a base escolhida A ferramenta diz exatamente qual token é inválido ou que o comprimento está errado, então você pode corrigi-lo Uma sequência de bytes que não é válida UTF-8 - por exemplo, um caractere de vários bytes que foi cortado - também é sinalizada em vez de decodificada em lixo.
O tradutor binário suporta emoji e texto não inglês?
Sim. Por codificar por UTF-8, os personagens fora do intervalo ASCII são representados como a sequência correta de dois, três ou quatro bytes, e a decodificação os remonta no caractere original. Um emoji se torna quatro bytes e viagens de ida e volta ao mesmo emoji, e o texto chinês, árabe ou latino com sotaque funciona da mesma maneira.
É seguro converter textos sensíveis aqui?
Sim. Cada conversão é executada em JavaScript dentro do seu navegador, para que nada que você insira seja carregado, registrado ou armazenado, e a ferramenta continua funcionando sem conexão com a Internet após a carregada. Você pode converter tokens com segurança, identificadores internos ou mensagens privadas sem que eles saiam do dispositivo.
Qual é a diferença entre ASCII e UTF-8 nesta ferramenta?
ASCII é um conjunto de 7 bits que cobre 128 caracteres em inglês, enquanto UTF-8 é uma codificação de comprimento variável que inclui todos os ASCII mais todos os outros caracteres Unicode. Como o UTF-8 é um superconjunto de ASCII, o texto em inglês produz exatamente os bytes que uma tabela ASCII prediz, enquanto as letras acentuadas, outros scripts e o emoji obtêm as sequências de multi-bytes corretas que o ASCII simplesmente não pode representar.


