User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
O que é um gerador de robôs.txt?
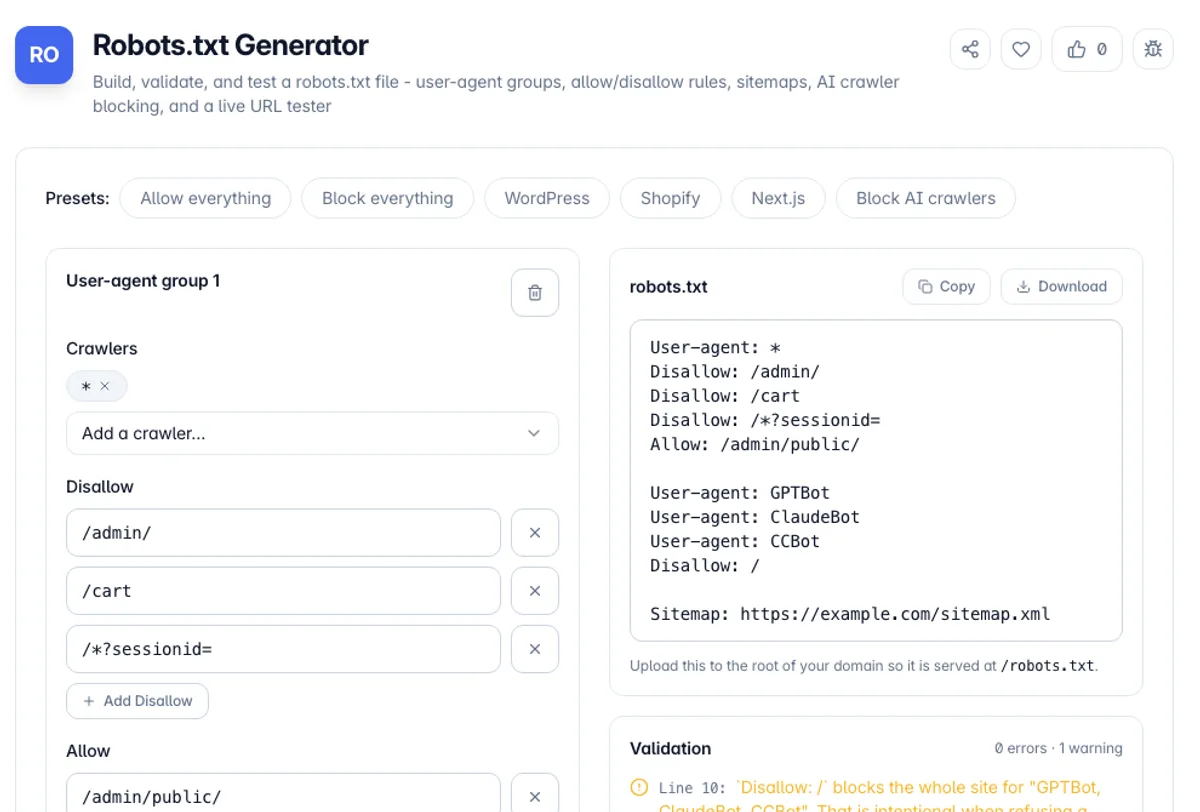
Um gerador de robôs.txt cria o arquivo de texto simples que fica na raiz do seu domínio e informa aos rastreadores quais partes do seu site podem buscar. O formato parece simples - uma linha `user-agent:` seguida por `permitir:` e `disallow:` regras - mas as regras de detalhes se aplicam apenas dentro de um grupo, os caminhos devem começar com uma barra, `*` e `$` se comportam de maneiras específicas e uma única dispersão `disallow: /` em `user-agent: *` pode puxar um site inteiro fora do google. Esta ferramenta cria o arquivo a partir de um formulário estruturado, de modo que a sintaxe é correta por construção.
Ele faz três trabalhos além da geração. Ele clareia seu arquivo e sinaliza as armas reais: regras que flutuam fora de qualquer grupo, caminhos relativos, um 'disallow:` que silenciosamente significa "permitir tudo", URLs de mapa do site que não são diretivas desconhecidas absolutas e blocos de cobertor. Ele analisa um robots.txt existente de volta em grupos editáveis, para que você possa colar o que está ao vivo hoje e corrigi-lo. E testa uma URL em relação às suas regras com a mesma precedência de correspondência mais longa que os rastreadores reais usam - o padrão de correspondência mais específico vence e permite que as batidas desautorizem em gravatas - para que você possa provar que uma página pode ser acessada antes de implantar.
Uma coisa que vale a pena afirmar claramente: o Robots.txt controla o rastreamento, não a indexação, e não é um limite de segurança. Um URL bloqueado ainda pode aparecer nos resultados da pesquisa se outras páginas se conectarem a ele, porque o Google pode indexar um URL que nunca foi buscado. Para manter uma página fora do índice, você precisa de uma metatag `noindex` ou de um cabeçalho X-robots-tag - que o rastreador só pode ver se é permitido buscar a página. E o arquivo é público: qualquer pessoa pode ler o seu em /robots.txt, então, anuncie um diretório secreto aí o anuncia. Use a autenticação para qualquer coisa privada.
Como usar o gerador Robots.txt?
Comece a partir de uma predefinição ou cole seu arquivo atual
Escolha uma predefinição - permitir tudo, bloquear tudo, WordPress, Shopify, Next.js ou Block AI Crawlers - para preencher o formulário com um clique ou cole seu robots ao vivo.txt e deixe a ferramenta analisá-lo de volta em grupos editáveis.
Crie seus grupos de agente de usuário
Adicione um grupo por rastreador ou conjunto de rastreadores, escolhendo na lista de bot conhecido ou digitando um token. Dê a cada grupo sua proibição e permita caminhos e um atraso de rastreamento, se o mecanismo que você está mirando em honras um.
Adicione mapas de sites e leia o validador
Adicione um ou mais URLs absolutos de mapa do site. O validador é executado em cada pressionamento de tecla e relata erros, avisos e notas com números de linha - conserte qualquer coisa vermelha antes de enviar.
Teste um URL e, em seguida, copie ou baixe
Insira um caminho e um agente do usuário para ver permitido ou não permitido e exatamente qual regra decidiu. Quando ele se comportar da maneira que você espera, copie o arquivo ou baixe o robots.txt e faça o upload para o seu domínio raiz.
Principais características
Tester de URL de correspondência mais longa real
Testa qualquer caminho contra qualquer agente do usuário usando o RFC 9309 Precedence - o padrão de correspondência mais longo vence, permite quebras de laços - e nomeia a regra exata que a decidiu
Validador integrado
Regras de um grupo, caminhos relativos, linhas de desativação vazias, URLs de mapa de site não absolutos, diretivas desconhecidas e um cobertor não permitem: / Isso desindexará seu site
Predefinições de um clique
Permitir tudo, bloquear tudo, WordPress, Shopify, Next.js e bloquear os rastreadores de IA preenchendo todo o formulário com um ponto de partida sensato e correto
Controles de rastreador de IA
Bloqueie GPTBot, Claudebot, PerplexityBot, CCBot, Google-Extended, Bytespider e Anthropic-AI em um clique, mantendo os mecanismos de pesquisa totalmente bem-vindos
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!