User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
Что такое генератор robots.txt?
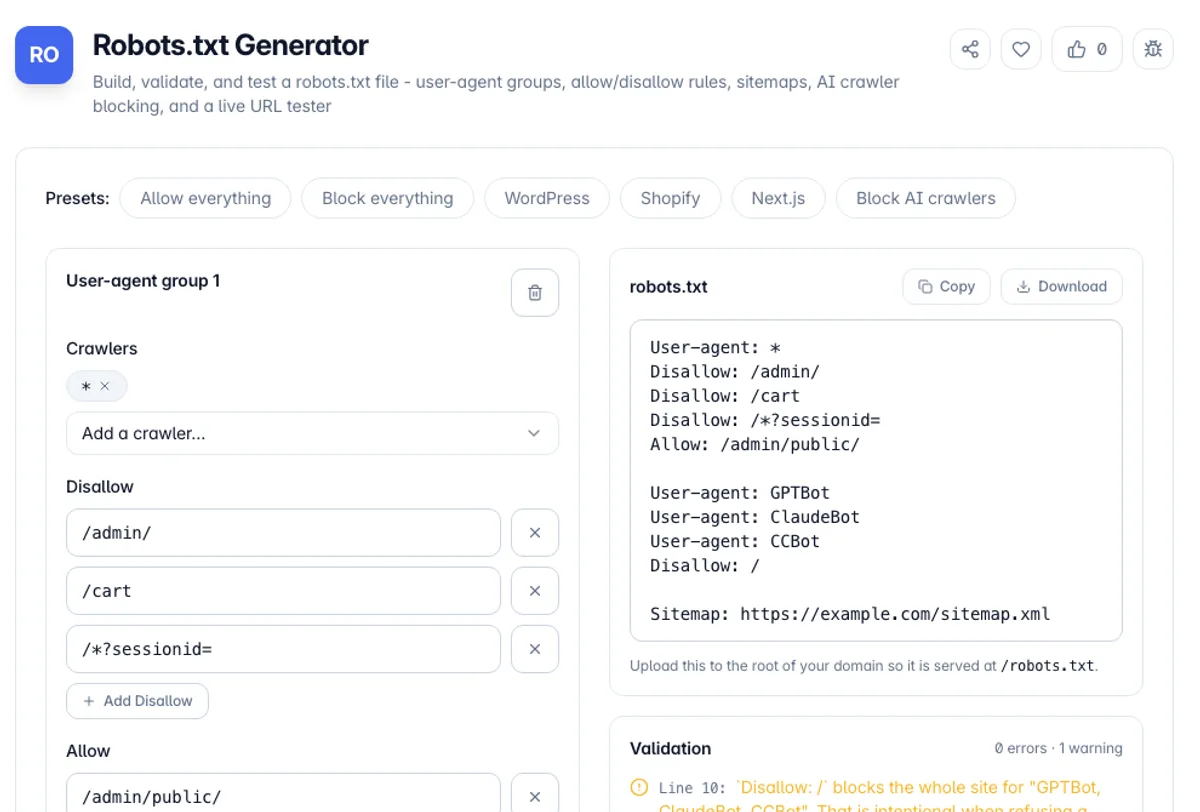
Генератор robots.txt создает файл с простым текстом, который находится в корне вашего домена и сообщает сквознякам, какие части вашего сайта они могут забрать. Формат выглядит просто - `user-agent:` строка, за которой следуют `разрешить:` и `resallow:` Правила - но детали прикус: правила применяются только внутри группы, пути должны начинаться с косой, `*` и `$` вести себя определенным образом, а один бродячий `запрет: /` под `user-agent: *` может вытащить весь сайт из Google. Этот инструмент создает файл из структурированной формы, поэтому синтаксис корректен по конструкции.
Он выполняет три работы помимо поколения. Он заклинит ваш файл и помечает настоящие пешие стрелки: правила, плавающие вне любой группы, относительные пути, голое «запретить»: «Всё разрешить», «Потребить все», URL-адреса карты сайта, которые не являются абсолютными, неизвестные директивы и одеяло блоков. Он анализирует существующий robots.txt обратно в редактируемые группы, поэтому вы можете вставлять то, что есть сегодня, и исправить это. И он проверяет URL-адрес по вашим правилам с тем же самым длинным приоритетом, который использует реальные сканеры - наиболее конкретные выигрывают выигрыши и позволяют битамм запретить для галстуков - чтобы вы могли доказать, что страница доступна до развертывания.
Стоит прямо сказать: robots.txt управляет сканированием, а не индексацией, и это не граница безопасности. Заблокированный URL-адрес по-прежнему может отображаться в результатах поиска, если на него ссылаются другие страницы, потому что Google может индексировать URL-адрес, который он никогда не извлекал. Чтобы сохранить страницу из индекса, вам нужен метатег `noindex` или заголовок x-robots-tag, который искаженный поиск может видеть только, разрешено ли она извлекать страницу. И файл общедоступен: любой может прочитать ваш на /robots.txt, поэтому выписывать там секретный каталог рекламирует его. Используйте аутентификацию для всего, что приватно.
Как использовать генератор robots.txt?
Начните с пресета или вставьте текущий файл
Выберите предустановку - разрешите все, WordPress, Shopify, Next.js или блокируйте поисковые системы AI - заполнить форму в один клик или вставить Live Robots.txt и позволить инструменту снова разобрать ее в редактируемые группы.
Создайте свои группы агентов
Добавьте группу для каждого искателя или набора искателей, выбирая из списка известных ботов или вводя токен. Дайте каждой группе запретить и разрешить пути, а также задержку сканирования, если движок, на который вы нацеливался, имеет право.
Добавить карты сайта и прочитать валидатор
Добавьте один или несколько абсолютных URL-адресов карты сайта. Валидатор работает на каждом нажатии клавиш и сообщает об ошибках, предупреждениях и заметках с номерами строк — исправьте что-нибудь красное перед отправкой.
Протестируйте URL-адрес, затем скопируйте или скачайте
Введите путь и пользователь-агент, чтобы увидеть разрешенное или запрещенное и точное правило, какое это правило решило. Когда он ведет себя так, как вы ожидаете, скопируйте файл или загрузите robots.txt и загрузите его в корень домена.
Основные характеристики
Реальный тестер URL с самым длинным соответствием
Проверяет любой путь против любого пользовательского агента, используя приоритет RFC 9309 - самый длинный шаблон выигрывает, разрешает разрывы - и называет точное правило, которое решило его
Встроенный валидатор
Выявляет правила за пределами группы, относительные пути, пустые строки запрета, неабсолютные URL-адреса карты сайта, неизвестные директивы и полное запрет: / это бы обезвредило ваш сайт
Предустановки одним щелчком мыши
Разрешить все, заблокировать все, WordPress, Shopify, Next.js и блокировать ИИ-установщики, каждый заполняйте всю форму разумной, правильной начальной точкой.
Управление гусеничным ИИ
Блокировать GPTBot, ClaudeBot, PerplexityBot, CCBOT, Google-расширение, ByTespider и Anthropic-AI в один клик, сохраняя при этом поисковые системы, полностью приветствуя поисковые системы
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!