User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
Was ist ein robots.txt-Generator?
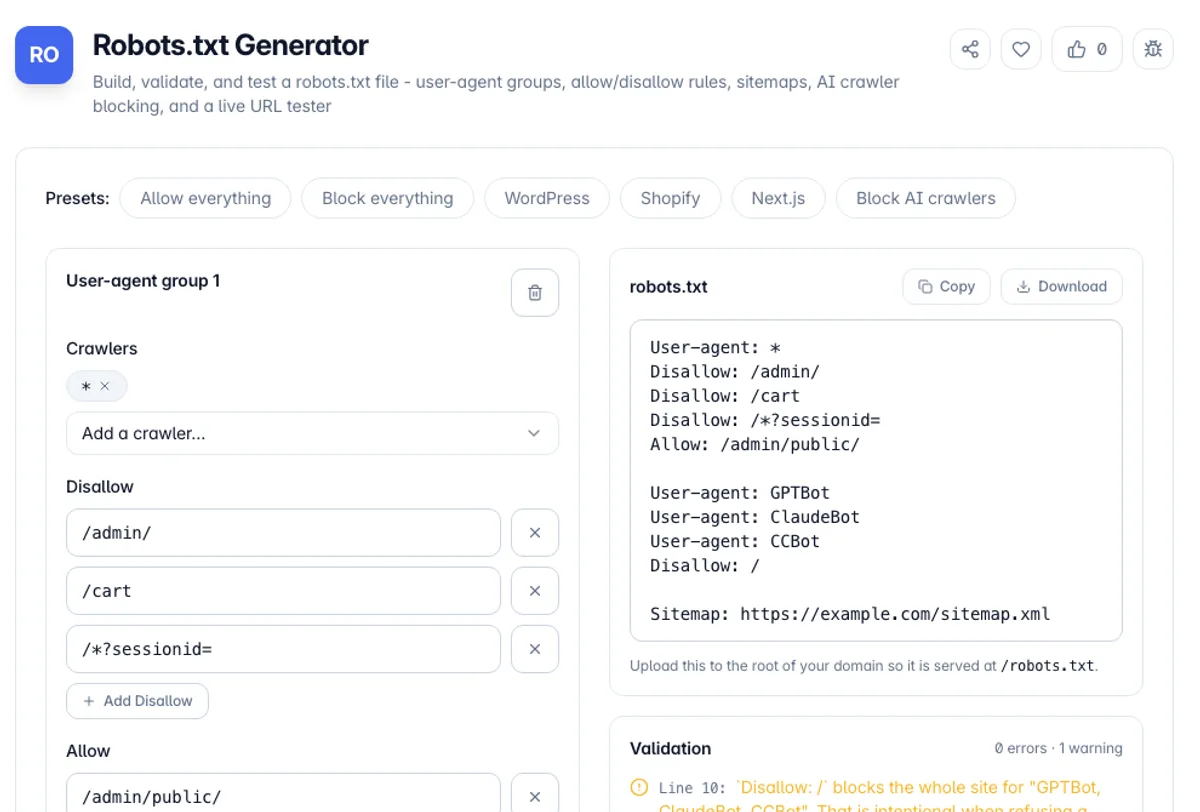
Ein Robots.txt-Generator erstellt die Klartextdatei, die sich an der Wurzel Ihrer Domain befindet und den Crawlern mitteilt, welche Teile Ihrer Website sie abrufen können. Das Format sieht einfach aus - eine "Benutzeragentur:" Linie, gefolgt von "Zulassen:" und "Disallow:" -Regeln - aber die Details beißen: Regeln gelten nur innerhalb einer Gruppe, Pfade müssen mit einem Schrägstrich beginnen, "*" und "$" verhalten sich auf bestimmte Weise, und ein einzelner Streuner: / ` Unter "Benutzeragent: *" kann eine ganze Seite aus Google herausziehen. Dieses Tool erstellt die Datei aus einer strukturierten Form, sodass die Syntax durch Konstruktion korrekt ist.
Es erledigt drei Jobs über die Generation hinaus. Es fließt Ihre Datei und markiert die echten Fußwaffen: Regeln, die außerhalb einer Gruppe schweben, relative Pfade, ein bloßes "Disallow:" bedeutet "alles zulassen", Sitemap-URLs, die nicht absolut sind, unbekannte Direktiven und Blöcke. Es analysiert eine vorhandene robots.txt in bearbeitbare Gruppen, sodass Sie das, was heute live ist, einfügen und beheben. Und es testet eine URL gegen Ihre Regeln mit der gleichen Verwendung von echten Crawlern mit der höchsten Übereinstimmung - das spezifischste übereinstimmende Muster gewinnt und lässt Beats bei den Bindungen nicht zu. Damit können Sie beweisen, dass eine Seite vor der Bereitstellung erreichbar ist.
Eine Sache, die es wert ist, klar zu sagen: robots.txt steuert das Kriechfahren, nicht das Indexieren, und es ist keine Sicherheitsgrenze. Eine blockierte URL kann in den Suchergebnissen weiterhin angezeigt werden, wenn andere Seiten darauf verlinken, da Google eine URL indizieren kann, die er noch nie abgerufen hat. Um eine Seite aus dem Index herauszuhalten, benötigen Sie ein `noindex` Meta-Tag oder einen X-Robots-Tag-Header - der nur der Crawler sehen kann, wenn er die Seite abrufen darf. Und die Datei ist öffentlich: Jeder kann Ihre unter /robots.txt lesen, also werben Sie dort ein geheimes Verzeichnis an. Verwenden Sie die Authentifizierung für alles private.
Wie benutzt man den robots.txt-Generator?
Beginnen Sie mit einer Voreinstellung oder fügen Sie Ihre aktuelle Datei ein
Wählen Sie eine Voreinstellung - alles zulassen, alles blockieren, WordPress, Shopify, Next.js oder Block AI Crawler -, um das Formular mit einem Klick auszufüllen oder fügen Sie Ihre Live Robots.txt ein und lassen Sie es vom Tool zurück in bearbeitbare Gruppen parsen.
Erstellen Sie Ihre Benutzeragentengruppen
Fügen Sie eine Gruppe pro Crawler oder eine Gruppe von Crawlern hinzu, wählen Sie aus der bekannten Bot-Liste oder geben Sie einen Token ein. Geben Sie jeder Gruppe ihre Verbots- und Erlaubnispfade und eine Kriechverzögerung, wenn der Motor, den Sie anvisieren, eine Ehre erweist.
Fügen Sie Sitemaps hinzu und lesen Sie den Validator
Fügen Sie eine oder mehrere absolute Sitemap-URLs hinzu. Der Validator läuft auf jedem Tastendruck und meldet Fehler, Warnungen und Notizen mit Zeilennummern - korrigieren Sie alles, was Sie vor dem Versand rot haben.
Testen Sie eine URL und kopieren oder laden Sie sie herunter
Geben Sie einen Pfad und einen Benutzeragenten ein, um zulässig oder nicht zulässig zu sehen und welche Regel es genau entschieden hat. Wenn es sich so verhält, wie Sie es erwarten, kopieren Sie die Datei oder laden Sie sie herunter.
Hauptmerkmale
Echt am längsten übereinstimmender URL-Tester
Testet jeden Pfad gegen jeden Benutzer-Agent mit der Vorrangigkeit von RFC 9309 - das längste übereinstimmende Muster gewinnt, lässt sich brechen - und benennt die genaue Regel, die es entschieden hat
Eingebauter Validator
Fängt Regeln außerhalb einer Gruppe, relative Pfade, leere Zeilen, nicht zulassen, nicht absolute Sitemap-URLs, unbekannte Direktiven und eine pauschale Nichtzulassen: / Das würde Ihre Website deindexen
Ein-Klick-Voreinstellungen
Alles zulassen, alles blockieren, WordPress, Shopify, Next.js und Block-AI-Crawler füllen das gesamte Formular mit einem vernünftigen, korrekten Startpunkt aus
AI-Crawler-Steuerelemente
Blockieren Sie GPTBot, Claudebot, PerplexityBot, CCbot, Google-Extended, ByteSpider und Anthropic-AI mit einem Klick, während Suchmaschinen vollständig willkommen sind
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!