User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
¿Qué es un generador de robots.txt?
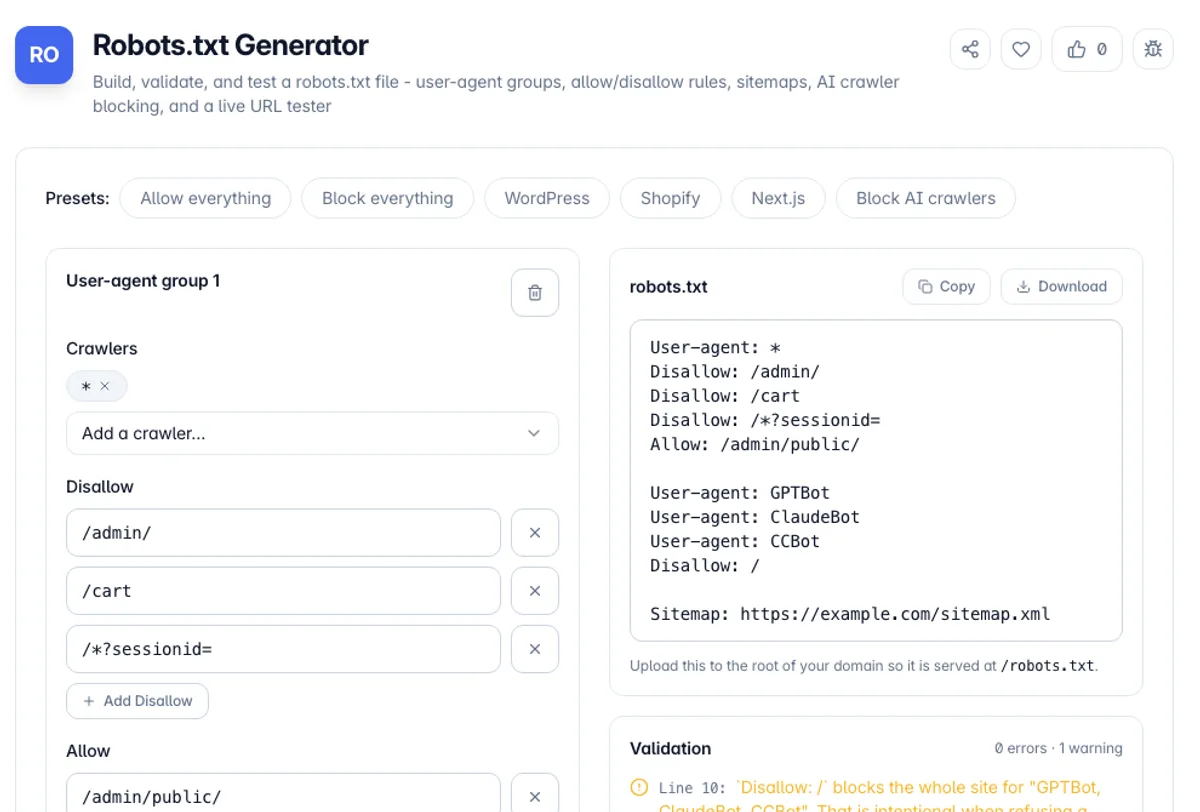
Un generador de robots.txt crea el archivo de texto sin formato que se encuentra en la raíz de su dominio y les dice a los rastreadores qué partes de su sitio pueden obtener. El formato parece simple: una línea `usuario:` y `permitir:` y `reglas de `disAllow:` - pero las reglas de `Biter de detalles sólo se aplican dentro de un grupo, las rutas deben comenzar con una barra, `*` y `$` se comportan de manera específica, y una sola `dislow: /` puede extraer un sitio completo de Google. Esta herramienta construye el archivo desde un formulario estructurado para que la sintaxis sea correcta por construcción.
Hace tres trabajos más allá de la generación. Enreda su archivo y marca las armas de fuego reales: reglas que flotan fuera de cualquier grupo, rutas relativas, un `dislow en simple:` que significa silenciosamente "permitir todo", URL del mapa del sitio que no son directivas absolutas, desconocidas y bloques generales. Analiza un robots.txt existente en grupos editables, para que puedas pegar lo que está en vivo hoy y arreglarlo. Y prueba una URL con sus reglas con el mismo uso de rastreadores reales de precedencia de mayor duración, el patrón de coincidencia más específico gana y permite que los ritmos no permitan los lazos, para que pueda probar que se puede acceder a una página antes de implementar.
Una cosa que vale la pena indicar claramente: robots.txt controla el rastreo, no la indexación, y no es un límite de seguridad. Una URL bloqueada puede seguir apareciendo en los resultados de búsqueda si otras páginas se vinculan, porque Google puede indexar una URL que nunca ha recuperado. Para mantener una página fuera del índice, necesita una metaetiqueta de meta o un encabezado de etiqueta x-robots, que el rastreador solo puede ver si se le permite recuperar la página. Y el archivo es público: cualquiera puede leer el tuyo en /robots.txt, por lo que enumerar un directorio secreto allí lo anuncia. Utilice la autenticación para cualquier cosa privada.
¿Cómo usar el generador robots.txt?
Comience desde un preset o pegue su archivo actual
Elija un preset: permita que todo, bloquee todo, WordPress, Shopify, Next.js o bloquee los rastreadores de IA, para completar el formulario con un solo clic, o pegue su Live Robots.txt y deje que la herramienta lo participe en grupos editables.
Cree sus grupos de agentes de usuarios
Agregue un grupo por rastreador o conjunto de rastreadores, elige de la lista de bots conocidos o escribiendo una ficha. Dele a cada grupo su no permitir y permitan rutas, y un retraso de rastreo si el motor al que se dirige con honores uno.
Agregar mapas de sitio y leer el validador
Agregue una o más URL de mapa del sitio absoluto. El validador se ejecuta en cada pulsación de tecla e informa errores, advertencias y notas con números de línea: corrija cualquier cosa en rojo antes de enviar.
Prueba una URL, luego copia o descarga
Introduzca una ruta y un agente de usuario para ver permitido o no permitido y exactamente qué regla lo decidió. Cuando se comporte de la manera que esperas, copia el archivo o descarga robots.txt y cárgalo a la raíz de tu dominio.
Características clave
Probador de URL de coincidencia real más larga
Prueba cualquier ruta contra cualquier agente de usuario utilizando la precedencia RFC 9309 -el patrón coincidente más largo gana, permite romper lazos- y nombra la regla exacta que lo decidió
Validador incorporado
Captura reglas fuera de un grupo, rutas relativas, líneas de no permitir vacías, URL de mapa de sitio no absoluto, directivas desconocidas y una no permitir la aplicación de una manta: / que desindex su sitio
Presets con un solo clic
Permita todo, bloquee todo, WordPress, Shopify, Next.js y Bloquee los rastreadores de IA cada uno llena todo el formulario con un punto de partida sensato y correcto
Controles de orugas de IA
Bloquear GPTbot, Claudebot, PerplexityBot, CCBot, Google-Extended, Bytesspider y Anthropic-AI con un solo clic, mientras mantiene los motores de búsqueda totalmente bienvenidos
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!