User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
Qu'est-ce qu'un générateur robots.txt ?
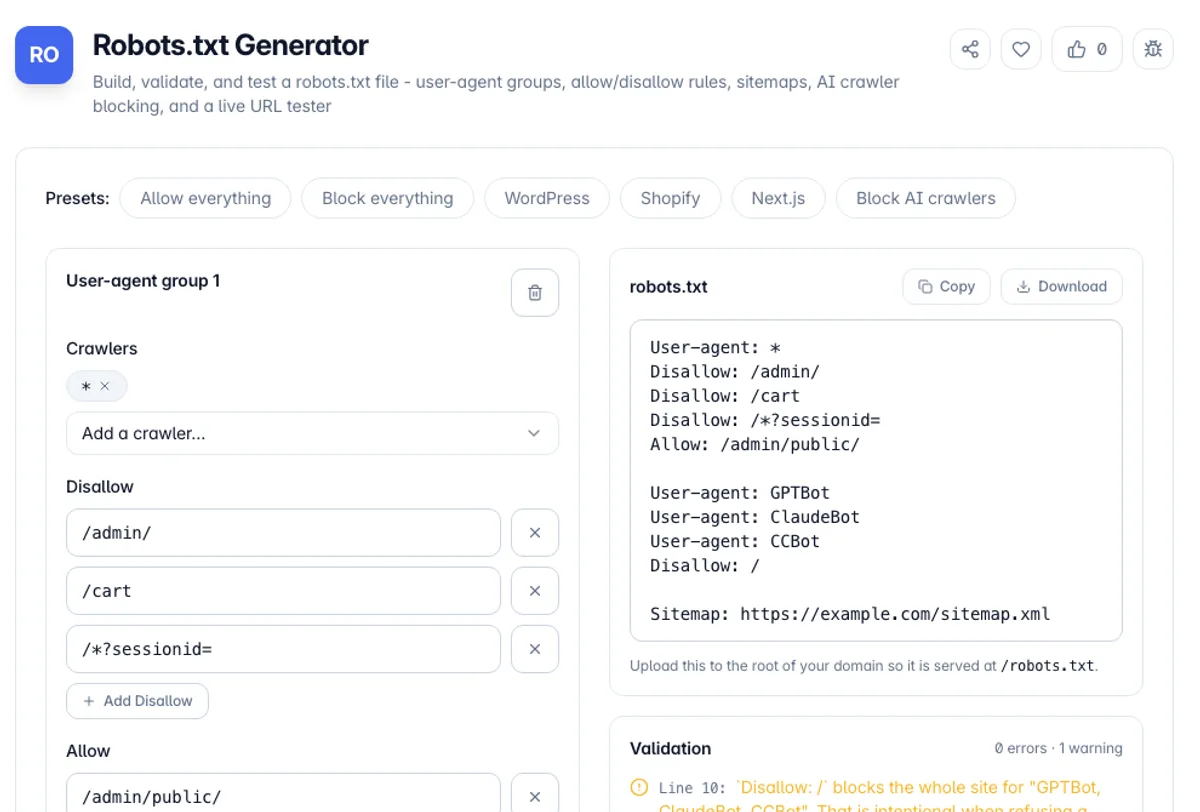
Un générateur robots.txt construit le fichier en texte brut qui se trouve à la racine de votre domaine et indique aux robots d'exploration quelles parties de votre site peuvent récupérer. Le format semble simple - une ligne "user-agent:` suivi de "Autoriser :` et "désallow :" - mais les détails mordent : les règles ne s'appliquent qu'à l'intérieur d'un groupe, les chemins doivent commencer par un slash, `*` et `$` se comportent de manière spécifique, et un seul errant errant : /` sous `user-agent : *` peut extraire un site entier de Google. Cet outil construit le fichier à partir d'une forme structurée afin que la syntaxe soit correcte par construction.
Il effectue trois emplois au-delà de la génération. Il associe votre fichier et signale les véritables pieds de marche : des règles flottant en dehors de tout groupe, chemins relatifs, un "désautoriser" :" qui signifie silencieusement "autoriser tout", les URL de plan de site qui ne sont pas des directives absolues, inconnues et des blocs de couverture. Il analyse un robots.txt existant dans des groupes modifiables, afin que vous puissiez coller ce qui est en direct aujourd'hui et le réparer. Et il teste une URL par rapport à vos règles avec la même priorité la plus longue que les véritables robots d'exploration utilisent - le modèle de correspondance le plus spécifique gagne, et autorise les battements à égalité - afin que vous puissiez prouver qu'une page est accessible avant de déployer.
Une chose qui vaut la peine d'être dite clairement : robots.txt contrôle l'exploration, pas l'indexation, et ce n'est pas une limite de sécurité. Une URL bloquée peut toujours apparaître dans les résultats de recherche si d'autres pages lui sont liées, car Google peut indexer une URL qu'il n'a jamais récupérée. Pour garder une page hors de l'index, vous avez besoin d'une balise méta `noindex` ou d'un en-tête de balise x-robots - que le robot d'exploration ne peut voir que s'il est autorisé à récupérer la page. Et le fichier est public : n'importe qui peut lire le vôtre sur /robots.txt, donc la liste d'un répertoire secret y fait la publicité. Utilisez l'authentification pour tout ce qui est privé.
Comment utiliser le générateur robots.txt ?
Commencez à partir d'un préréglage ou collez votre fichier actuel
Choisissez un préréglage - Autorisez tout, bloquez tout, WordPress, Shopify, Next.js ou bloquez les robots d'intelligence artificielle - pour remplir le formulaire en un clic, ou coller votre Live Robots.txt et laisser l'outil analyser dans des groupes modifiables.
Créez vos groupes d'utilisateurs
Ajoutez un groupe par robot ou un ensemble de robots d'exploration, en choisissant dans la liste des bots connus ou en tapant un jeton. Donnez à chaque groupe son refus et autorisez les chemins, et un retard de crawl si le moteur que vous ciblez en est un.
Ajouter des sitesmaps et lire le validateur
Ajoutez une ou plusieurs URL absolues du sitemap. Le validateur s'exécute sur chaque frappe et signale les erreurs, les avertissements et les notes avec des numéros de ligne - corrigez tout ce qui est rouge avant d'expédier.
Testez une URL, puis copiez ou téléchargez
Entrez un chemin et un agent utilisateur pour voir autorisé ou non et exactement quelle règle l'a décidé. Lorsqu'il se comporte comme vous l'attendez, copiez le fichier ou téléchargez robots.txt et téléchargez-le sur la racine de votre domaine.
Principales caractéristiques
Véritable testeur d'URL à correspondance la plus longue
Teste n'importe quel chemin par rapport à n'importe quel agent utilisateur à l'aide de la priorité RFC 9309 - le modèle correspondant le plus long gagne, autorise les liens de rupture - et nomme la règle exacte qui l'a décidé.
Validateur intégré
Attrape les règles en dehors d'un groupe, les chemins relatifs, les lignes de refus vides, les URL de plan de site non absolues, les directives inconnues et une interruption de la demande : / qui désindexerait votre site
Préréglages en un clic
Autorisez tout, bloquez tout, WordPress, Shopify, Next.js et bloquez les robots d'intelligence artificielle remplissent chacun le formulaire avec un point de départ raisonnable et correct.
Commandes de robots d'exploration d'IA
Bloquer GPTBOT, ClaudeBot, PerplexityBot, CCBOT, Google-Extended, ByTespider et Anthropic-AI en un clic tout en gardant les moteurs de recherche pleinement les bienvenus
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!