初めてバイナリが本当に私を噛んだのは、コンピューター サイエンスのクラスではありませんでした。制作上のバグでした。私が保守している WordPress プラグインは、英語以外の文字をめちゃくちゃにする方法で短い文字列を保存しており、破損がどこで起こったのかを解明するには、実際のバイトを確認する必要がありました。壊れた文字列を "binary" box に貼り付けました。オンラインで発見し、1 と 0 の壁を取り戻し、すぐにツールが ASCII 文字のみを処理していることに気づき、アクセントのある文字を静かに削除しました。それが見せたバイトは嘘で、スタックの間違ったレイヤーを追いかける午後を無駄にしました。
それがバイナリ変換のことです: それはおもちゃのように見えます、そして無料のツールのほとんどはそれを1 つのように扱います 適切な翻訳者は、人々が実際にタイプする文字の全範囲をエンコードする必要があります - アクセント、絵文字、中国語、アラビア語 - UTF-8 を介して、現代のウェブのエンコーディングが実行され、それはそれらをバイトごとにデコードし直さなければなりません構築します Toolz.dev、WP Adminify プラグインと、かなりの量の Laravel と React を使用しているため、テキストとそのバイト表現の間を、必要以上に移動して、 バイナリ トランスレータ 簡単な 128 だけでなく、すべての文字に対して正しく変換を行うことができます。
tl;dr: バイナリ トランスレータは、テキストをコンピュータの 1 と 0 に変換し、それらの 1 と 0 をテキストに戻します。 キャッチは文字エンコーディングです。ASCII は 128 文字しかカバーしませんが、実際のテキストには 1 文字から 4 バイトまでの UTF-8 が必要です。 ザ・ バイナリ トランスレータ すべてをエンコードしてデコードします ユニコード 絵文字を含む範囲は、ブラウザー内で 2 進数、16 進数、10 進数、8 進数で表示され、ペーストのデコードに失敗した場合にどのトークンが間違っているかを正確に示します。
バイナリ翻訳とは、実際には何ですか?
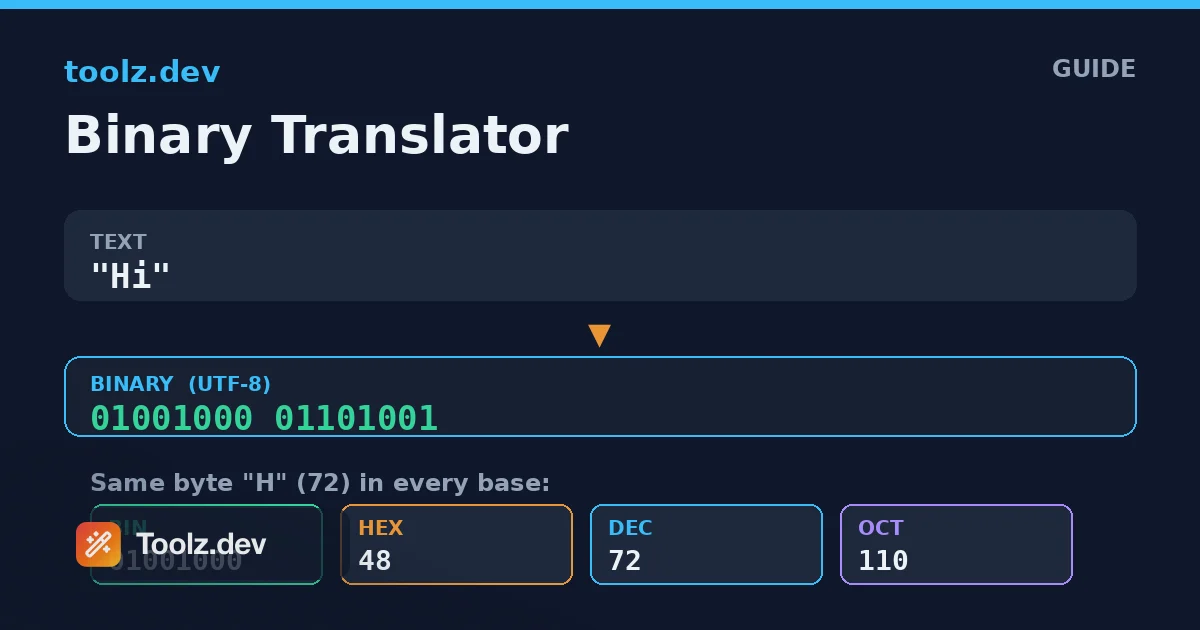
バイナリ トランスレータは、人間が読めるテキストと、コンピュータがそのテキストを保存するために使用する数値表現との間の変換器です。入力したすべての文字は 1 バイト以上 (0 から 255 までの数字) として保存され、各バイトは 2 進数 (2 進数)、16 進数 (16 進数)、10 進数 (10 進数)、または 8 進数 (8 進数) で記述できます。 "Hi" をバイナリに翻訳すると、次のようになります 01001000 01101001; 8 ビットの 2 つのグループは、「H」と「I」の 2 バイトです。
単語 "translate" はここで実際の作業を行っています、なぜなら翻訳テーブルが関係しているからです。 72 のバイト値は本質的に文字 "H" を意味しません - それは "H" を意味します; 文字エンコーディングがそう言っているからだけです。基本的な英語の文字、数字、一般的な句読点の場合、そのマッピングは ASCII です。1960 年代の標準で、値 0 ~ 127 に 128 文字を割り当てます。ASCII は、なぜ "H" が 72、スペースが 32 であり、誰もが正しく理解できるバイナリ変換の部分です。
問題は値127 より上から始まります 世界は128 個をはるかに超える異なる文字をタイプし 残りを扱うエンコーディング - ブラウザーやデータベース そしてJSONが ほぼ確実に使う - はUTF-8 です 優れたバイナリ翻訳機は 実は UTF-8 コーデックで 上に基底変換層があります バイナリ トランスレータ まさにそのように構築されているため、絵文字を含む文字列を往復させて、同じ文字を返すことができます。
テキストをバイナリに変換する方法は?
テキストをバイナリに変換するのは 2 段階のパイプラインであり、その段階を理解すると、このツールが行うすべてのことを説明します。 第一段階は 文字をバイトにエンコードする、2番目は 選択したベースに各バイトを書き込む。
エンコーディングは、UTF-8 が住む場所です。 UTF-8 は可変長のエンコーディングです。文字がプレーンな ASCII 文字の場合は 1 バイト、ラテン語アクセントのほとんどの文字は 2 バイト、多くの記号は 3 バイトで、世界のスクリプトの大部分は 3 バイト、一般的でない文字の場合は 4 バイトです。 つまり、「a」は 1 バイト、「エ」は 2 で、「中」は 3 で、顔の絵文字は 4 です。 エンコーダは文字列を調べ、基本範囲外の文字に対しては、正しいマルチバイト シーケンスを生成し、その後に続くバイト数を示す先頭のビットを備えています。
第二段階は純粋な算術です。 バイト値のリストを取得したら、バイナリで書き込むということは、0 から 255 までの各数値を 8 ビットとして表現し、ゼロに埋め込まれたように、すべてのバイトが同じ幅になることを意味します。 16 進数は、各バイトを正確に 2 文字 (00 ~ FF) で書きます。そのため、生データを表示するためのコンパクトな 16 進数が Hex です。 8 進数はバイトごとに 3 桁を使用し、10 進数は単純な数字を示します。 ザ・ バイナリ トランスレータ 基礎となるバイトが同じであるため、4 つの基数すべてを瞬時に切り替えることができます。表示形式のみが変更されます。
トランスレータはバイナリをテキストに復号する方法を教えてください。
デコードするとパイプラインが逆になります。これは、ほとんどのツールが静かに失敗する方向です。 まず、ツールが必要です 入力をバイト値に読み込みます、それならそうしなければならない それらのバイトを UTF-8 としてデコードして文字に戻します。
入力読み込みはトークン化を意味します バイト間にスペースを持つバイナリを貼り付けると 各グループは1 バイトです 長く連続したビットを1 つ貼り付けると ツールはそれらを8 にグループ化します - これは全長が8 の倍数である場合にのみ機能します そのため 奇数桁には 黙って読み間違えるのではなく フラグが付けられます 同じロジックが16 進数にも当てはまります 1バイトあたり2 文字なので 奇数16 進数はエラーです カンマ、スペース、タブ、改行は全て区切り文字として働くので 最初に再フォーマットせずに コピーしたフォーマットを貼り付けることができます。
第二段階はバイトから文字を再構築し、ここでUTF-8' s構造が重要となる。 0-127 の範囲のバイトはスタンドアロン文字である。 特定のハイビットパターンを持つバイトは2 バイト、3 バイト、4 バイトのシーケンスの開始を知らせ、続くバイトは独自の継続パターンを持たなければならない。 - バイトが欠落しているか、シーケンスが切断されているか、データが最初から有効なUTF-8 ではなかった場合 - バイナリ トランスレータ バイト シーケンスが、置換文字やガベージを送信するのではなく、有効なテキストではないことを報告します。 正直さがポイントです。デコードが失敗した場合、ツールが壊れたかどうかを考えながらもじの見つめを見て、データが間違っていることを知りたいということです。
2 進数、16 進数、10 進数、または 8 進数 - どちらを使用する必要がありますか?
それらはすべて同じバイトを表しているため、誰が読んでいて何に慣れているかを選択します。 各ベースには、自然にフィットするニッチがあります。
| ベース | バイトあたりの数字 | に最適 | 「H」の例 (72) |
|---|---|---|---|
| バイナリ (2) | 8です | 学習、ビットレベルの作業、正確な構造を示す | 01001000 |
| 16 進数 (16) | 2です | 生データの表示、デバッグ、カラー、バイト ダンプ | 48 |
| 10 進数 (10) | 1–3 | 人間にやさしいバイト値、クイック リファレンス | 72 |
| 8 進数 (8) | 3つです | UNIX ファイルのアクセス許可、一部のレガシー システム | 110 |
バイナリは、すべてのビットを見ることができるので、最も明示的で、教えるのに最適ですが、冗長です - バイトあたり8 文字の合計が速く上がります。 16 進数は、実際に最も実際に使用するものです: コンパクトで、それぞれ2 文字でバイトにきれいにマッピングされ、16 進エディタ、メモリダンプ、カラーコードがすべて話す形式です。 10 進数は、文字& #39; sの数値を知りたいときに便利です。 Octal はニッチなホールドオーバーであり、Unix の権限ビットから最もよく知られています 755、そしてそれは主にここにあるので、ツールは完成します。 ザ・ バイナリ トランスレータ 何も入力せずに 4 つすべてを切り替えると、表示を並べて比較できます。
なぜ UTF-8 はバイナリ変換にそれほど重要なのですか?
なぜなら "text to binary" is meaningless until you decide what encoding you are converting through, and for the modern web that answer is almost always UTF-8.asciiだけを扱うツールは動作するように表示されます - それは喜んで英語のテキストを変換します - and then betray you the moment real-world data shows up.
アクセント付きの「é」を考えてみましょう。 UTF-8 では 2 バイトです。 11000011 10101001、または c3 a9 16進数で。 すべての文字を 1 つの ASCII バイトとして扱うツールは、それをまったく表現できません。せいぜい、文字を削除して、最悪の場合、1 バイトの間違ったバイトを生成します。 ここで、UTF-8 の 4 バイトの絵文字を考えてみましょう。 単純なツールは、これらを完全に操作します。 だって、 バイナリ トランスレータ は、本物の UTF-8 コーデックで、「café」は正しい 5 バイトを生成し、これらの 5 バイトを後で貼り付けると「café」が正確に返されます。
これは学問的ではありません。 国際化されたコンテンツ、ユーザー生成データ、または絵文字を使用して何かに触れる人は、すぐにマルチバイト文字にヒットします。 より深い背景が必要な場合は、 Base64 エンコーディングガイド 関連するエンコーディングについて同じバイトレベルの思考をカバーし、一方を理解すると、一方がクリックされます。 短いバージョン: バイトは普遍的ですが、バイトと文字の間のマッピングは選択であり、UTF-8 は Web が選択したものです。
バイナリ トランスレータがキープする一般的な使用例
コンピュータがテキストを保存する方法を学び、教える
バイナリ トランスレータを検索する最も一般的な理由は、その概念を理解するためです。 自分の名前を入力してバイトになるのを観察すると、講義ではできない方法で抽象化が具体化されます。 このツールは正確な 8 ビット グループを表示し、16 進数と 10 進数に切り替えることができるため、エンコードと数のベースがどのように関連しているかについての教材としても機能します。 生徒は、「A」が 65 であることを確認できます。 01000001、そして 41 一度に 16 進数で。
エンコーディングの問題のデバッグ
ここで手を伸ばします 文字列が壊れているとき - 古典的な " eが ang©" mojibakeとして表示されます - 最も速く診断する方法は バイトを調べることです 壊れた文字列をエンコードすると データが二重エンコードされていたか 中文字が切り詰められていたか 間違ったエンコードを想定したシステムで めちゃくちゃになっていたかが分かります 生バイトを見ると 曖昧な " 文字が間違っている " 特定の修正可能な診断に変わります。
低レベルのフォーマットとプロトコルを操作する
ネットワーク パケット、ファイル ヘッダー、バイナリ プロトコル、組み込みシステムはすべて、16 進数とバイナリで話す技術的な作業を直接読み込みます。 テキストのスニペットをバイト表現にすばやく変換したり、キャプチャした 16 進文字列を読み取れるテキストに復号したりできるため、一定のコンテキスト スイッチングが保存されます。 16 進数のビューは、特に 16 進エディターとデバッガーが表示するものと一致します。
パズル、CTF、隠しメッセージ
バイナリとヘックスは、キャプチャー・ザ・フラッグ競技会、エスケープルーム、オタクパズルの定番です。 1 と 0 の文字列は、短いメッセージを隠す一般的な方法であり、連続入力または間隔を置いて入力することで、4 つのベースのいずれかに貼り付けてデコードできるため、これらの作業を短くすることができます。明確なエラー メッセージは、パズル入力に誤字や予期しない区切り文字がある場合に役立ちます。
サーバーではなく、ブラウザで変換するのはなぜですか?
ザ・ バイナリ トランスレータ 完全にクライアント側で実行されます エンコードしたテキストとデコードしたバイト文字列はマシンから離れることはなく、ページが読み込まれるとツールは接続をオフにして作業を続けます。それは最初に表示されるよりも重要です。人々が変換する文字列は、多くの場合、トークン、内部識別子、ユーザー データのスニペット、またはキャプチャされたプロトコル バイトです。まさに、ランダム サーバーに貼り付けるべきではない種類のものです。ブラウザ内処理とは、貼り付けるサーバーがないことを意味します オンライン ツールのデータ プライバシー Guide は、これを主張することについて完全な主張をしています。
バイナリ変換は、関連するエンコーディング タスクのクラスターと並んでいます。 ザ・ Base64 エンコーダ/デコーダ 電子メールやデータ URL などのテキストのみのチャネルを介してバイナリを移動するために使用されるエンコーディングを処理します。 ザ・ URL エンコーダ/デコーダ クエリ文字列のパーセント エンコードをカバーします。 そして、 ハッシュジェネレーター 可逆表現ではなく、指紋が必要なときに、テキストを固定長のダイジェストに変換します。 より広いキットのために、私は構築している間、開いたままにします。 Web 開発者ツールキット ラウンドアップは良い出発点です。
フェイク
テキストをバイナリに変換するにはどうすればよいですか?
バイナリ トランスレータを開き、[テキストからバイナリ] を選択し、基本セットをバイナリにしたままにして、テキストを入力します。 各文字は UTF-8 バイトの値にエンコードされ、8 ビット グループとして表示されるため、「A」は 01000001 になります。 入力すると出力が更新され、ワンクリックでコピーできます。また、何も入力せずに 16 進数または 8 進数に切り替えることができます。
バイナリをテキストに戻すにはどうすればよいですか?
[バイナリをテキストにする] を選択して、バイナリを貼り付けます。 スペース、コンマ、または改行でバイトを区切ることも、全長が 8 倍である限り、連続した 1 つのビットを貼り付けることができます。 このツールはビットをバイトにグループ化し、UTF-8 としてデコードして元の文字を再構築します。また、長さが間違っているか、文字が無効な場合はエラーが報告されます。
バイナリ トランスレータはどの文字エンコーディングを使用しますか?
最新の Web およびほとんどのプログラミング言語で使用されるエンコーディングである UTF-8 を使用します。 ASCII 文字は 1 バイト、最もアクセントの付いた文字は 2 文字、多くのスクリプトとすべての絵文字は 3 バイトまたは 4 バイトを取ります。 これは、128 文字の ASCII 文字のみをマッピングする単純なツールとは異なり、このツールが英語よりもはるかに正しく処理することを意味します。
16 進数、10 進数、8 進数に変換できますか?
はい。 ベース セレクタは、2 進数、16 進数、10 進数、8 進数の間で出力を切り替え、デコードはこれらのベースのいずれかを入力として受け入れます。 16 進数はバイトごとに 2 文字、8 進数 3 桁、10 進数は 0 ~ 255 の値、バイナリは 8 ビットのバイナリを示します。 4 つすべてが同じ基になるバイトを表します。
なぜ私のバイナリ デコードができないのですか?
最も一般的な理由は、8 の倍数ではないビット長と、選択したベースに対して有効ではない迷走文字の 2 つです。ツールは、どのトークンが無効であるか、または長さが間違っていることを正確に伝えるため、修正できます。有効ではないバイト シーケンス UTF-8 - たとえば、切断されたマルチバイト文字 - も、ガベージにデコードされるのではなく、フラグが立てられます。
バイナリ翻訳は、絵文字と非英語のテキストをサポートしていますか?
はい。 UTF-8 を介してエンコードされるため、ASCII 範囲外の文字は 2、3、または 4 バイトの正しいシーケンスとして表され、デコードはそれらを元の文字に再構成します。 絵文字は 4 バイトになり、同じ絵文字に戻る往復で、中国語、アラビア語、またはアクセント付きのラテン語のテキストも同じように機能します。
ここで機密テキストを変換しても安全ですか?
はい。 すべての変換はブラウザ内の JavaScript で実行されるため、入力したものは何もアップロード、ログ記録、保存され、ロードされた後はインターネット接続なしでツールが動作し続けます。 トークン、内部識別子、またはプライベート メッセージをデバイスから離れずに安全に変換できます。
このツールの ASCII と UTF-8 の違いは何ですか?
ASCII は 128 文字の英語文字をカバーする 7 ビット セットですが、UTF-8 は、すべての ASCII と他のすべての Unicode 文字を含む可変長のエンコーディングです。 UTF-8 は ASCII のスーパーセットであるため、英語のテキストは、ASCII テーブルが予測するバイトを正確に生成しますが、アクセント付きの文字、他のスクリプト、および絵文字は、ASCII では単純に表現できない正しいマルチバイト シーケンスを取得します。


