私が Toolz.dev に出荷した Base64 コンバータの最初のバージョンにはバグ I' まだ少し恥ずかしいことがありました。私が書いたすべてのテストで完璧に機能しました - エンコード、デコード、ラウンドトリップ、完了しました。そして誰かが絵文字を含むテキストを貼り付けてこれを得ました:
Uncaught DOMException: InvalidCharacterError:
Failed to execute 'btoa' on 'Window': The string to be
encoded contains characters outside of the Latin1 range.
テキストエンコーディングツールを作成しましたが、テキストに含まれることを忘れていました。 ほとんどのテキスト。 すべての非ラテン文字、すべてのアクセント付き文字、すべての絵文字 - 壊れています。 ASCII で考えるので、私のテストはすべて ASCII でした。そのバグは、どの仕様の読み取りよりも Base64 について多くのことを教えてくれました。そして、I' は、触れたほぼすべての人をつまずかせるため、後で修正を示します btoa()。
Base64 は開発者が毎日使うものの1 つです - すべてのJWT、すべての電子メールの添付ファイル、すべての内部 data: URI - ボンネットの下を見ることはめったにありませんが。 Let'sボンネットの下を見てください。
tl;dr: Base64 エンコーディングは、バイナリデータを64 の安全なASCII文字に変換するので、JSON、URL、電子メールなどのテキストのみのチャネルを通過できます - ~33% のサイズのオーバーヘッドを犠牲にして、 でないよ 暗号化; 誰でも即座に元に戻すことができます。 今すぐエンコードまたはデコードするには、無料のクライアント側を使用してください Base64 コンバーター on Toolz.dev - あなたのデータは決してブラウザから離れない、それはあなた& #39; reデコードトークン時重要です。
base64 エンコーディングとは何ですか?
Base64 は、バイナリからテキストへのエンコーディング スキームです。これは、これまでに構築されたすべてのテキスト システムを存続する 64 文字のみを使用して任意のバイトを表します。 信頼できる仕様は RFC 4648 (2006)、エンコーディングは RFC 1421 に遡り、1993 年のプライバシー強化メール - Base64 は Web ブラウザよりも古いですが。
アルファベット:
A–Z→値 0 ~ 25a–z→値 26–510–9→ 値 52–61+→62、/→63=→パディング(値ではなく、ただのフィラー)
なぜこれらの 64 ? ASCII、EBCDIC、およびこれまでに構築されたすべてのメール ゲートウェイで、それらはアンマングリングされずに生き残るためです。 Base64 は、何十年にもわたるテキストのみのインフラストラクチャを備えた平和条約です。
条約のコスト: すべての3 入力バイトは4 つの出力文字になります - 固定33% のサイズの税 あなたの頭の中でその数を保ちます; それは実際のアーキテクチャの質問を決定します。
Base64 アルゴリズムはどのように機能しますか?
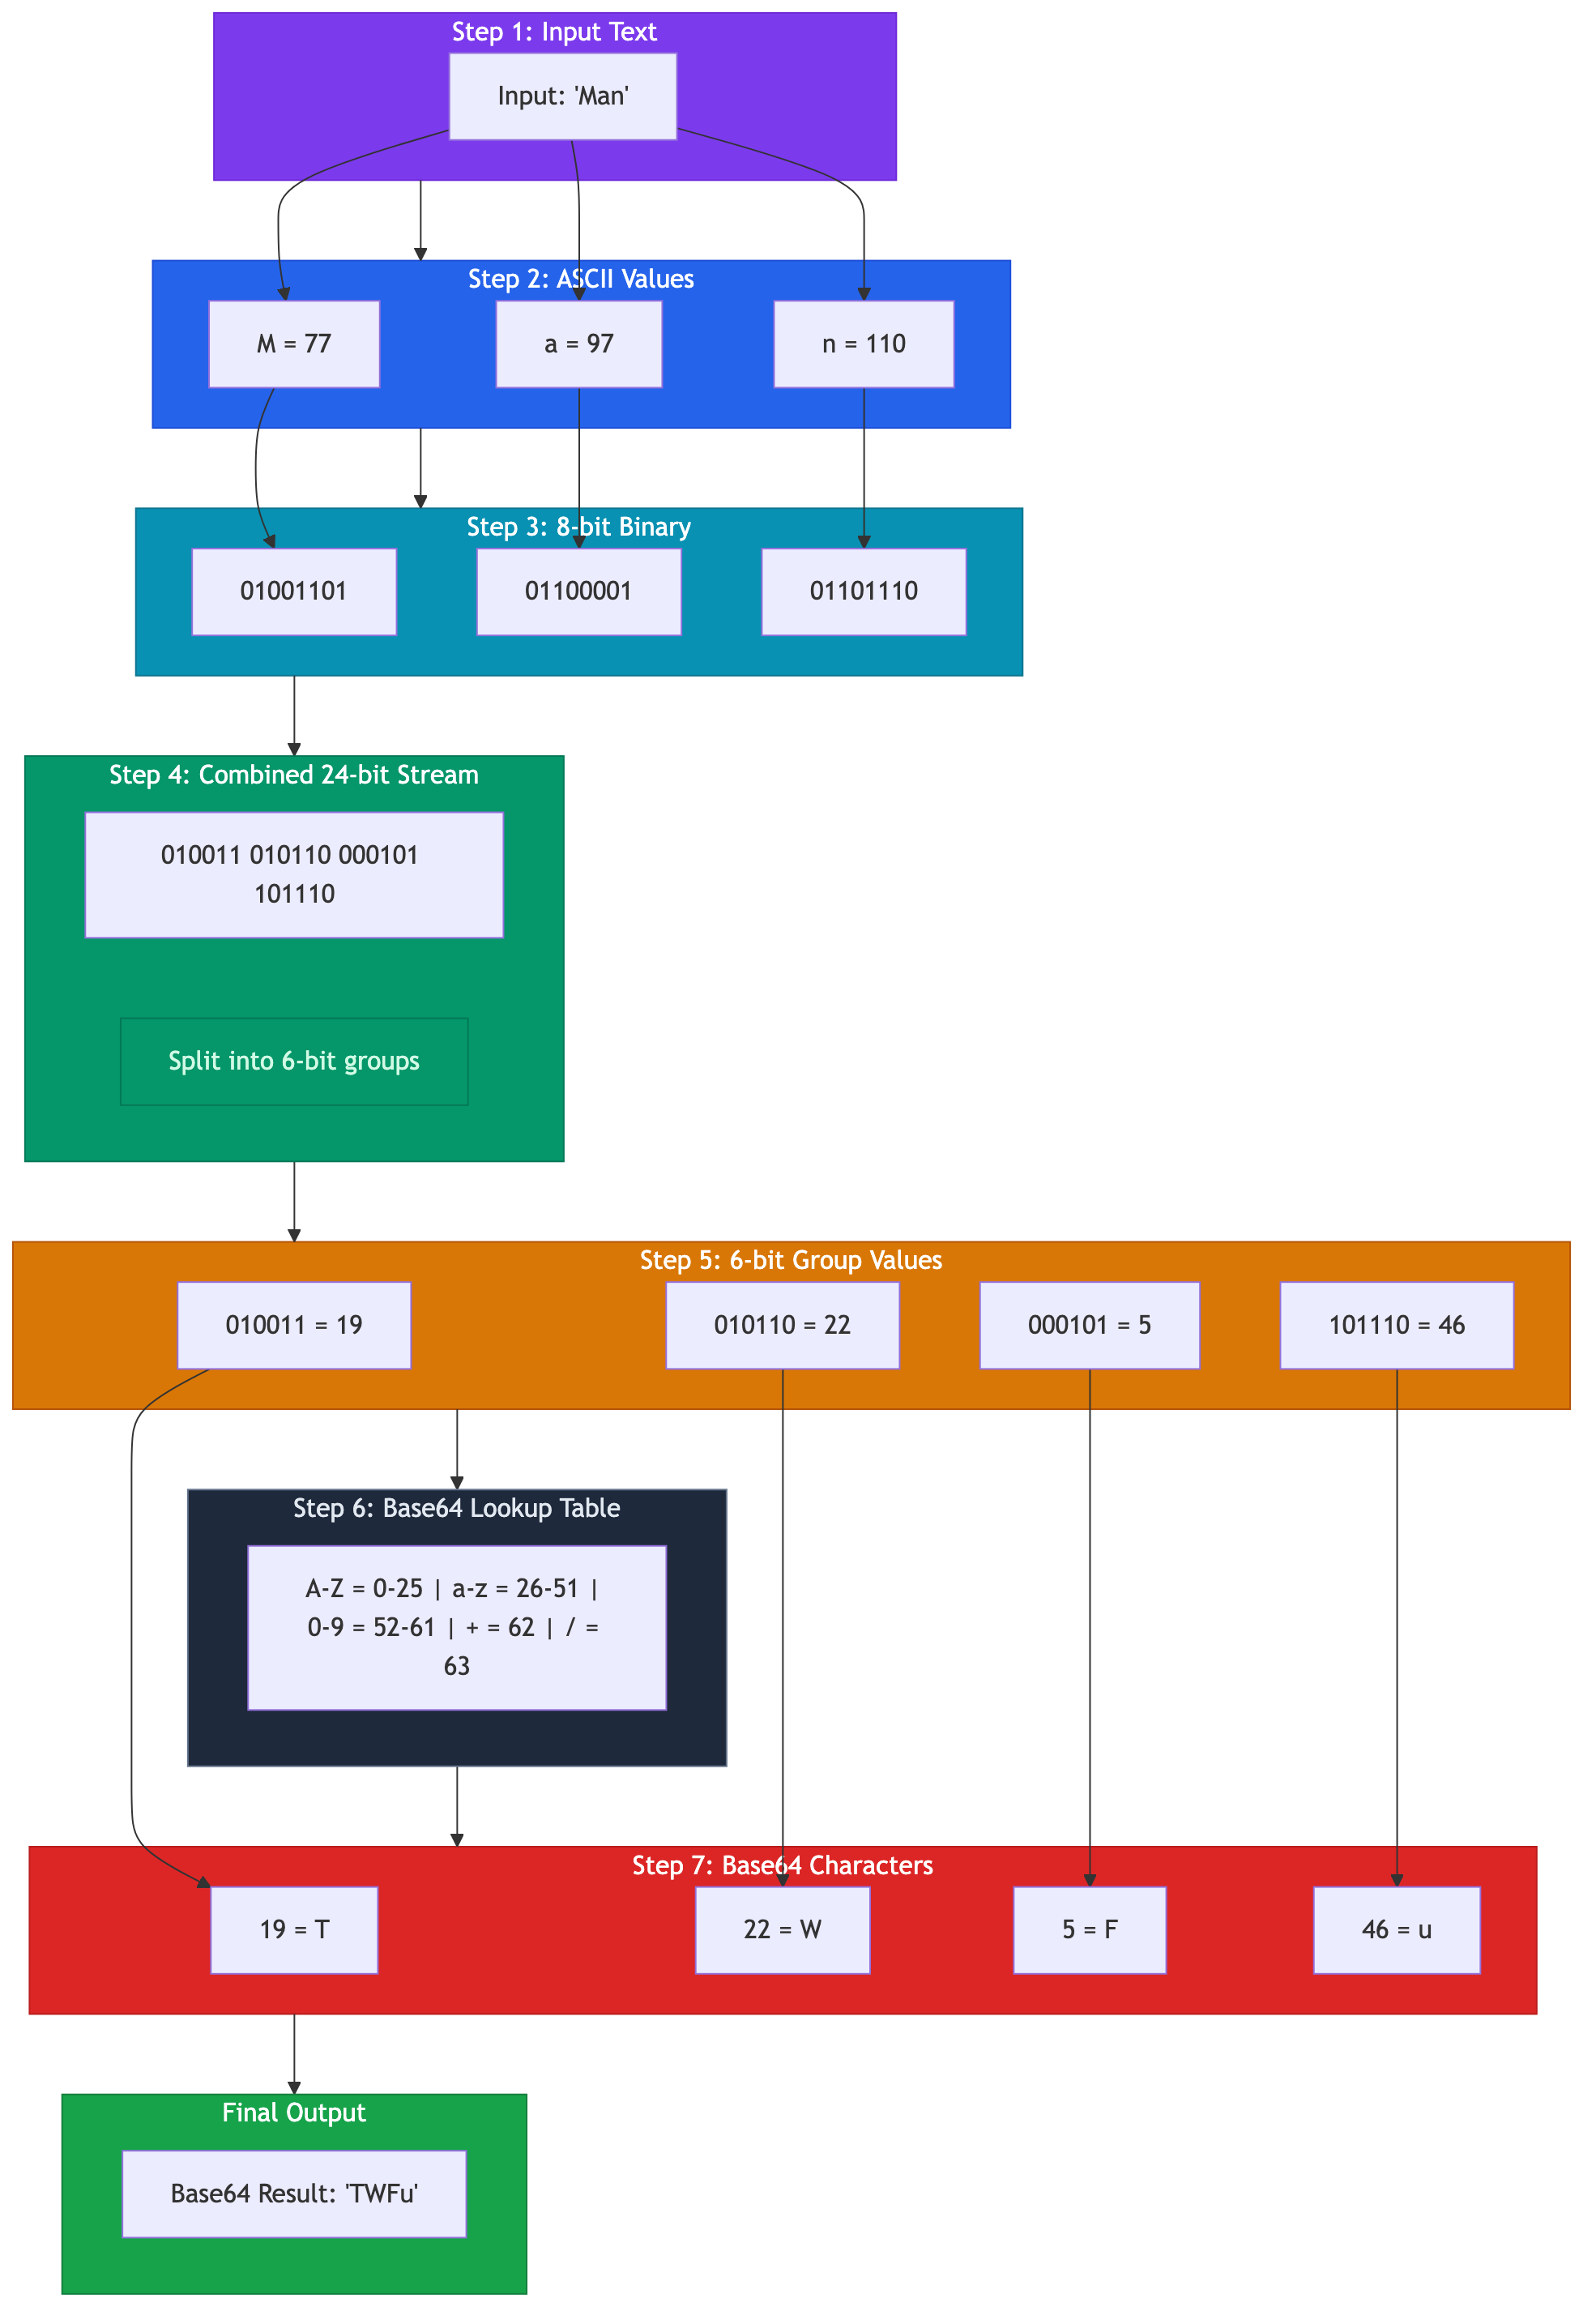
あなたよりも短い答え& #39;d は期待しています: ビットを 8 から 6 に再グループ化し、テーブルで調べてください。 26 = 64 - それ& #39;s は名前の由来です。
エンコーディング Hi!:
ステップ 1 - バイトからビットへ.
| キャラクタ | アスキー | バイナリ |
|---|---|---|
| hし | 72 | 01001000 |
| わたし | 105 | 01101001 |
| ! | 33 | 00100001 |
連結: 010010000110100100100001ー 24 ビットです.
ステップ 2 - 6 ビットのチャンクに再グループ化します。
010010 | 000110 | 100100 | 100001
  18   |   6    |   36   |   33
ステップ 3 - アルファベットで各値を検索します。
18 → S、6 → G、36 → k、33 → h。 そー Hi! エンコード SGkh。
それがアルゴリズム全体です。 ルックアップ テーブル以外に数学はありません。
詰め物 3 バイトの倍数でない入力を処理します。 エンコードしてください Hi (2 バイト = 16 ビット) で、2 ビットと 1 ビットの 6 ビット グループのみを埋めることができます。エンコーダは、ビットと追加をゼロにします。 = フィラーの量を知らせるには、次のようにします。
Hi  → SGk=    (2 bytes remaining → one '=')
H   → SA==    (1 byte remaining  → two '==')
Hi! → SGkh    (multiple of 3     → no padding)
私がこれを Toolz.dev コンバーター用に実装したとき、パディングは私のオフバイワンバグのすべてが住んでいた場所でした。 Base64 をハンドロールすると、コーディング面接用に、たとえば、最初にパディング テストを作成します。
デコードはミラー イメージです。文字を 6 ビット値に戻し、8 ビット バイトに再グループ化し、パディングをドロップします。
Base64 に実際に出くわした場所はどこですか?
JWT - 大きなもの
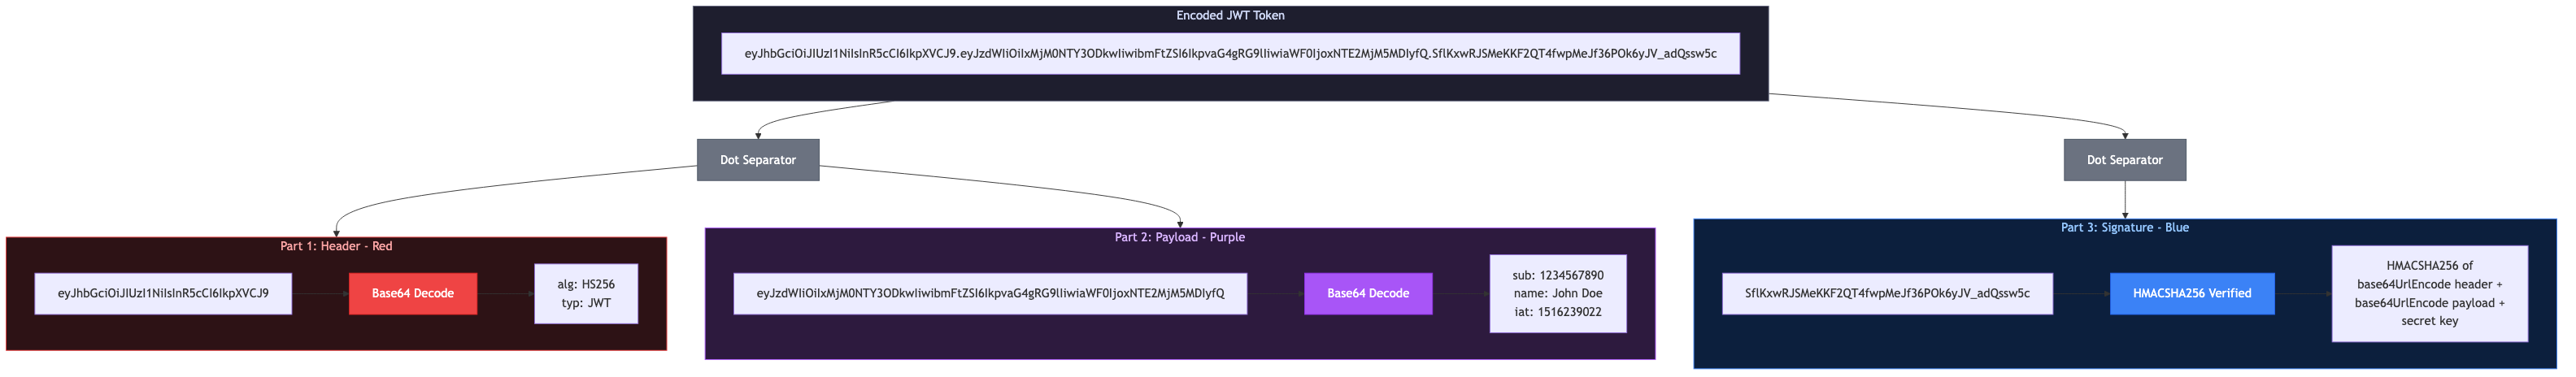
すべての JSON Web トークンは、ドットで結合された 3 つの Base64URL エンコード セグメント (ヘッダー、ペイロード、シグネチャ) です。 認証をデバッグすると、50% がデコードされます。
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJzdWIiOiIxMjM0NTY3ODkwIn0.dozjgNryP4J3jVmNHl0w5N_XgL0n3I9PlFUP0THsR8U
最初のセグメントをデコードすると、 {"alg":"HS256","typ":"JWT"}。 2 つ目は、あなたに主張を示します。 トークンの動作が間違っている場合のワークフロー: ドットで分割し、各パーツをデコードします。 Base64 コンバーターで、json を JSON フォーマッタ きちんと読むために。 2 つのペースト、あなたはそれを知っています exp クレームはあなたの問題です。
はっきりと言う価値があります: JWT ペイロードは トークンを持っている人なら誰でも読める。 署名は、読みではなく改ざんを止めます。 意味のあるデータをクレームに詰め込んだコードベースをレビューしました。 そうではありません。
データ URI
<img src="data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAA..." />
小さなアセットをインラインで埋め込むと、HTTP リクエストが保存されます。 イメージの重い WordPress 管理 UI の構築からの私の経験則: ~5 KB 未満の価値があります。10 KB を超えると、ドキュメントを 33% 膨らませて、リクエストを http/2 マルチプレックスに保存します。
Kubernetes の秘密 - そして暴言
apiVersion: v1
kind: Secret
data:
  password: cGFzc3dvcmQ=   # decodes to "password"
Kubernetes Secrets は Base64 でエンコードされており、これが意味する誤ったセキュリティは憂慮すべきものです。その値は 1 つのペーストでデコードされます。ここでの Base64 は存在するため、バイナリ値は YAML - a に残ります フォーマット 決定であって、セキュリティの決定ではありません。 あなたの秘密の話が「etcd の base64」で終わると、まだ始まっていません。
リストの残りの部分
HTTP 基本認証ヘッダー (Authorization: Basic dXNlcjpwYXNz プレーンにデコード user:pass- したがって、HTTPS のみです。 MIME 経由で添付ファイルを電子メールで送信します。 JSON にはバイナリ タイプがないため、JSON ペイロード内のバイナリ ブロブ。
base64 は暗号化されていますか? (いいえ、お願いします、いいえ)
誤解が死ぬことを拒否するので、それ自体のセクションに値します。
base64 は 表現、16 進数で数字を書くのと同じです。 鍵はありません。 秘密はありません。 デコードには、RFC 4648 で公開されたアルファベット テーブルだけが必要です。 Base64-「保護」はすべて、筆記体で書かれて文字が保護される方法で保護されます。
データに機密性が必要な場合: 正しく暗号化します (AES-GCM または Libsodium) そしたら Base64-チャネルにテキストが必要な場合は暗号文をエンコードする エンコードと暗号化は問題なく構成されます - それらは単に aren't の代替物です そして秘密ではなく完全性が必要な場合は、that's a hash's job - the ハッシュジェネレーター SHA-256 とその仲間たちをカバーします。
Base64 は 16 進数、URL エンコーディング、および base85 と比べてどうですか?
| ベース64 | 16進数 (base16) | URL/パーセント エンコーディング | ASCII85 | |
|---|---|---|---|---|
| オーバーヘッドのサイズ | +33% | +100% | 0 ~ 200%、コンテンツに依存 | +25% |
| アルファベ | 64文字 | 16文字 | アスキー+ %XX 脱出 |
85文字 |
| 人間が読める出力 | いやー | 見えるバイト境界の種類 | ほとんどの場合、ASCII 入力用 | いやー |
| デフォルトで URL セーフ | いいえ(+、 /、 =) |
はいって | はい、定義上 | いやー |
| あなたはそれで会います | JWTS、MIME、データ URI | ハッシュ、MAC アドレス、カラー コード | クエリ文字列 | PDF 内部 |
私が選ぶ方法: ヘックス 人間が出力を読んだり比較したりするとき、チェックサム、ダイジェスト、目玉でデバッグされたものすべて。 パーセントエンコーディング URL テキストの場合は、バイナリしないでください。 ベース64 テキスト チャネルをバイナリで交差する場合 - ほとんどの実際のケース。 ASCII85 自発的には絶対にありません。8% の節約は、互換性に関する問題をまだ正当化していません。
URL セーフ Base64 とは何ですか?なぜ存在するのですか?
標準の base64 に問題があります。 + クエリ文字列で「スペース」を意味します。 / パスの区切り文字は、 = パラメータを区切ります. standard-Base64 トークンを URL に入れると, どこかに, いくつかのミドルウェア, それをマングルします - 断続的に, そして、唯一の生産で.
RFC 4648 セクション 5 では、通常 Base64URL と呼ばれる修正プログラムを定義しています。
| 標準 | URL セーフ |
|---|---|
+ |
- |
/ |
_ |
= 詰め物 |
通常はただ省略するだけ |
同じアルゴリズム、2 文字の入れ替え、パディングのドロップ JWTはBase64URLを排他的に使用します - まさにこれが、JWTセグメントを厳密なstandard-Base64 デコーダに貼り付けると、迷走時に失敗する理由です - や _。 ザ・ Toolz.dev コンバータ 現実世界の Base64 の半分を拒否するデコーダは、デコーダのほとんどではないため、両方のバリアントを処理します。
経験則: エンコードされた文字列が URL、ファイル名、または HTTP ヘッダーに触れることがあった場合は、最初から URL セーフのバリアントを使用します。 レトロフィットは、見つけて交換することと祈りを加えたものです。
コードでどのようにエンコードおよびデコードしますか?
JavaScript - 陥った罠
これが私が出荷したナイーブ バージョンです。
btoa('Hello')      // "SGVsbG8=" — great!
btoa('café ☕')    // InvalidCharacterError — the bug from my intro
btoa 最新の Unicode 処理より前で、Latin-1 のみを受け入れます。 正しい最新のアプローチは、UTF-8 バイトを明示的に通過します。
// Encode: string → UTF-8 bytes → Base64
const bytes = new TextEncoder().encode('café ☕');
const encoded = btoa(String.fromCharCode(...bytes));   // "Y2Fmw6kg4piV"

// Decode: Base64 → bytes → string
const decoded = new TextDecoder().decode(
  Uint8Array.from(atob(encoded), c => c.charCodeAt(0))
); // "café ☕"
(Node.js では、セレモニーをスキップします。 Buffer.from(str, 'utf8').toString('base64').)
パイソン
import base64

encoded = base64.b64encode('café ☕'.encode('utf-8')).decode('ascii')
decoded = base64.b64decode(encoded).decode('utf-8')

# URL-safe variant — note -_ instead of +/
token = base64.urlsafe_b64encode(b'binary\xfb\xff').decode('ascii')
Python は正しいことを明らかにします: あなたは しなければな バイトを通過させるので、エンコードから UTF-8 へのステップを忘れることはできません。 いいね btoa 同じ背骨で設計されていました。
php
$encoded = base64_encode('café ☕');   // handles bytes as-is — PHP strings ARE bytes
$decoded = base64_decode($encoded);

// URL-safe requires manual translation — a WordPress-plugin-developer classic:
$urlSafe = rtrim(strtr($encoded, '+/', '-_'), '=');
あれか strtr/rtrim ラインは、WP Adminify を含め、私がこれまで取り組んできたすべての PHP コードベースに登場しました。 PHP は URL セーフの組み込みのバリアントを取得していないため、同じ 2 行を書き続けています。
よくある質問
base64 エンコーディングは何に使用されますか?
バイナリ データを ASCII テキストに変換して、テキストのみを処理するシステム (JSON ペイロード、URL、メール (MIME)、HTTP ヘッダー) を通過できるようにします。 JWT トークンで最も頻繁に出会うことがあります。 data: インライン イメージ、Kubernetes シークレット、API ペイロードの URI ファイルを格納する URI。 これは、ストレージやセキュリティ形式ではなく、トランスポート形式です。
base64 は暗号化と同じですか?
いいえ、そして2 つを混同すると、実際のセキュリティインシデントが発生します Base64 にはキーがありません - デコードは公開アルファベットテーブルのみを必要とし、1 つのペーストを任意のものに取ります デコーダ。 チャネルにテキストが必要な場合は、最初に実際のアルゴリズム (AES-GCM) で暗号化して暗号文をエンコードします。
Base64 がデータを 33% 大きくするのはなぜですか?
Base64 の各文字は 6 ビットの情報を保持しますが、完全な 8 ビット バイトを占有するため、3 バイトの入力は常に 4 文字の出力になります - 4/3 ‣ 1.33。 It's はフォーマットの固定コストであり、設計上避けられないものです。サイズが重要な場合は、エンコード前に圧縮し、エンコード後は圧縮しません。エンコードされた出力はランダムに見え、ひどく圧縮されます。
base64 と base64url の違いは何ですか?
base64url スワップ + のため - あんど / のため _、そして通常はドロップします = パディングなので、出力は URL、ファイル名、ヘッダーをエスケープせずに存続します。 RFC 4648 セクション 5 で定義されている、それ以外の点では同じアルゴリズム。JWT は Base64URL を排他的に使用します。そのため、厳密な standard-Base64 デコーダがそれらをチョークすることがあります。
btoa() が無効なキャラクタエラーをスローするのはなぜですか?
文字列には、Latin-1 の外側の文字 (絵文字、アクセント付き文字、非西洋文字) が含まれています。 btoa 1990 年代の API で、賢明な Unicode 処理よりも前のものです。 最初に UTF-8 バイトにエンコードします。 TextEncoder、次に Base64 バイト; このバグを本番ツールに出荷したので、判断はしません。
文字列が base64 かどうかはどうすればわかりますか?
有効な base64 のみが使用します A–Z、 a–z、 0–9、 +、 / (または -、 _ URL セーフの場合)、オプションの末尾 =、長さthat& #39; sパッドを入れたときの倍数4 しかし、普通の単語の多くはあまりにもそのパターンに一致します - cafe は、ガベージ バイトにデコードする有効な base64 です。 実際のテストは、それをデコードして、出力が意味があるかどうかを確認することです。
base64 文字列の最後に改行が表示されるのはなぜですか?
だってさ echo 前に1つ追加 base64 見たことあるから echo "hunter2" | base64 7 バイトではなく 8 バイトをエンコードします。 printf や echo -n 代わりに。 これが、マニフェストで正しく表示され、実行時に失敗する Kubernetes シークレットの最大の原因です。デコードされたパスワードは、目に見えない末尾を運びます。 \n。 ザ・ base64 command は、一部のシステム - pass で 76 列の出力もラップします -w 0 GNU CoreUtils でそれを抑制します。
JWT トークンを手動でデコードするにはどうすればよいですか?
トークンを 2 つのドットで分割し、最初のセグメント (ヘッダー) と 2 番目 (ペイロード) を取り、それぞれを実行します。 Base64 デコーダー they're Base64URLなので、受け入れるツールを使ってください - あんど _。 次に、結果の JSON をフォーマットします。 JSON フォーマッタ 主張を読む。 生産トークンをサーバー側のツールに貼り付けないでください。クライアント側のみです。
画像またはファイルを base64 にエンコードするにはどうすればよいですか?
ファイルをバイトとして読み、次に base64 でそれらのバイトを読み込み、次のようなデータ URI ヘッダーを先頭に追加します data:image/png;base64, したがって、ブラウザはインラインをレンダリングできます。 JavaScript では、 FileReader.readAsDataURL() 両方の手順を実行します。コマンド ラインで、 base64 logo.png 生のエンコーディングを出力します。 keep it to small assets - 33% のサイズ税により、Base64 は大きなものには適さなくなり、ビッグデータ URI によって HTML または CSS が肥大化します。
JavaScript、Python、またはターミナルで base64 をデコードするにはどうすればよいですか?
最新の JavaScript では、Unicode-Safe を使用してデコードします。 new TextDecoder().decode(Uint8Array.from(atob(str), c => c.charCodeAt(0))) むき出しというより atob。 Pythonで、 base64.b64decode(str) バイトを返します - 呼び出し .decode('utf-8') テキスト用。 ターミナルで、 echo "aGk=" | base64 -d (または --decode. 3 つすべてが標準の base64 を期待しているので、翻訳してください -/_ に戻る +// 最初に base64url 文字列を処理している場合。
テイクアウト
Base64 は、現代のウェブの半分を静かに保持する30 年前のビットシャッフルトリックです - authトークン、添付ファイル、インラインアセット、secrets-that-aren& #39; t-secret. 6 ビットの再グループ化を理解し、33% の税金を尊重し、暗号化と決して間違えないようにし、URLが関係するあらゆる場所でURL-safeバリアントに到達します。 That& #39; s 実用的なBase64 マスタリングの95%。
実践的な部分として、 Toolz.dev の base64 コンバーター 標準エンコーディングと URL セーフ エンコーディングは完全にブラウザで行われます。これは Unicode のレッスンを苦労して学んだ人によって構築されたものであるため、' を実行する必要があります。
このシリーズの詳細: 完全な コーディング ツール ガイド その他の日常的なドライバー ユーティリティについては、 正規表現ビルダーガイド 開発者が持っているふりをしている他のスキルに取り組み、base64 デバッグの半分は JSON で終了して以来、 究極の JSON ツールガイド 自然な次の読み物です。
関連記事:


