User-agent group 1
User-agent group 2
robots.txt
User-agent: *
Disallow: /admin/
Disallow: /cart
Disallow: /*?sessionid=
Allow: /admin/public/

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Upload this to the root of your domain so it is served at /robots.txt.
Validation
0 errors · 1 warning- Line 10: `Disallow: /` blocks the whole site for "GPTBot, ClaudeBot, CCBot". That is intentional when refusing a specific crawler - just confirm it is the agent you meant.
Test a URL
The longest matching path pattern wins, and Allow beats Disallow on a tie - the same precedence real crawlers use.
Known crawlers
Click Block to add a group that refuses a crawler outright. Compliance is voluntary - this stops cooperative bots, not scrapers.
| Token | What it is | Action |
|---|---|---|
| Googlebot | Google Search's main web crawler. Blocking it removes you from Google over time. | |
| Googlebot-Image | Crawls images for Google Images. Block it to keep photos out of image search. | |
| Bingbot | Microsoft Bing's crawler. Also feeds Bing-powered results in other products. | |
| DuckDuckBot | DuckDuckGo's own crawler for its instant answers and index. | |
| Baiduspider | Baidu's crawler, the dominant search engine in China. | |
| YandexBot | Yandex's crawler, the leading search engine in Russia. | |
| Slurp | Yahoo's legacy crawler. Still used for some Yahoo verticals. | |
| Applebot | Apple's crawler, powering Siri and Spotlight Suggestions. | |
| Twitterbot | Fetches link preview cards for X/Twitter. Blocking it kills your share previews. | |
| facebookexternalhit | Fetches Open Graph previews for Facebook, Messenger, and WhatsApp. | |
| GPTBotAI | OpenAI's crawler that collects public web content used to train its models. | |
| ClaudeBotAI | Anthropic's crawler for gathering training data for Claude. | |
| PerplexityBotAI | Perplexity's crawler, used to index pages its answer engine cites. | |
| CCBotAI | Common Crawl's bot. Its public corpus is a common source of AI training data. | |
| Google-ExtendedAI | Controls whether Google may use your content for Gemini and Vertex AI training. It does not affect Google Search ranking or indexing. | |
| BytespiderAI | ByteDance's crawler, associated with TikTok and its AI products. | |
| anthropic-aiAI | Legacy Anthropic token. Harmless to keep alongside ClaudeBot for older references. |
Wat is een robots.txt-generator?
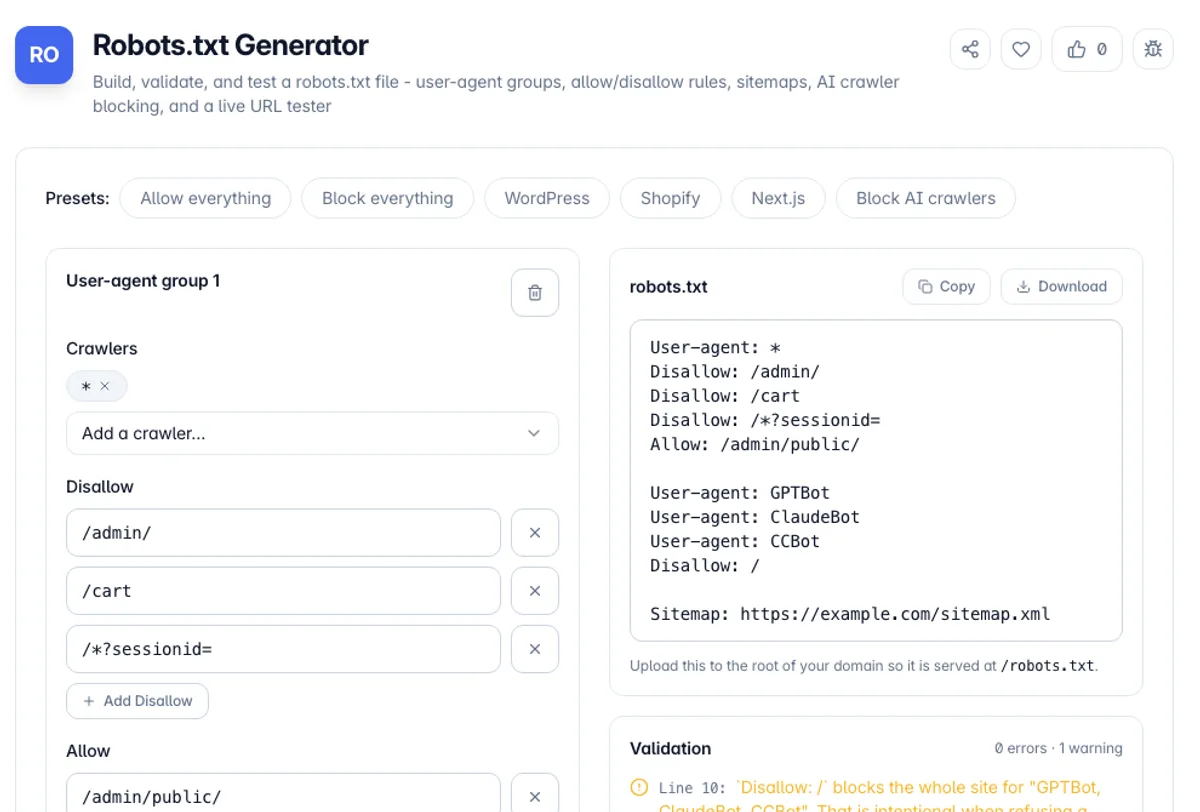
Een robots.txt-generator bouwt het bestand met platte tekst dat zich aan de root van uw domein bevindt en vertelt crawlers welke delen van uw site ze kunnen ophalen. Het formaat ziet er eenvoudig uit - een `user-agent:`-regel gevolgd door `toestaan:` en `disallow:` regels - maar de details bijten: regels zijn alleen van toepassing binnen een groep, paden moeten beginnen met een slash, `*` en `$` gedragen zich op specifieke manieren, en een enkele zwerf `disallow: /` onder `user-agent: *` kan een hele site uit google halen. Deze tool bouwt het bestand op van een gestructureerd formulier, zodat de syntaxis correct is door constructie.
Het doet drie banen buiten de generatie. Het lint je bestand en markeert de echte voetgeweren: regels die buiten elke groep zweven, relatieve paden, een kale `disallow:` die stil betekent "allow alles toe", sitemap-URL's die geen absolute, onbekende richtlijnen en algemene blokken zijn. Het parseert een bestaande robots.txt terug in bewerkbare groepen, zodat u kunt plakken wat er vandaag live is en het repareren. En het test een URL tegen uw regels met dezelfde prioriteit die echte crawlers gebruiken - de meest specifieke wint voor matching, en laat beats toestaan dat u geen banden toestaat - zodat u kunt bewijzen dat een pagina bereikbaar is voordat u implementeert.
Eén ding dat het waard is om duidelijk te zeggen: robots.txt controleert crawlt, niet indexeren, en het is geen beveiligingsgrens. Een geblokkeerde URL kan nog steeds in de zoekresultaten verschijnen als andere pagina's ernaar linken, omdat Google een URL kan indexeren die nooit is opgehaald. Om een pagina uit de index te houden, hebt u een `noindex` metatag of een x-robots-tag-header nodig - die de crawler alleen kan zien als hij de pagina mag ophalen. En het bestand is openbaar: iedereen kan de jouwe lezen op /robots.txt, dus het vermelden van een geheime map daar adverteert het. Gebruik authenticatie voor alles wat privé is.
Hoe gebruik je de robots.txt-generator?
Begin vanaf een voorinstelling of plak uw huidige bestand
Kies een voorinstelling - Allow all, Block Everything, WordPress, Shopify, Next.js of Blokkeer AI-crawlers - om het formulier in één klik in te vullen, of plak je live robots.txt en laat het gereedschap het weer in bewerkbare groepen parseren.
Bouw uw gebruikers-agent-groepen
Voeg een groep per crawler of set crawlers toe, kies uit de lijst met bekende bots of typ een token. Geef elke groep zijn afwijking en sta paden toe, en een crawl-vertraging als de motor waarop u zich richt, er een eer aan doet.
Voeg sitemaps toe en lees de validator
Voeg een of meer absolute sitemap-URL's toe. De validator draait op elke toetsaanslag en meldt fouten, waarschuwingen en notities met regelnummers - repareer alles wat rood is voordat u wordt verzonden.
Test een URL en kopieer of download
Voer een pad en een user-agent in om toegestane of afgekeurde te zien en welke regel het precies heeft besloten. Wanneer het zich gedraagt zoals u verwacht, kopieert u het bestand of downloadt Robots.txt en uploadt het naar uw domeinroot.
Belangrijkste kenmerken
URL-tester met echt langst match
Test elk pad tegen een gebruiker-agent met behulp van RFC 9309 voorrang - de langste overeenkomende patroon wint, breekt banden toe - en benoemt de exacte regel die het heeft besloten
Ingebouwde validator
Vangt regels buiten een groep, relatieve paden, lege lijnen, niet-absolute sitemap-URL's, onbekende richtlijnen en een algemene niet-toestemming: / dat zou uw site deindexeren
Presets met één klik
Alles toestaan, alles blokkeren, WordPress, Shopify, Next.js en blokkeer AI-crawlers vullen elk het hele formulier met een verstandig, correct startpunt
AI-crawlerbedieningen
Block GPTBOT, Claudebot, PerplexityBot, CCBOT, Google-extended, bytespider en antropic-AI in één klik terwijl zoekmachines volledig welkom zijn
Frequently Asked Questions
Related Tools
Hreflang Generator
Free hreflang generator for multilingual and multi-region sites - build hreflang tags as HTML link tags, XML sitemap entries, or an HTTP header. Validates codes and x-default. Runs client-side.
htaccess Redirect Generator
Generate Apache .htaccess 301 and 302 redirect rules from a list of old-to-new URLs, plus force-HTTPS and www canonicalization directives, all in the browser.
Domain Search
Check one name across dozens of TLDs at once. RDAP first, WHOIS fallback, and a verdict of available, taken or unknown, never a guess
Maps Scraper
Pull business listings for any search and place: name, address, category, rating, review count, phone and website, deduplicated and exportable as CSV.
Comments
0 comments
No comments yet. Be the first to share your thoughts!