Ik verloor een middag eenmaal aan een enkel teken Een gebruiker & #39; s naam bevatte een letter met accenten, het zag er prima uit in de database, brak in een PDF-export, en verscheen als een paar vraagtekens in een logboek De oplossing was triviaal toen ik eenmaal het werkelijke codepunt achter de glyph kon zien, maar om daar te komen betekende drie verschillende tools en veel gekraak Dat is de wrijving die ik bouwde de unicode converter in Toolz.dev om te verwijderen: plak elke tekst en zie precies waar deze van gemaakt is, in welke notatie de taak voor u ook wil, en decodeer een van die notaties terug naar leesbare tekst Dit is de gids voor het en voor de tekencodering die het blootlegt.
tl;dr: Elk teken heeft een Unicode-codepunt, een getal geschreven als U+0041 voor A. The Toolz unicode converter verandert tekst in dat codepunt plus decimale, hex- en HTML-entiteiten (A en A), JavaScript ontsnapt (A) en CSS ontsnapt (\41), en decodeert ze allemaal terug naar tekst. Het verwerkt emoji en andere astrale tekens op basis van een echt codepunt, zodat ze correct kunnen rondreizen, een tabel per teken tonen met UTF-8-bytes en volledig aan de clientzijde draait, zodat uw tekst de browser nooit verlaat.
Wat is een Unicode converter?
Een Unicode converter vertaalt tussen de tekst die je leest en de cijfers die een computer ervoor opslaat Elk teken, van een gewone Latijnse letter naar een Chinese ideograaf naar een emoji, krijgt een codepunt toegewezen door de Unicode Standard, en dat codepunt wordt meestal geschreven in de vorm U+ gevolgd door vier tot zes hexadecimale cijfers: U+0041 voor hoofdletter A, U+00E9 voor é, U+E16 voor èn U+1F30D voor de aarde emoji De converter leest wat je ook typt en toont de code achter elk teken, en laat je vervolgens datzelfde codepunt uitdrukken in een van de notaties die verschillende talen en formaten verwachten.
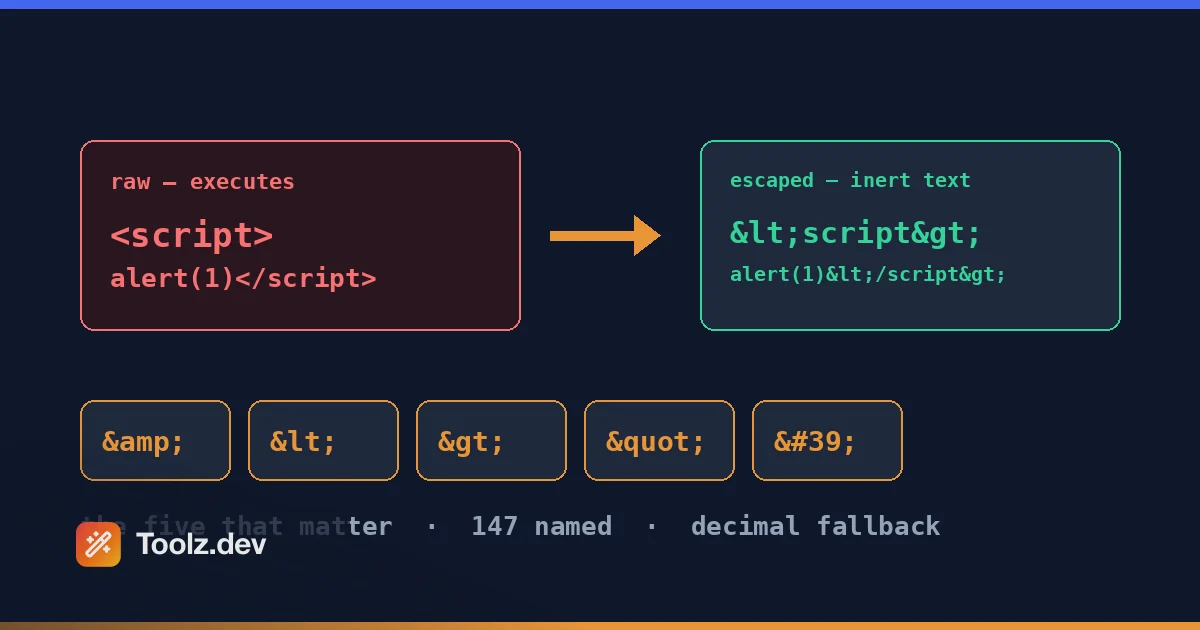
De reden dat een enkel codepunt zoveel geschreven vormen heeft, is dat verschillende contexten verschillende ontsnappingsregels hebben. Een HTML-document gebruikt tekenreferenties zoals A in decimaal of A in hexadecimaal. Een JavaScript-tekenreeks gebruikt A, of \u{1F30D} voor tekens buiten het basisbereik Een CSS-waarde gebruikt \41 met een volgruimte Een spec, een bugrapport, of een Unicode grafiek gebruikt het U+ formulier Ze wijzen allemaal naar hetzelfde karakter; ze dragen gewoon verschillende kleding afhankelijk van waar ze wonen De tool produceert ze allemaal uit één invoer en draait een van hen om, zodat je nooit hoeft te onthouden welke syntaxis een bepaald bestand wil of een lastig teken met de hand opnieuw typt.
Wat is een Unicode codepunt, en hoe verschilt het van UTF-8?
Dit is het onderscheid dat de meeste coderingsverwarring opheldert, dus het is de moeite waard om nauwkeurig te zijn. Een codepunt is een abstract getal dat een teken identificeert. Het zegt niets over hoe dat getal in het geheugen wordt opgeslagen of via een draad wordt verzonden. UTF-8 is een specifieke manier om een codepunt te coderen als een reeks bytes, gedefinieerd in RFC-3629. De twee zijn verwant, maar niet hetzelfde, en het door elkaar halen ervan is de wortel van veel " waarom is mijn tekst onleesbaar" bugs.
Neem é, codepunt U+00E9 Als codepunt is het een enkel getal, 233 in decimaal In UTF-8 wordt het opgeslagen als twee bytes, C3 A9. In UTF-16 is het één 16-bits eenheid Het teken is één ding; de byterepresentatie ervan hangt af van de codering De tabel per teken in de converter toont zowel het codepunt als de UTF-8 bytes naast elkaar, dus als je een naam ziet die rendert als é in plaats van é, je kunt het klassieke symptoom onmiddellijk herkennen: UTF-8-bytes worden gelezen alsof ze een codering van één byte zijn, zoals Latin-1. Het zien van de bytes is vaak de snelste manier om een mismatch van codering te diagnosticeren.
Hier is een kleine kaart van één teken over de notaties die de tool produceert.
| Notatie | Waarde voor é (U+00E9) |
|---|---|
| Codepunt | U+00E9 |
| tientallig | 233 |
| hers | 0xE9 |
| HTML decimale entiteit | é |
| HTML hex-entiteit | é |
| JavaScript-ontsnapping | é |
| CSS-ontsnapping | \E9 |
| UTF-8 bytes | C3 A9 |
Hoe converteer ik tekst naar Unicode?
Kies Encode, kies de gewenste notatie en typ of plak uw tekst De unicode converter toont de gecodeerde uitvoer onmiddellijk en vult een tabel per teken in met het codepunt, de decimale waarde, de HTML-entiteit en de UTF-8-bytes voor elke glyph Kopieer de uitvoer en zet deze in uw HTML, stylesheet, script of document.
De vier stappen zijn snel Eerst, selecteer Encode om van tekst naar notatie te gaan, of Decodeer om de andere kant op te gaan Ten tweede, kies het formaat: codepunt, decimaal, hex, HTML-entiteit, JavaScript escape, of CSS escape, en voor het decoderen is er een automodus die de gangbare formulieren voor u detecteert Ten derde, voer uw tekst in en kijk hoe deze converteert Ten vierde, kopieer het resultaat Er is geen upload en geen account.
Converteren naar HTML-entiteiten is een van de meest voorkomende toepassingen en overlapt met de speciale html-entiteiten tool, die zich richt op genoemde entiteiten zoals & en ©. de html entiteiten gids dekt wanneer een benoemde entiteit de juiste keuze is en wanneer een numerieke de juiste keuze is Deze converter vult deze aan door u de numerieke codepuntweergave te geven van elk teken, al dan niet benoemd.
Gaat het correct om met emoji?
Ja, en dit is waar een heleboel eenvoudigere converters stilletjes gebroken uitvoer produceren Tekens boven U+FFF leven in wat Unicode de aanvullende vlakken noemt, en JavaScript slaat ze elk intern op als twee 16-bits code-eenheden, een surrogaatpaar genaamd. Als een converter naïef een string één code-eenheid tegelijk laat lopen, splitst hij een emoji in twee helften en zendt hij twee betekenisloze ontsnappingen uit die nooit meer in het originele teken zullen worden samengevoegd.
Deze tool itereert door ware code punt, dus een emoji zoals de aarde (U+1F30D) wordt behandeld als één teken overal Encodeer het en je krijgt een enkele schone waarde: \u{1F30D} in de ES6 JavaScript-vorm, 🌍 als HTML-entiteit, U+1F30D als codepunt Decodeer een van deze en de originele emoji komt heel terug Bij het decoderen van ouder-stijl JavaScript escapes die werden geschreven als surrogaatparen, worden 🌍, de tool combineert de helften correct in plaats van je twee kapotte code-eenheden te laten Rondrijden van een emoji door de converter geeft je precies terug waarmee je begon, dat is de baselinetest die een Unicode-tool moet doorstaan en velen falen.
Hoe decodeer ik Unicode escapes terug naar tekst?
Schakel over naar Decoderen, plak de gecodeerde tekenreeks en kies het overeenkomende formaat of laat het op auto staan. Automatische modus herkent U+-notatie, \u en \u{} JavaScript ontsnapt, en &# en &#x HTML-entiteiten in dezelfde invoer, dus een gemengde pasta uit een log of een config-bestand decodeert nog steeds Als u het exacte formaat kent, is het rechtstreeks selecteren ervan de meest betrouwbare optie, vooral voor decimale of gewone hex waar kale getallen anders dubbelzinnig zouden kunnen zijn.
Decoderen is de helft van de taak die u zoekt als u aan de ontvangende kant van gecodeerde tekst staat: een JSON-payload vol met \u escapes, een HTML-bronweergave vol numerieke entiteiten, een stacktracering die een string in ontsnapte vorm registreerde In plaats van teken voor teken met de hand te decoderen, plak je het geheel en lees je de platte tekst terug De converter reconstrueert de originele tekens en voegt, zoals hierboven vermeld, correct alle surrogaatparen die het tegenkomt weer samen, zodat astrale tekens de reis overleven.
Dit past goed bij de andere decoderingstools op de site Percentagegecodeerde tekst in een URL is de taak van de url encoder, en base64-gecodeerd binair getal wordt afgehandeld door de basis64 converter. Het zijn verschillende coderingen voor verschillende transporten, en weten naar welke je kijkt is de helft van het gevecht. De Webontwikkelaar Toolkit guide legt uit hoe deze coderingstools in het dagelijkse werk passen.
Wanneer zou ik eigenlijk CSS of JavaScript escapes nodig hebben?
Vaker dan je zou verwachten, en meestal op het exacte moment dat er iets niet rendert In CSS, de content eigendom van een ::before of ::after pseudo-element kan niet in elke situatie direct willekeurige tekens bevatten, dus je ontsnapt eraan: een naar rechts wijzende pijl wordt content: "\2192". De CSS-ontsnappingsregels, inclusief de volgruimte die een hex-ontsnapping beëindigt, zijn gedefinieerd in de CSS Syntax Module Niveau 3, en de converter zendt precies dat formulier uit, zodat u het rechtstreeks in een stylesheet kunt plakken.
In JavaScript kunt u met escapes een teken in de broncode plaatsen zonder afhankelijk te zijn van de file's-codering of van uw editor die het correct weergeeft. © is ondubbelzinnig waar een letterlijk auteursrechtsymbool verminkt zou kunnen raken door een tool in de pijplijn Voor karakters buiten het basisvlak, de ES6 \u{...} de vorm is schoner dan een surrogaatpaar, en de converter gebruikt deze voor astrale karakters terwijl de vier cijfers behouden blijven \uXXXX formulier voor tekens die erin passen HTML numerieke tekenreferenties, de &#...; formulieren dienen hetzelfde doel bij het opmaken en worden beheerst door de WHATWG HTML-standaard. Als u al deze gegevens uit één invoer laat genereren, betekent dit dat u niet meer naar de syntaxis raadt en elke keer de juiste ontsnapping kopieert.
Welke notatie moet ik gebruiken, en wanneer?
Met zeven outputformaten die worden aangeboden, is de praktische vraag welke een bepaalde taak wil, en het antwoord wordt bijna altijd gedicteerd door waar het personage gaat wonen in plaats van door voorkeur Als u HTML schrijft en een teken nodig heeft dat lastig te typen is of dat anders zou worden geïnterpreteerd als opmaak, gebruik dan een HTML-entiteit: — of zijn hex twin —. Als het teken in een letterlijke JavaScript-tekenreeks terechtkomt, gebruikt u de \u ontsnap en reik naar de \u{...} vorm wanneer het teken voorbij het basisvlak is Als het in een CSS-waarde thuishoort, vooral de content eigenschap, gebruik de CSS-ontsnapping met zijn volgruimte Als u een spec, een opmerking of een bugrapport schrijft waarin u het personage ondubbelzinnig een naam wilt geven zonder het te renderen, is het U+ codepuntformulier de conventie die iedereen herkent.
De decimale en hexuitgangen zijn degene waar mensen minder vaak naar grijpen, maar ze doen er toe als je praat met een systeem dat in onbewerkte getallen spreekt: een databasekolom waarin codepunten worden opgeslagen, een protocol dat tekens als gehele getallen verzendt, een opzoeking tegen een Unicode-gegevensbestand Een teken naar de kale decimale of hexadecimale waarde kunnen omdraaien, en weer terug, slaat een handmatige basisconversie op precies het moment dat je al diep in een foutopsporingssessie zit.
Er is één regel die ze allemaal doorkruist: welke notatie je ook uitzendt, decodeer het terug en bevestig dat je het originele teken krijgt voordat je het vertrouwt. Round-tripping is de goedkoopste juistheidscontrole die er is, en het vangt de twee klassieke fouten onmiddellijk op: een verminkt surrogaatpaar voor een astraal teken en een off-by-one in de hex-cijfers. De converter maakt die controle een enkele pasta in de tegenovergestelde richting. Als er een veiligheidsgevoelige waarde bij betrokken is, geldt dezelfde discipline voor de procentcodering die door de hex-cijfer wordt afgehandeld url encoder, waarbij een verkeerde ontsnapping kan veranderen wat een server daadwerkelijk ontvangt.
Is het veilig om hier gevoelige teksten te converteren?
Ja Elke conversie gebeurt in JavaScript binnenin uw browser Niets dat u plakt wordt naar een server verzonden, niets wordt gelogd en de tool blijft werken met uw verbinding uitgeschakeld zodra de pagina is geladen U kunt privé-strings, gebruikersgegevens of de inhoud van een intern bestand inspecteren zonder dat een van deze uw machine verlaat.
Die eigenschap is niet incidenteel, het is de reden om voor dit soort werk de voorkeur te geven aan een client-side tool, de tekst die je door een Unicode converter haalt is vaak precies de tekst die je het minst aan een derde partij zou willen overhandigen: een echte gebruiker' s naam die je debugt, een fragment van een privé dataset, een string van een niet-uitgebrachte functie Een server-side converter, hoe betrouwbaar ook, is nog een partij in de keten Het doen van het werk in de browser verwijdert de vraag De bredere redenering zit in de online tools voor gegevensprivacy gids, en het is van toepassing op elk coderingstool op Toolz.dev, van deze tot de base64 coderingsgids en verder.
Veelgestelde vragen
Hoe converteer ik tekst naar Unicode?
Plak uw tekst in het invoergebied met Encode geselecteerd en kies een formaat zoals codepunt of HTML-entiteit. De tool toont de Unicode-weergave van elk teken onmiddellijk, allemaal in uw browser.
Wat is een Unicode codepunt?
Een codepunt is het nummer dat Unicode aan een teken toewijst, geschreven als U+0041 voor A. Het identificeert het teken onafhankelijk van hoe het wordt opgeslagen. Daarom kan hetzelfde codepunt verschijnen als een HTML-entiteit, een JavaScript-ontsnapping of een CSS-ontsnapping.
Wat is het verschil tussen een codepunt en UTF-8?
Een codepunt is het abstracte getal voor een teken; UTF-8 is één manier om dat getal op te slaan als één tot vier bytes De tabel per teken toont beide, zodat je kunt zien dat U+00E9 voor é wordt opgeslagen als de twee UTF-8 bytes C3 A9.
Gaat het correct om met emoji?
Ja. Emoji leven buiten het basisbereik en worden opgeslagen als surrogaatparen in JavaScript De converter leest en schrijft ze op ware codepunt, dus een emoji zoals de aarde (U+1F30D) retourvluchten zonder zich in twee gebroken helften te splitsen.
Hoe decodeer ik Unicode escapes terug naar tekst?
Schakel over naar Decoderen, plak de gecodeerde tekenreeks en kies het overeenkomende formaat of gebruik auto om het te detecteren. De tool reconstrueert de originele tekens en combineert correct alle surrogaatparen die het vindt.
Wanneer zou ik een CSS-ontsnapping nodig hebben?
Met CSS-escapes kunt u een teken in een stylesheetwaarde plaatsen, zoals de inhoudeigenschap. De tool voert waarden uit zoals \41 met de volgruimte die CSS gebruikt om een hex-escape te beëindigen, klaar om in een inhoudeigenschap te plakken.
Kan het hetzelfde teken naar meerdere formaten tegelijk converteren?
Ja. Als u een formaat kiest, wordt de hoofduitvoer ingesteld en in de tabel per teken worden altijd het codepunt, de decimale waarde, de HTML-entiteit en de UTF-8-bytes voor elk teken weergegeven, zodat u in één oogopslag meerdere notaties kunt lezen.
Is het veilig om hier gevoelige teksten te converteren?
Ja Alle conversie gebeurt in JavaScript binnenin uw browser Niets wordt naar een server verzonden, niets wordt gelogd, en de tool werkt met uw verbinding uitgeschakeld.
de unicode converter is gratis, draait volledig in uw browser, en hoeft niet te worden aangemeld Coderen van een teken in een notatie, decodeer het terug, en lees de ruwe bytes achter elke glyph Verken het naast de ascii-tabel en de rest van de coderingstools aan Toolz.dev.