Um 2021 landete ein WP Adminify Support Ticket mit einem Screenshot, der mich immer noch zucken lässt Ein User hatte einen benutzerdefinierten Admin Footer Text gesetzt - eine vollkommen unschuldige Copyright-Linie mit einem © und ein Link zu ihrer Agentur. Auf ihrem Bildschirm wurde es als © 2021 — Bright & Codrohen Drei sichtbare Entitäten, null gerenderte Zeichen. Der Schuldige war ich. Meine Speicherroutine entkam dem Text, meine Render-Routine entkam erneut und irgendwo dazwischen ist ein Filter ein drittes Mal. Als es den Browser traf, war dieser arme kaufmännische und viermal entkommen. Ich habe gezählt.
Die Lösung dauerte zehn Minuten. Es dauerte zwei Abende, weil es entkamen Text-Looks fast richtig du überflog © in einem Datenbank-Dump und Ihr Gehirn korrigiert es automatisch ©drohen Am Ende habe ich immer wieder Zeichenfolgen in eine scratch-HTML-Datei eingefügt, um zu sehen, was der Browser tatsächlich auf jeder Ebene rendern würde. Das ist ein miserabler Workflow, und genau deshalb ist ein HTML-Entity-Encoder-Decoder eines der ersten Tools, die ich in Toolz.dev eingebaut habe.
Die Kehrseite derselben Münze ist beängstigender. Einige Monate vor diesem Ticket fand ich während einer Codeüberprüfung meines eigenen Plugins ein Einstellungsfeld, das die Eingabe von Benutzern in eine Administratormitteilung ohne Echo esc_html()drohen Jeder, der Zugriff auf dieses Feld hat, könnte gespeichert werden <script> Und ließ es für jeden Admin ausführen, der die Seite geladen hat XSS gespeichert, in meinem eigenen Code, eine fehlende Funktion wegrufen Niemand hat es ausgenutzt - ich hatte Glück Aber es hat nachhaltig verändert, wie ich über das Entkommen denke: it' s keine Formatierungsarbeit, it' s die Grenze zwischen & quot; text" und & quot;code."
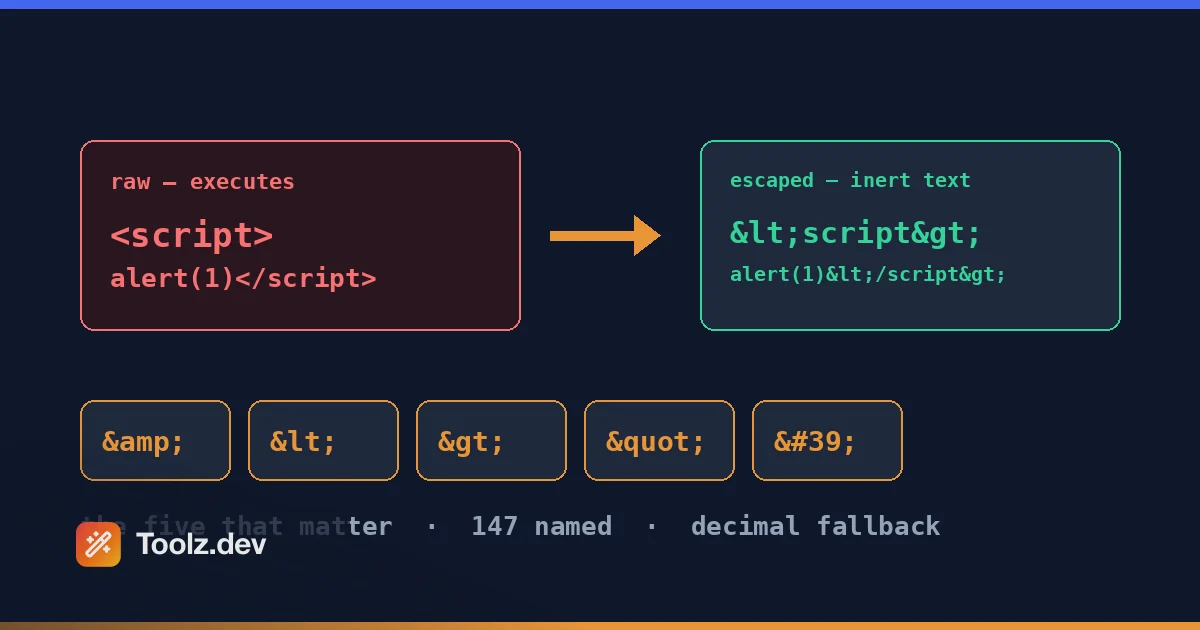
Also deckt diese Anleitung beide Richtungen ab Kodierung, also nicht vertrauenswürdiger Text bleibt Text Dekodierung, so können Sie lesen, was einige übereifrige Pipeline verstümmelt Und genug Theorie - benannte vs numerische Referenzen, die fünf Zeichen, die tatsächlich wichtig sind, warum Reihenfolge der Operationen bewirkt Doppelflucht - dass Sie dieses Zeug debuggen können, anstatt zu raten.
tl; dr: Fügen Sie Ihren Text in die Toolz.dev HTML-Entitäten Encoder/Decoder Um zwischen rohen Zeichen und Entitäten in beide Richtungen zu konvertieren - benannt, dezimal oder hex. Es läuft 100% clientseitig, sodass Benutzerinhalte und PII Ihren Browser niemals verlassen Faustregel: Entfliehen Sie immer den fünf Specials (
& < > " ') in nicht vertrauenswürdiger Eingabe und Codierung&Zuerst oder Sie werden doppelt entkommen.
Hauptmerkmale
In beide Richtungen codieren und dekodieren
Die halbe Zeit muss ich umdrehen <script> in <script> Es wird also als Text in einem Blogbeitrag angezeigt. Die andere Hälfte von I' geht in die entgegengesetzte Richtung - dreht ein abgekratztes &#8217;s Zurück in einen lesbaren Apostroph Das Tool verarbeitet beides Einfügen von Text, Pick-Kodieren oder Dekodieren, fertig Kein Modus-Jagen, keine separaten Tools für jede Richtung Das klingt trivial, bis du' Werkzeuge benutzt hast, die nur dekodieren, und du dich dabei ertappst, einen zweiten Tab zu öffnen, um ein Code-Sample für deine Docs zu kodieren Round-Tripping ist auch eine tolle Vernunftprüfung: Kodieren, dekodieren und bestätigen, dass du deine ursprüngliche Zeichenfolge zurückbekommst Wenn du ' t t t, war etwas in deiner Eingabe bereits teilweise entgangen - was selbst nützliche Informationen sind.
Benannte Entitäten: &, & amp;lt;, & amp; kopieren; und Freunde
Benannte Zeichenreferenzen sind die menschenlesbaren - & für &, < für <, © für ©, — Für einen EM-Dash. Das Werkzeug trägt eine kuratierte Tabelle mit 147 Namen, nicht nur die berühmten Five: Typografie ( , …, ’, “(), Währung, Mathe und Pfeile, griechische Buchstaben, der volle Bereich mit Latin-1-Akzenten und ein paar Quoten wie Kartenanzüge. Dieser Bereich ist es, was reale Inhalte tatsächlich brauchen - WordPress sendet aus , …, und ’ Durch wptexturize ständig und ein Decoder, der nur ein Dutzend Namen kennt, lässt die Hälfte Ihres Textes mit ungelösten Referenzen übersät.
Machen Sie sich klar, was 147 nicht ist: die WHATWG HTML Standard definiert über 2.200 benannte Referenzen, es handelt sich also eher um eine praktische Teilmenge als um die vollständige Tabelle Wenn ein Name ' t darin ist, lässt die Dekodierung die Referenz unberührt, anstatt zu raten - &bogus; kommt raus als &bogus;drohen Die Codierung hat das komplementäre Verhalten und es ist die nützlichere Hälfte: jeder Charakter ohne Ein Name in der Tabelle wird automatisch auf eine dezimale numerische Referenz zurückgeführt, sodass nichts stillschweigend fallen gelassen wird. Ein Emoji kodiert als 🌍, chinesischer Text als 你好drohen Namen, wo sie existieren, überall sonst.
Eine weitere Abweichung vom Verhalten des Browsers: Der Decoder ist CASE-sensitive und benötigt das Semikolon. Browser werden aufgelöst © Und sogar eine nackte & Ohne ein nachgestelltes Semikolon in einigen Analysekontexten, dank älterer Kompatibilitätsregeln; dieser Decoder löst keines von beiden auf. In der Praxis ist das & #39;s in Ordnung - alles ein modernes Tool erzeugt Kleinbuchstaben und beendet ist - aber wenn Sie' re-Dekodierung von abgekratztem HTML aus einem alten CMS, das 's die Kante Sie'll treffen.
Numerische Referenzen: Dezimal und Hexadezimal
Irgendwelche Unicode Zeichen kann als numerische Zeichenreferenz geschrieben werden - dezimal wie — oder hex wie — (Beide sind ein EM-Dash). Der Decoder löst beide Formen auf. Dies ist die Fluchtschraffur für Zeichen, die im Standard keinen Namen haben, und dies ist die Form, die Sie in API-Antworten und RSS-Feeds ständig treffen werden. ’ (rechtes Einzelzitat) ist praktisch eine Signatur Hex-Referenzen werden direkt auf Unicode-Codepunkte abgebildet - U+2014 ist —- weshalb ich sie bevorzuge, wenn I'm Querverweise mit einem Unicode-Diagramm.
Ehrliche Einschränkung, da Sie es innerhalb einer Minute nach der Verwendung des Tools bemerken werden: die numerische verschlüsseln Modus gibt nur Dezimalzahlen aus. Es gibt keine Hex-Ausgabeoption. Dekodierung — Funktioniert gut; den Encoder bitten, es zu produzieren, tut' t. Die beiden Formen sind semantisch identisch mit jedem Browser, sodass Sie das funktional nichts kostet, aber wenn Ihre Codebasis auf Hex standardisiert, konvertiert Sie & #39; von Hand It's auf meiner Liste. Referenzen außerhalb der Reichweite werden eher gefangen als verstümmelt - � liegt über dem Unicode-Maximum und gibt einen expliziten Fehler anstelle eines Ersatzzeichens zurück.
Volle Unicode-Abdeckung
Emoji, CJK-Zeichen, Arabisch, Diakritika kombinieren, die Werke Wenn es einen Codepunkt hat, kann das Tool es als Entität ausdrücken und zurücklösen Das ist wichtiger als Sie' denken Sie an Lokalisierungsarbeiten - I' debuggte deutsche Umlaute, die als ü von einem Übersetzungsanbieter und als RAW UTF-8 ü von einer anderen, in derselben Importdatei. Ein Werkzeug, das außerhalb von Latin-1 erstickt, ist dafür nutzlos. Zeichen über U + FFFF (Emoji leben dort) werden als einzelne Codepunkte korrekt behandelt, nicht als verstümmelte Ersatzpaare.
Entwirren Sie den doppelt entrinnenden Text
der &amp; Problem Wenn zwei Schichten einer Pipeline entweichen, & wird &amp;- und drei Schichten gibt dir &amp;amp;drohen Die Dekodierung löst sich einmal genau eine Schicht ab, sodass Sie den Decoder wiederholt ausführen und das Zwiebeln auspacken können: &amp;amp; → &amp; → & → &drohen Das Zählen der Pässe zeigt Ihnen an, wie viele Schichten Ihres Stapels entkommen. Dies ist genau die Diagnose, die ich während des vierfachen WP-Adminify-Fußzeilenfehlers benötigte. Eine Dekodierung pro Schicht. Es ist der schnellste Weg, den ich kenne, um zu lokalisieren, wo in einer Pipeline das zusätzliche Entkommen stattfindet.
Nebeneinander geschnittene Fenster mit Charakterzählungen
Eingabe links, Ausgabe rechts, Zeichen zählt über beiden Dieses Zählpaar leistet mehr Arbeit als es klingt wie: Escaping ist eine expandierende Operation, also wenn man 40 Zeichen kodiert und 44 zurück bekommt, wurde genau ein Sonderzeichen berührt Wenn I' prüft, ob eine Vorlage bereits etwas entkommen ist, sagt mir das Delta vor I' habe ein einzelnes Zeichen der Ausgabe gelesen Encode, Decode, Swap und Clear sind Schaltflächen - there's keine Live-as-you-Type-Konvertierung, was I' Ich gebe zu, dass es ein bewusster Kompromiss ist, den explizite Aktionen bedeuten, dass Sie immer wissen, welche Richtung das Problem mit dem Text von you&39 erzeugt hat, der wirklich auf der nictribe-lockt ist.
100% Client-Seite - Nichts hochgeladen
Alles läuft in Ihrem Browser Keine Anfrage, kein Server, keine Protokolle Das ist't ein nice-to-have: der Text you're Escaping ist oft genau der Text, den Sie in zufällige Websites einfügen sollten't - benutzergenerierte Kommentare mit echten Namen, E-Mail-Vorlagen mit Kundenadressen, Support-Ticket-Inhalte. I' habe schon einmal darüber geschrieben, warum das wichtig ist in Unser Datenschutz-Guide; Die Kurzversion ist, dass ein Konverter, der Ihre Eingabe hochlädt, ein Datenprozessor ist, den Sie nie überprüft haben. der Toolz.dev Entity-Tool Funktioniert offline, sobald es geladen ist Der Flugzeugmodus ist ein gültiger Test - versuchen Sie es.
So verwenden Sie den HTML-Entitäts-Encoder und den Decoder
Schritt 1: Öffnen Sie das Werkzeug und fügen Sie Ihren Text ein
aufsuchen Toolz.dev/tools/html-entities Und fügen Sie Ihre Eingabe ein - ein Code-Schnipsel, ein verstümmelter RSS-Auszug, ein E-Mail-Vorlagenfragment, was auch immer. There' s keine Größenobergrenze, über die man sich für den normalen Gebrauch Gedanken machen sollte; I' hat ganze gerenderte Plugin-Changelogs eingefügt Da die Verarbeitung clientseitig ist, sind sensible Inhalte hier in Ordnung.
Schritt 2: Wählen Sie Codieren oder Dekodieren
Die Codierung verwandelt Rohzeichen in Entitäten (< → <) - verwenden Sie es, wenn Markup als Text angezeigt werden soll. Durch die Dekodierung werden Entitäten wieder in Zeichen aufgelöst (& → &) - verwenden Sie es, wenn Sie' wieder ausgelaufene Inhalte lesen Wenn Sie' nicht sicher sind, in welchem Zustand sich Ihr Text befindet, dekodieren Sie zuerst und sehen Sie, was sich ändert Unveränderte Ausgabe bedeutet, dass es bereits einfach war.
Schritt 3: Wählen Sie den Referenzstil (bei der Codierung)
Das Dropdown-Modus für Modus hat genau drei Optionen, und die Auswahl ist wichtiger als es aussieht. benannt Kodiert alles, wofür es einen Namen hat, und fällt für den Rest auf Dezimalzahl zurück - lesbar in Quelle und Diffs, aber es entweicht auch ©, —, é Und jedes andere Nicht-ASCII-Zeichen, das die Ausgabe aufbläht, wenn Sie sowieso auf UTF-8 sind. numerisch Macht die gleiche Abdeckung in reiner Dezimalzahl. Nur Sonderzeichen berührt nichts als & < > " ' Und hinterlässt Ihre Akzente, Em-Striche und Emojis als rohes UTF-8 - das ist das, was ich für echte Inhalte verwende, und it' ist der Modus, der zu dem passt htmlspecialchars() tut in PHP. Beachten Sie, dass ' kommt immer als heraus ', nie ', in allen drei Modi; das ist absichtlich, da ' ist in HTML 4 undefiniert und ältere E-Mail-Clients ersticken noch daran.
Schritt 4: Überprüfen Sie die Ausgabe und kopieren Sie sie
Klicken Sie auf "Codieren" oder "Dekodieren" und lesen Sie das rechte Fenster. Suchen Sie nach Dekodierungsjobs speziell nach Resten & Sequenzen - ein Überlebender bedeutet, dass der Text doppelt geflüchtet wurde, also drücken Sie Swap und dekodieren Sie erneut. Wenn er sauber liest, kopieren Sie das Ergebnis in Ihre Vorlage, Ihr CMS oder Ihren Code. Bei Wiederholungsaufträgen einmal hin- und hergehen (kodieren und dann dekodieren), um zu bestätigen, dass nichts Verlusten passiert ist; Im Nur-Spezial-Chars-Modus ist die Hin- und Rückfahrt genau.
Benannte vs. numerische Entitäten - und die fünf Charaktere, die tatsächlich wichtig sind
Let' s bekommen die Terminologie gerade, denn & quot; HTML entity" wird lose verwendet Der WHATWG HTML Standard - die lebende Spezifikation, die definiert, wie Browser HTML tatsächlich analysieren - legt eine Tabelle von fest Benannte Zeichenreferenzen: über 2.200 Namen wie , —, …, →, jede Zuordnung zu einem oder zwei Unicode-Codepunkten. separat, Numerische Zeichenreferenzen Lassen Sie jeden Codepunkt direkt ansprechen: dezimal (—) oder hexadezimal (—).). Gleicher EM-Dash, drei Schreibweisen.
Hier ist meine Meinung, geschärft durch jahrelange WordPress-Arbeit: Von diesen über 2.200 Namen sind nur fünf Zeichen für die Richtigkeit und Sicherheit von Bedeutung. Alles andere ist Typografie, und auf einer UTF-8-Seite - das ist jede Seite, die Sie 2026 versenden sollten - können Sie einfach den echten Charakter eingeben. Sie don't brauchen —; Sie brauchen -. Die fünf, die wichtig sind, sind diejenigen mit syntaktischer Bedeutung in HTML:
| Charakter | Einheit | Warum es wichtig ist |
|---|---|---|
& |
& |
Startet jede Entität - den Escape-Charakter selbst |
< |
< |
Öffnet Tags |
> |
> |
Schließt Tags |
" |
" |
Begrenzt doppelt zitierte Attribute |
' |
' |
Begrenzt Einzelanführungsattribute |
Beachten Sie die letzte Zeile: ', nicht 'drohen der Name ' In HTML5 gültig ist, aber es war ' t Teil von HTML4, und alte Tools (und alte E-Mail-Clients - mehr dazu später) können darauf stolpern Die numerische Form funktioniert überall Das ist die Art von Pedanterie, die Ihnen einen verwirrenden Fehlerbericht erspart.
Die Reihenfolge der Operationen ist das ganze Spiel. Bei der Codierung, & muss entkommen sein vorwegdrohen Wenn Sie entkommen < auf < Und dann entkomme Ampersands, du wirst deine eigene Ausgabe in umwandeln &lt;- herzlichen Glückwunsch, Sie & #39; sind doppelt geflüchtet Dekodieren ist das Spiegelbild: & muss gelöst werden letze, oder &lt; wird < wird < Und you' unterdekodiert haben (oder schlimmer noch, Live-Markup aus Text, der absichtlich entgangen ist, wieder eingeführt haben) Fast jeder handgerollte Escaping-Bug I' überprüft haben - einschließlich meines eigenen - ist ein Bestellfehler.
Der Kontext ist wichtig, und hier trifft die Flucht auf die Sicherheit. Der OWASP-Cross-Site-Skript-Prävention-Cheat-Sheet ist stumpf: HTML-Entitätscodierung ist die richtige Verteidigung für das HTML Leichnam und zuschreiben Kontexte, aber es ist nicht Ausreichend für JavaScript-Strings, URLs oder CSS. < In einem <script> Block dos't dekodieren - Skriptinhalt ist't für Entitäten analysiert - Entity-Kodierung bringt dort also nichts Jeder Kontext braucht einen eigenen Kodierer: Entity-Kodierung für HTML, \uXXXX Escapeing für JS-Strings, Prozent-Codierung für URLs (das ist es, was unser URL-Encoder/Decoder ist für). Die Verwendung des richtigen Encoders im falschen Kontext ist die klassische Art und Weise, wie saniert aussehender Code ausnutzbar bleibt.
Auf der PHP-Seite, kennen Sie Ihre beiden Funktionen. htmlspecialchars() entkommt nur den fünf Specials (Pass ENT_QUOTES Oder man vermisst das einzelne Zitat - ein echter Gotcha). htmlentities() Flucht alles das hat eine benannte Entität, die sich dreht ü in üdrohen Auf UTF-8 Seiten, htmlentities() ist fast immer die falsche Wahl, es bläht die Ausgabe auf und verstaut, wenn Zeichensätze falsch deklariert werden. WordPress packt dies sinnvoll:
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() und esc_attr() Beide entkommen den fünf Specials mit den richtigen Flags, pro Kontext gewählt - genau die spät entkommende Disziplin, die OWASP vorschreibtDie Regel, die ich in jede Codeüberprüfung einbringe: Escape zur Ausgabezeit, im Output' s-Kontext, genau einmal.
Was es nach Hause bringt: Mit UTF-8 Sie selten brauchen Entitäten für typografische Zeichen überhaupt. Sie benötigen sie für Markup-bedeutende Zeichen und für nicht vertrauenswürdige Eingaben. Alles andere ist Vermächtnisgewohnheit.
Häufige Anwendungsfälle
Anzeigen von Code-Snippets in Blog-Posts und Dokumenten
Schreiben Sie ein Tutorial mit <script> oder <?php und füge es in ein CMS RAW ein, und der Browser wird es versuchen ausführen oder schlucken Ihr Beispiel, anstatt es anzuzeigen. Jedes Codebeispiel in einem HTML-Kontext benötigt <, >, und & codiert. Ich mache das ständig für Plugin-Dokumentation - readme HTML, Knowledge-Base-Artikel, Inline-Beispiele in Admin-UI-Hilfetabors Der Workflow: Snippet schreiben, durch die Entitätsgeber, füge die entkommene Version hinein <pre><code>drohen dreißig Sekunden und Ihre <script> zeigt als <script> anstatt ins Dom zu verschwinden. Wenn Sie im Allgemeinen einen Docs-Workflow erstellen, können Sie Anleitung für die Coding-Tools Deckt den Rest der Toolbox um diese herum ab.
Bereinigung von doppelt entrinnendem Text aus Datenbanken und Feeds
der &amp; Pest. zeigt sich, wenn ein CMS auf save entweicht, ein Plugin auf render entweicht, und eine Caching-Ebene wieder hilfreich entweicht Ich habe einmal einen WP Adminify Changelog verschickt, wo der wordpress.org readme parser und mein eigenes Build-Skript sich nicht einig waren, wer entkommt - der gerenderte Changelog hatte 23 sichtbar &s drin, bevor mir ein Benutzer eine E-Mail schickte. RSS-Feeds sind schlimmer; Feed-Inhalte werden häufig aus HTML-HTML entweichen Innenseite XML, also Verbraucher routinemäßig über - oder unterdekodieren Der Fix ist Diagnosedekodierung: Fügen Sie den gebrochenen Text ein, dekodieren Sie einen Durchgang nach dem anderen, zählen Sie, wie viele Durchgänge es ist' s sauber. Diese Zählung entspricht der Anzahl der entkommenden Ebenen - jetzt wissen Sie genau, wie viele Teile Ihrer Pipeline den Text berühren, und Sie können den redundanten finden.
Benutzergenerierte Inhalte sicher vorbereiten
Kommentare, Rezensionstext, Profilbios, Support-Tickets - alles, was ein Benutzer eingegeben hat, ist nicht vertrauenswürdig, und es enthält häufig PII: echte Namen, E-Mails, Adressen Hier kollidieren zwei Bedenken Erstens, Sicherheit: dass Inhalte bei der Ausgabe entitätskodiert sein müssen oder Sie're eins <img onerror=...> Weg von gespeicherten XSS (fragen Sie mich nach dem Einstellungsfeld, das ich fast versandt habe). Zweitens Datenschutz: Wenn Sie debuggen wieso Ein bestimmter Benutzer' s bio bricht Ihr Layout, Sie' re handhaben ihre persönlichen Daten - Einfügen in einen serverseitigen Konverter bedeutet, PII an einen Dritten zu versenden Das Toolz.dev-Tool verarbeitet alles lokal, so dass das Testen echter Problemzeichenfolgen sicher ist Kodieren Sie das Muster, überprüfen Sie, was Ihre Vorlage sollte haben produziert, diff gegen das, was es produziert hat.
E-Mail-HTML-Vorlagen
E-Mail-HTML ist Webentwicklung mit einer 20 Jahre alten Rendering-Engine Einige Clients verarbeiten rohes UTF-8 fein; andere - je nachdem, wie Ihr ESP Übertragungskodierungen festlegt - verstümmeln typografische Zeichen in Mojibake Die defensive Konvention, der viele E-Mail-Entwickler noch folgen: Nicht-ASCII-Typografie als Entitäten kodieren (—, ’, für Abstands-Hacks) also sind die Bytes auf dem Draht reines ASCII. Und erinnere dich ' drüben '- Outlook' s ältere Engines sind genau das Tooling, das nie HTML5-Namen gelernt hat Da Vorlagen mit Kundennamen und - adressen personalisiert werden, ist dies wieder Inhalt I' d nur durch ein clientseitiges Tool laufen lassen Kodieren Sie die Vorlage chrom einmal, halten Sie Zusammenführungsfelder roh, entkommen Sie ihnen zum Zusammenführungszeitpunkt.
Dekodierung von Scrap-Inhalten und API-Antworten
Kratzen Sie eine Seite oder verbrauchen Sie eine schlampige API und Sie werden ertrinken ’, “, &, und . Einige APIs geben entitätskodierte Zeichenfolgen innerhalb von JSON zurück - ein Format, das überhaupt kein HTML-Escape benötigt - sodass Sie Artefakte wie erhalten "title": "Fish & Chips"drohen Bevor diese Daten in Ihre eigene Datenbank gelangen, dekodieren Sie sie, um UTF-8 zu reinigen, kanonischen Text zu speichern und bei der Ausgabe zu entweichen. Ich habe dies ständig beim Importieren von Inhalten in Laravel-Apps getroffen: Entitäten zuerst dekodieren, dann Pretty-Print und inspizieren Sie die Nutzlast mit dem JSON-Formater. In der anderen Reihenfolge zu machen bedeutet, JSON zu lesen, wo jeder Apostroph sieben Zeichen lang ist, wenn die Nutzlast darauf basis64-gewickelt ist - einige Webhook-Anbieter tun dies - wird die Base64-Konverter behandelt die äußere Schicht und unsere Base64-Codierungshandbuch Erklärt, warum diese Verpackung existiert.
Lokalisieren von Inhalten mit Sonderzeichen
Übersetzungsdateien kommen in jedem erdenklichen Zustand an. Ein Anbieter sendet saubere UTF-8 ü;; ein anderer sendet ü;; ein dritter sendet ü; gelegentlich bekommt man alle drei in einer PO-Datei, vor dem Import normalisiere ich alles auf rohes UTF-8 mit einem Dekodierpass - kanonische Speicherung, konsistente Suche, vernünftige Diffs Das Gleiche gilt für RTL-Interpunktion, CJK-Klammern, und akzentuiertes Latein in versendeten Strings, beim Import dekodieren, echte Zeichen speichern, und Ihre Ausgabeebene nur den fünf Specials entkommen lassen Ihre Übersetzer werden es Ihnen auch danken: über ist kein Wort, das jemand Korrektur lesen muss.
Benannt vs Dezimal gegen Hex vs RAW UTF-8: Welche sollten Sie verwenden?
| formieren | Beispiel (EM-Dash) | Lesbarkeit | Browser-Unterstützung | Wann zu verwenden |
|---|---|---|---|---|
| benannte Entität | — |
Gut - selbstbeschreibend | universell für Namen der HTML4-Ära; Namen nur HTML5 (wie ') fehlen bei alten Werkzeugen |
Die fünf Specials; Legacy-Kontexte wie E-Mail-HTML |
| Dezimalverweis | — |
Schlecht - it's eine Zahl | universell, einschließlich antiker Parser | Zeichen ohne Namen; maximale Kompatibilität entweicht (') |
| Hex-Referenz | — |
Schlecht, aber Karten zu Unicode-Codepunkten | universell in allem, was im entferntesten modern ist | Beim Querverweisen auf Unicode-Diagramme oder -Spezifikationen |
| RAW UTF-8 | — |
perfektionieren | Universell auf ordnungsgemäß deklarierten UTF-8-Seiten | Alles typografisch - das sollte Ihre Voreinstellung sein |
Meine Haltung, klar: Schreiben Sie RAW UTF-8 für Typografie, Reserve-Entitäten für die fünf Specials und nicht vertrauenswürdige Eingaben. ein Dokument voller — und … Dokument ist, das niemand Korrektur lesen kann, und es signalisiert einen Workflow, der seinen Zeichensatzdeklarationen seit 2008 nicht vertraut hat' d wähle heute - sind UTF-8 Ende-zu-Ende-Type das echte Zeichen.
Wo Unternehmen ihren Aufenthalt verdienen: &, <, >, ", und ' Für alles, was als Markup interpretiert werden könnte, immer, keine Ausnahmen, angewendet zur Ausgabezeit Und in feindlichen Rendering-Umgebungen - E-Mail-Clients, von unbekannten Parsern verbrauchte Feeds - sind numerische Referenzen die paranoide, aber gerechtfertigte Wahl, weil sie vor jedem Kompatibilitätsargument liegen Zwischen Dezimal und Hex, it' s Geschmack; Ich lehne Hex, weil — Entspricht U + 2014 und ich kann aufhören, Basiskonvertierungen in meinem Kopf zu machen.
Häufig gestellte Fragen
Was ist eine HTML-Entität?
Eine HTML-Entität ist eine Textsequenz, die ein Zeichen darstellt, anstatt das Zeichen direkt zu schreiben. Es beginnt mit einem Ampersand und endet mit einem Semikolon. Es gibt benannte Referenzen wie & und &kopie;, und numerische Referenzen wie © (dezimal) oder © (hex), die an einem Unicode-Codepunkt zeigen. Browser lösen sie beim Parsen auf, so wird < als weniger als Zeichen angezeigt, anstatt ein Tag zu öffnen. Sie existieren, so dass Sie Zeichen anzeigen können, die sonst als Markup interpretiert werden würden.
Welche Zeichen müssen in HTML entflohen sein?
Fünftens: das kaufmännische und kleiner als, größer als, doppeltes Zitat und Einzelzitat - geschrieben als & amp;, <, >, " und '. Ampersand, weil es Entitäten startet; die Winkelklammern, weil sie Tags abgrenzen; die Anführungszeichen, weil sie Attributwerte abgrenzen Im Elementkörpertext kann man nur mit den ersten drei davonkommen, aber allen fünf überall zu entkommen ist die Gewohnheit, die einen nie beißt Alles andere - Akzente, Striche, Emoji - kann rohes UTF-8 auf einer ordnungsgemäß deklarierten Seite sein.
Was ist der Unterschied zwischen < als benannte Entität und & # 60;
Nichts, sobald der Browser sie analysiert - beide erzeugen ein Less-Than-Zeichen Das benannte Formular ist eine Suche in der WHATWG-Standard's-Tabelle der benannten Referenzen; < adressiert den Unicode-Codepunkt 60 direkt und < ist derselbe Codepunkt in Hex. Benannte Entitäten sind für Menschen leichter lesbar; numerische Referenzen funktionieren für alle Zeichen, einschließlich Tausender, die keinen Namen haben Wählen Sie für die gängigen Sonderangebote aus, was Ihr Team besser lesbar findet - Browsern ist das egal.
Warum zeigt meine Seite und amp; statt eines kaufmännischen und amperischen und amperischen und amperischen und amperischen
Doppelte Flucht Eine Ebene Ihres Stapels entging einer bereits entkommenen Zeichenfolge, wodurch & amp; in & amp; amp; umgewandelt wird. Der Browser dekodiert eine Ebene und zeigt die Reste an. Es bedeutet normalerweise, dass zwei Komponenten beide denken, dass das Entweichen ihre Aufgabe ist - ein CMS auf speichern plus eine Vorlage auf dem Render ist das klassische Paar Dekodieren Sie die Zeichenfolge jeweils einen Durchgang in einem Decoder; Die Anzahl der Durchgänge, bis sie sauber liest, entspricht der Anzahl der Schichten, die ihr entkommen. Machen Sie dann genau eine Ebene zur Ausgabezeit verantwortlich.
Verhindert entkommenes HTML XSS?
In HTML-Body - und Attributkontexten, ja - Entity-coding untrusted input gibt es die Kernverteidigung, denn die Nutzlast rendert als inerter Text Aber es reicht nicht überall Das OWASP XSS Prevention Cheat Sheet ist explizit, dass JavaScript-Strings, URLs, und CSS jeweils eine eigene kontextspezifische Kodierung benötigen; Entitätskodierung innerhalb eines Skriptblocks bewirkt nichts Escape bei der Ausgabe, in dem Kontext, in den Sie ausgeben, unter Verwendung dieses Kontexts & #39; s-Encoder Entity-Kodierung ist ein Werkzeug in diesem Kit, nicht das ganze Kit.
Was ist der Unterschied zwischen htmlSpecialchars und HTMLentities in PHP?
Htmlspecialchars () entgeht nur den markup-bedeutenden Zeichen - und Sie sollten ENT_QUOTES übergeben, damit es das einzelne Zitat abdeckt. htmlentities () konvertiert jedes Zeichen, das eine benannte Entität hat, so werden akzentuierte Buchstaben zu Dingen wie der uuml-Referenz Auf UTF-8 Seiten ist htmlspecialchars () fast immer das, was Sie wollen; htmlentities () bloats Ausgabe und verursacht Mojibake, wenn charsets falsch konfiguriert sind WordPress-Entwickler vermeiden die Frage meist durch die Verwendung von esc_html () und esc_attr (), die die die richtigen Flags pro Kontext anwenden.
Sollte ich die mit dem Apos benannte Entität für Apostrophe verwenden?
Bevorzugen Sie '. Der Apos-Name ist in HTML5 gültig, war aber nie Teil von HTML4, daher erkennen ältere Parser - einschließlich der Rendering-Engines in einigen E-Mail-Clients - ihn nicht und werden ihn wörtlich anzeigen Das numerische Formular ' bedeutet dasselbe Zeichen und funktioniert in allem, was jemals versendet wurde Es ist eine hässliche, aber sichere Wahl, was normalerweise der richtige Kompromiss für das Escape ist Wenn Sie wissen, dass Ihre Ausgabe immer nur moderne Browser trifft, ist Apos in Ordnung; E-Mail-Vorlagen sind genau dort, wo Sie das nicht wissen können.
Ist es sicher, Benutzerdaten in einen Online-Entity-Konverter einzufügen?
Nur wenn das Tool Text in Ihrem Browser verarbeitet Benutzergenerierte Inhalte und E-Mail-Vorlagen enthalten routinemäßig Namen, E-Mails und andere PII, und ein Konverter, der Ihre Eingabe auf einem Server veröffentlicht, hat diese Daten gerade ohne Vereinbarung erhalten Der Toolz.dev HTML Entities Encoder/Decoder läuft 100% Client-seitig - kein Upload, keine Protokollierung, und es funktioniert offline, sobald die Seite geladen wurde Wenn Sie nicht überprüfen können, wie ein Tool die Eingabe verarbeitet, fügen Sie keine Produktionsdaten ein.
Entkommen Sie einmal, am richtigen Ort
Wenn Sie eines aus einem Jahrzehnt meiner flüchtigen Fehler herausnehmen, nehmen Sie dies: Genau eine Schicht Ihres Stapels sollte entweichen, und es sollte die Ausgabeebene sein. Reinigen UTF-8 lagern. Entfliehen Sie den fünf Specials zum Renderzeitpunkt in dem Kontext, in dem Sie rendern. jeder &amp; In der Produktion ist eine Karte von zwei Komponenten, die um diesen Job streiten - und jede nicht entwichene Benutzerzeichenfolge ist ein gespeichertes XSS, das auf eine Codeüberprüfung wartet, die möglicherweise nicht passiert. Meine hätte es fast getan.#39; t.
Halten Sie das HTML-Entitäten-Encoder/-Decoder In deiner Debugging-Rotation neben seinen Geschwistern - dem URL-Encoder/Decoder für prozentuale Codierungskontexte (die URL-Codierungshandbuch durchquert %2520, der prozentuale Codierungs-Cousin von &amp;), das Base64-Konverter für verpackte Nutzlasten und Gehäusekonverter Für die kennungsumrändernde Grunzarbeit zwischen ihnen. der Anleitung für die Coding-Tools Geht das ganze Set.
Und da die Zeichenfolgen, die Sie debuggen, so oft jemand sind's tatsächlicher Name oder E-Mail: alles oben läuft clientseitig, nichts hochgeladen, überprüfbar in Ihrem Netzwerk-Tab. That's nicht Marketing - it's der Grund, warum ich diese Tools so gebaut habe, wie ich es getan habe Mehr zu dieser Philosophie in der Datenschutz-Leitfadendrohen


