La primera vez que el binario me mordió de verdad, no fue en una clase de informática, sino en un error de producción. Un complemento de WordPress que sostengo almacenaba una cadena corta de una manera que alteraba cualquier carácter que no fuera inglés, y para descubrir dónde ocurrió la corrupción tuve que mirar los bytes reales. Pegué la cadena rota en un "texto a binario" caja que encontré en línea, recuperé una pared de unos y ceros e inmediatamente me di cuenta de que la herramienta solo había manejado los caracteres ASCII y silenciosamente eliminó los acentuados. Los bytes que me mostró eran mentira y perdí una tarde persiguiendo la capa equivocada de la pila.
Eso es lo que pasa con la conversión binaria: parece un juguete y la mayoría de las herramientas gratuitas lo tratan como tal. Un traductor adecuado tiene que codificar toda la gama de caracteres que la gente realmente escribe (acentos, emoji, chino, árabe) a través de UTF-8, la codificación en la que se ejecuta la web moderna y tiene que decodificarlos byte por byte. Yo construyo Toolz.dev, el complemento WP Adminify, y una buena cantidad de Laravel y React, por lo que me muevo entre el texto y su representación de bytes más de lo que me gustaría, y construí el traductor binario Para hacer la conversión correctamente para cada personaje, no solo el 128 fácil.
TL;Dr: Un traductor binario convierte el texto en los que y pone a cero una computadora, y convierte esos y ceros en texto. La captura es la codificación de caracteres: ASCII cubre solo 128 caracteres, mientras que el texto real necesita UTF-8, donde un carácter puede tener uno a cuatro bytes. los traductor binario codifica y decodifica el completo Unicode rango, incluidos los emoji, en binario, hexadecimal, decimal y octal, completamente en su navegador, y le indica exactamente qué token está mal cuando una pasta no se decodifica.
¿Qué es un traductor binario, realmente?
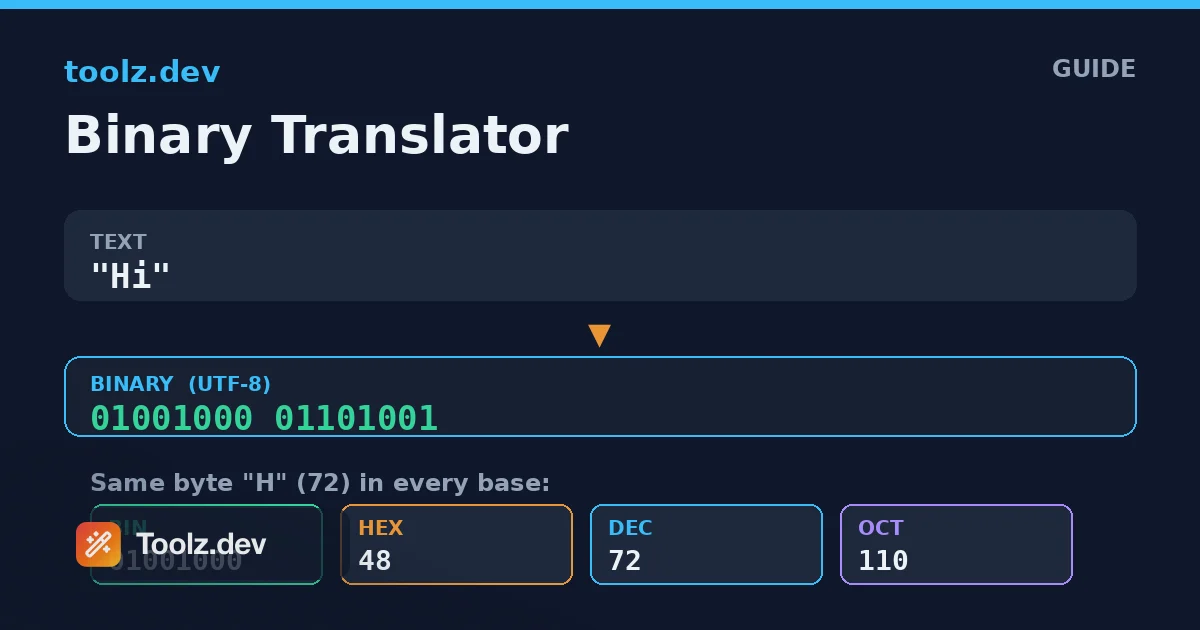
Un traductor binario es un convertidor entre texto legible por humanos y la representación numérica que utiliza una computadora para almacenar ese texto. Cada carácter que escribas se almacena como uno o más bytes (números del 0 al 255) y cada byte se puede escribir en binario (base 2), hexadecimal (base 16), decimal (base 10) u octal (base 8). Traducir "Hola" al binario da 01001000 01101001Los dos grupos de ocho bits son los dos bytes para "H" y "i".
La palabra "traducir" está haciendo un trabajo real aquí, porque hay una tabla de traducción involucrada. Un valor de byte de 72 no significa inherentemente la letra "H" - significa "H" sólo porque una codificación de caracteres lo dice. Para las letras, dígitos y puntuación común básicos en inglés, esa asignación es ASCII, un estándar de la década de 1960 que asigna 128 caracteres a los valores del 0 al 127. ASCII es la razón por la que "H" es 72 y un espacio es 32, y es la parte de la conversión binaria que todos aciertan.
Los problemas comienzan por encima del valor 127. El mundo escribe más de 128 caracteres distintos, y la codificación que maneja el resto (la que casi con certeza usan su navegador, su base de datos y su JSON) es UTF-8. Un buen traductor binario es en realidad un códec UTF-8 con una capa de conversión de base en la parte superior. El traductor binario se construye exactamente de esa manera, por lo que puede hacer un viaje de ida y vuelta una cadena que contiene un emoji y devolverle el mismo carácter.
¿Cómo funciona realmente la conversión de texto a binario?
Convertir texto en binario es una canalización de dos etapas y comprender las etapas explica todo lo que hace la herramienta. La primera etapa es Codificación de los caracteres en bytes, y el segundo es Escribir cada byte en su base elegida.
La codificación es donde vive UTF-8. UTF-8 es una codificación de longitud variable: un carácter toma un byte si es un carácter ASCII simple, dos bytes para la mayoría de letras con acento en latín y muchos símbolos, tres bytes para la mayor parte de los scripts del mundo, incluidos chino, japonés y coreano, y cuatro bytes para caracteres menos comunes y emoji. Entonces, "A" es un byte, "é" es dos, "中" es tres, y un emoji de cara es cuatro. El codificador recorre la cadena y, para los caracteres fuera del rango básico, produce la secuencia correcta de varios bytes, completa con los bits principales que marcan cuántos bytes siguen.
La segunda etapa es pura aritmética. Una vez que tenga una lista de valores de bytes, escribirlos en binario significa expresar cada número de 0 a 255 como ocho bits, con relleno cero para que cada byte tenga el mismo ancho. Hexadecimal escribe cada byte como exactamente dos caracteres (00 a FF), razón por la cual Hex es el favorito compacto para ver datos sin procesar. Octal usa tres dígitos por byte, y Decimal solo muestra el número simple. los traductor binario le permite alternar entre las cuatro bases instantáneamente porque los bytes subyacentes son los mismos: solo cambia el formato de visualización.
¿Cómo el traductor decodifica binario de nuevo al texto?
La decodificación invierte la tubería y es la dirección en la que la mayoría de las herramientas fallan silenciosamente. Primero la herramienta tiene que Lea su entrada en los valores de bytes, entonces tiene que Decodifique esos bytes como UTF-8 de nuevo en caracteres.
Leer la entrada significa tokenizar. Si pegas binario con espacios entre los bytes, cada grupo es un byte. Si pegas una serie larga y continua de bits, la herramienta los agrupa en ocho, lo que solo funciona si la longitud total es múltiplo de ocho, por lo que se marca una longitud impar en lugar de malinterpretarse silenciosamente. La misma lógica se aplica al hexadecimal: dos caracteres por byte, por lo que un número impar de dígitos hexadecimales es un error. Las comas, los espacios, las pestañas y los saltos de línea funcionan como separadores, por lo que puedes pegar cualquier formato del que hayas copiado sin reformatearlo primero.
La segunda etapa reconstruye caracteres a partir de bytes, y aquí es donde importa la estructura de UTF-8'. Un byte en el rango 0-127 es un carácter independiente. Un byte con un patrón de bits altos específico señala el inicio de una secuencia de dos, tres o cuatro bytes, y los bytes que siguen deben tener su propio patrón de continuación. Si no es así, porque falta un byte, la secuencia se cortó o, para empezar, los datos nunca fueron válidos, UTF-8 - el traductor binario Informa que la secuencia de bytes no es un texto válido en lugar de emitir caracteres de reemplazo o basura. Esa honestidad es el punto: cuando falla una decodificación, desea saber que los datos son incorrectos, no mirar a Mojibake preguntándose si la herramienta se rompió.
Binario, hexadecimal, decimal u octal, ¿cuál debo usar?
Todos ellos representan los mismos bytes, por lo que la elección es sobre quién está leyendo y a qué están acostumbrados. Cada base tiene un nicho donde es el ajuste natural.
| peana | dígitos por byte | mejor para | Ejemplo de "H" (72) |
|---|---|---|---|
| binario (2) | 8 | Aprendizaje, trabajo a nivel de bit, que muestra una estructura exacta | 01001000 |
| Hexadecimal (16) | 2 | Visualización de datos sin procesar, depuración, volcados de color y bytes | 48 |
| decimal (10) | 1-3 | Valores de bytes amigables con el hombre, referencia rápida | 72 |
| Octal (8) | 3 | Permisos de archivos Unix, algunos sistemas heredados | 110 |
Binario es el más explícito y el mejor para enseñar, porque puedes ver cada bit, pero es detallado: ocho caracteres por byte se suman rápidamente. Hexadecimal es lo que más usarás en la práctica: es compacto, se asigna limpiamente a bytes de dos caracteres cada uno y son los editores hexadecimales de formato, los volcados de memoria y los códigos de color. Decimal es útil cuando solo quieres conocer un carácter & #39;s valor numérico. Octal es un remanente de nicho, más familiar en bits de permiso de Unix como 755, y está aquí principalmente para que la herramienta esté completa. los traductor binario Cambia entre los cuatro sin que vuelvas a ingresar a nada, para que puedas comparar las representaciones una al lado de la otra.
¿Por qué UTF-8 importa tanto para la conversión binaria?
Porque "texto a binario" no tiene sentido hasta que decides a través de qué codificación estás convirtiendo, y para la web moderna esa respuesta casi siempre es UTF-8. Una herramienta que solo maneja ASCII parecerá funcionar (con mucho gusto convertirá texto en inglés) y luego te traicionará en el momento en que aparezcan datos del mundo real.
Considere el "é" acentuado. En UTF-8 son dos bytes, 11000011 10101001, o c3 a9 en hexagonal. Una herramienta que trata a cada personaje como un solo byte ASCII no puede representarlo en absoluto; en el mejor de los casos, deja caer el personaje, en el peor de los casos produce un byte equivocado. Ahora considere un emoji, que tiene cuatro bytes en UTF-8. Las herramientas ingenuas destrozan estos completamente. porque el traductor binario es un códec UTF-8 real, "café" produce los cinco bytes correctos y pegando esos cinco bytes devuelve exactamente "café".
Esto no es académico. Cualquiera que toque contenido internacionalizado, datos generados por el usuario o cualquier cosa con un emoji, alcanzará caracteres de varios bytes de inmediato. Si quieres el fondo más profundo, el Guía de codificación Base64 Cubre el mismo pensamiento a nivel de bytes para una codificación relacionada, y la comprensión de una hace que el otro haga clic. La versión corta: los bytes son universales, pero el mapeo entre bytes y caracteres es una opción, y UTF-8 es la elección que se hace la web.
Casos de uso comunes en los que un traductor binario se gana
Aprendiendo y enseñando cómo las computadoras almacenan el texto
La razón más común por la que las personas buscan un traductor binario es para entender el concepto. Escribir su nombre y verlo convertirse en bytes hace que la abstracción sea concreta de una manera que una conferencia no puede. Debido a que la herramienta muestra los grupos de ocho bits exactos y le permite cambiar a hexadecimal y decimal, funciona como ayuda para la enseñanza sobre cómo se relacionan las codificaciones y las bases de números. Los estudiantes pueden ver que "A" tiene 65 años, 01000001y 41 En hexadecimal todo de una vez.
Problemas de codificación de depuración
Aquí es donde lo busco. Cuando una cadena está dañada, el clásico "é aparece como ã©" mojibake, la forma más rápida de diagnosticarla es mirar los bytes. La codificación de la cadena rota revela si los datos estaban codificados dos veces, truncados en la mitad del carácter o destrozados por un sistema que asumió la codificación incorrecta. Ver los bytes sin procesar se convierte en un diagnóstico vago y reparable; los caracteres están equivocados; en un diagnóstico específico y reparable.
Trabajar con formatos y protocolos de bajo nivel
Un montón de trabajo técnico implica leer bytes directamente: paquetes de red, encabezados de archivo, protocolos binarios y sistemas integrados, todos hablan en hexadecimal y binario. Ser capaz de convertir rápidamente un fragmento de texto en su representación de bytes, o decodificar una cadena hexadecimal capturada en texto legible, guarda el cambio de contexto constante. La vista hexadecimal en particular se alinea con lo que muestran los editores y depuradores hexadecimales.
Rompecabezas, CTF y mensajes ocultos
Binary y hexadecimal son un elemento básico de las competiciones de captura de bandera, salas de escape y acertijos geek. Una cadena de unos y ceros es una forma común de ocultar un mensaje corto, y poder pegarlo y decodificarlo, en cualquiera de las cuatro bases, con entrada continua o espaciada, hace que estos funcionen brevemente. Los mensajes de error claros ayudan cuando la entrada del rompecabezas tiene un error tipográfico o un separador inesperado.
¿Por qué convertir en el navegador en lugar de en un servidor?
los traductor binario se ejecuta completamente del lado del cliente. El texto que codifica y las cadenas de bytes que decodifica nunca salen de su máquina, y la herramienta sigue funcionando con la conexión apagada una vez que la página se ha cargado. Eso importa más de lo que parece a primera vista: las cadenas que la gente convierte suelen ser tokens, identificadores internos, fragmentos de datos de usuario o bytes de protocolo capturados, exactamente el tipo de cosas que no debes pegar en un servidor aleatorio. El procesamiento en el navegador significa que no hay ningún servidor al que pegar. El Privacidad de datos en herramientas en línea Guía hace el caso más completo para insistir en esto.
La conversión binaria también se encuentra junto a un grupo de tareas de codificación relacionadas. los Codificador/decodificador Base64 Maneja la codificación utilizada para mover binario a través de canales de solo texto como correo electrónico y URL de datos. los Codificador de URL/decodificador Cubre la codificación de porcentaje para cadenas de consulta. y el generador de hachas Convierte el texto en resúmenes de longitud fija cuando necesitas una huella digital en lugar de una representación reversible. Para el kit más amplio que sigo abierto mientras construyo, el Kit de herramientas para desarrolladores web El Roundup es un buen punto de partida.
preguntasrán el
¿Cómo convierto el texto a binario?
Abra el traductor binario, elija "Texto a binario", mantenga la base configurada en binario y escriba su texto. Cada carácter está codificado en su valor de byte UTF-8 y se muestra como grupos de 8 bits, por lo que "A" se convierte en 01000001. La salida se actualiza a medida que escribe y se puede copiar con un solo clic, y puede cambiar a hexadecimal, decimal u octal sin volver a ingresar nada.
¿Cómo convierto el binario de nuevo en texto?
Seleccione "Binario a texto" y pegue su binario. Puede separar bytes con espacios, comas o saltos de línea, o pegar una serie continua de bits siempre que la longitud total sea un múltiplo de ocho. La herramienta agrupa los bits en bytes y los decodifica como UTF-8 para reconstruir los caracteres originales, y reporta un error si la longitud es incorrecta o si un carácter no es válido.
¿Qué codificación de caracteres utiliza el traductor binario?
Utiliza UTF-8, la codificación utilizada por la web moderna y la mayoría de los lenguajes de programación. Los personajes ASCII toman un byte, la mayoría de las letras acentuadas toman dos y muchos scripts y todos los emoji toman tres o cuatro bytes. Esto significa que la herramienta maneja correctamente mucho más que el inglés simple, a diferencia de las herramientas simples que solo mapean los 128 caracteres ASCII.
¿Puede convertirse en hexadecimal, decimal y octal también?
Sí. Un selector de base cambia la salida entre binario, hexadecimal, decimal y octal, y la decodificación acepta cualquiera de esas bases como entrada. El hexadecimal muestra dos caracteres por byte, octales de tres dígitos, decimal el valor simple de 0 a 255 y binario los ocho bits completos. Los cuatro representan los mismos bytes subyacentes.
¿Por qué mi decodificación binaria no?
Las dos razones más comunes son una longitud de bit que no es múltiplo de ocho y caracteres perdidos que no son válidos para la base elegida. La herramienta le indica exactamente qué token no es válido o si la longitud es incorrecta, por lo que puede solucionarlo. Una secuencia de bytes que no es válida UTF-8 (por ejemplo, un carácter de varios bytes que fue cortado) también se marca en lugar de decodificarse en basura.
¿El traductor binario admite emoji y texto no en inglés?
Sí. Debido a que codifica a través de UTF-8, los caracteres fuera del rango ASCII se representan como la secuencia correcta de dos, tres o cuatro bytes, y la decodificación los vuelve a ensamblar en el carácter original. Un emoji se convierte en cuatro bytes y ida y vuelta al mismo emoji, y el texto latino chino, árabe o acentuado funciona de la misma manera.
¿Es seguro convertir aquí el texto confidencial?
Sí. Cada conversión se ejecuta en JavaScript dentro de su navegador, por lo que nada de lo que ingrese, se registra o se almacena, y la herramienta sigue funcionando sin conexión a Internet una vez cargada. Puede convertir tokens, identificadores internos o mensajes privados de forma segura sin que ellos salgan de su dispositivo.
¿Cuál es la diferencia entre ASCII y UTF-8 en esta herramienta?
ASCII es un conjunto de 7 bits que cubre 128 caracteres en inglés, mientras que UTF-8 es una codificación de longitud variable que incluye todos los ASCII más todos los demás caracteres Unicode. Debido a que UTF-8 es un superconjunto de ASCII, el texto en inglés produce exactamente los bytes que una tabla ASCII predeciría, mientras que las letras acentuadas, otros scripts y emoji obtienen las secuencias de varios bytes correctas que ASCII simplemente no puede representar.


