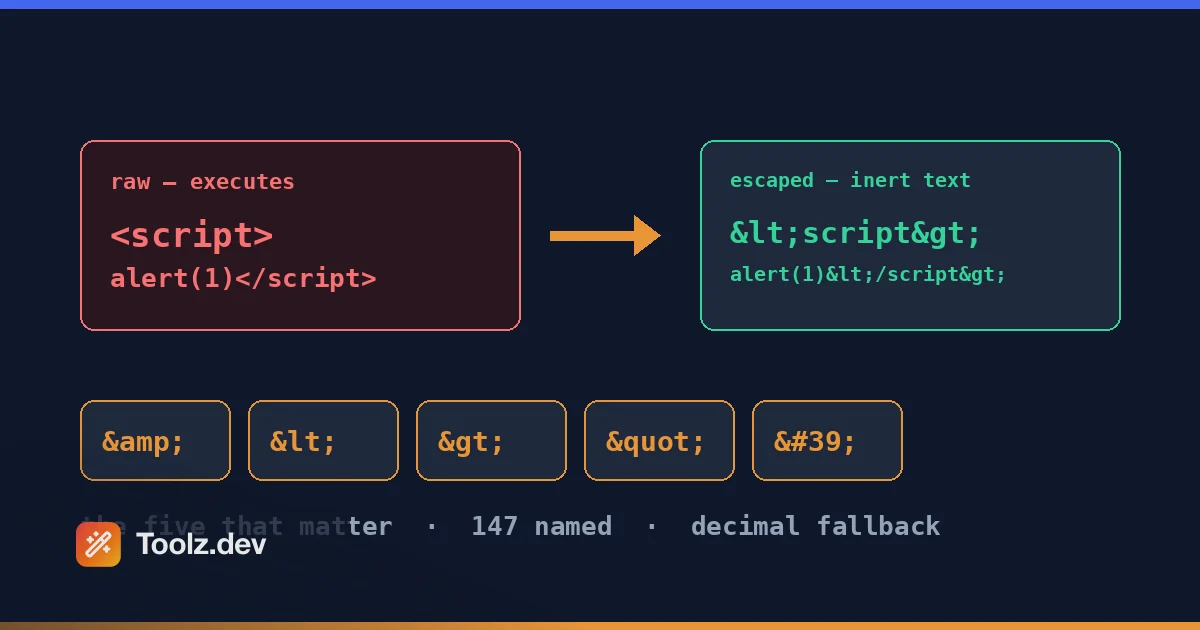
Vers 2021, un ticket d'assistance WP Adminify a atterri avec une capture d'écran qui me fait encore grimacer. Un utilisateur avait défini un texte de pied de page d'administrateur personnalisé - une ligne de droits d'auteur parfaitement innocente avec un © et un lien vers leur agence. Sur leur écran, il est rendu comme © 2021 — Bright & Co. Trois entités visibles, zéro caractères. Le coupable, c'était moi. Ma routine de sauvegarde a échappé au texte, ma routine de rendu s'est de nouveau échappée et quelque part entre un filtre s'est échappée une troisième fois. Au moment où il a touché le navigateur, cette pauvre esperluette avait été échappée quatre fois. J'ai compté.
La solution a pris dix minutes. Le constater a pris deux soirs, car les textes échappés presque D'accord. tu es sure © dans un vidage de base de données et votre cerveau le corrige automatiquement sur ©. J'ai fini par coller des chaînes dans un fichier HTML scratch encore et encore juste pour voir ce que le navigateur afficherait réellement à chaque couche. C'est un flux de travail misérable, et c'est exactement pourquoi un décodeur d'entité HTML est l'un des premiers outils que j'ai intégrés à Toolz.dev.
Le revers de la même pièce est plus effrayant. Quelques mois avant ce ticket, lors d'un examen de code de mon propre plugin, j'ai trouvé un champ de paramètres qui faisait écho à la saisie d'un utilisateur dans un avis d'administrateur sans esc_html(). Toute personne ayant accès à ce champ aurait pu stocker <script> et l'a fait exécuter pour chaque administrateur qui chargeait la page XSS stocké, dans mon propre code, une fonction manquante call away Personne ne l'a exploité - j'ai EU de la chance Mais ça a changé définitivement ma façon de penser à m'échapper : it' ; n'est pas une corvée de formatage, it' ; est la frontière entre " ;text" ; et " ;code." ;
Donc ce guide couvre les deux directions Encodage, donc texte non fiable reste texte Décodage, pour que vous puissiez lire ce qu'un pipeline trop cher a mutilé Et assez de théorie - nommé vs références numériques, les cinq caractères qui comptent réellement, pourquoi l'ordre des opérations provoque un double-évasion - pour que vous puissiez déboguer ce truc au lieu de deviner.
tl;dr : Collez votre texte dans le Encoder/décodeur d'entités HTML Toolz.dev pour convertir entre les caractères bruts et les entités dans les deux sens - nommé, décimal ou hex. Il s'exécute à 100 % côté client, de sorte que le contenu utilisateur et les informations personnelles ne quittent jamais votre navigateur. Règle générale : toujours échapper aux cinq spéciaux (
& < > " ') en entrée non approuvée et encodage&D'abord ou vous allez échapper à la double.
Principales caractéristiques
Encoder et décoder dans les deux sens
La moitié du temps, je dois tourner <script> dans <script> donc, il affiche comme texte dans un article de blog L'autre moitié I' ; je vais dans le sens inverse - tourner un gratté &#8217;s retour dans une apostrophe lisible L'outil gère les deux Coller du texte, choisir l'encodage ou le décodage, fait Pas de chasse de mode, pas d'outils séparés pour chaque direction Cela semble trivial jusqu'à ce que vous et #39 ; ayez utilisé des outils qui ne font que décoder, et vous vous retrouvez à ouvrir un deuxième onglet pour encoder un échantillon de code pour vos docs. Le Round-tripping est également un grand contrôle de santé mentale : encoder, décoder et confirmer que vous récupérez votre chaîne d'origine Si vous ne faites que & #39 ; t, quelque chose dans votre entrée a déjà été partiellement échappé - ce qui est lui-même une information utile.
Entités nommées : &amp;, &lt;,&copie; et amis
Les références de personnages nommés sont celles lisibles par l'homme & Pour &, < pour <, © pour ©, — Pour un em-dash. L'outil porte une table organisée de 147 noms, pas seulement les cinq célèbres : typographie ( , …, ’, “), la monnaie, les mathématiques et les flèches, les lettres grecques, la gamme complète d'accent latin-1 et quelques cotes comme les combinaisons de cartes. Cette plage correspond à ce dont le contenu du monde réel a réellement besoin - WordPress émet , …, et ’ Grâce à WPtexturize constamment, et un décodeur qui ne connaît qu'une douzaine de noms laisse la moitié de votre texte jonché de références non résolues.
Soyez clair sur ce que 147 n'est pas : le WHATWG HTML Standard définit plus de 2 200 références nommées, il s'agit donc d'un sous-ensemble pratique plutôt que du tableau complet Si un nom est & #39 ; t dedans, le décodage laisse la référence intacte plutôt que de deviner - &bogus; sort comme &bogus;. L'encodage a le comportement complémentaire, et c'est la moitié la plus utile : n'importe quel caractère à l'extérieur Un nom dans le tableau revient automatiquement à une référence numérique décimale, de sorte que rien n'est jamais abandonné en silence. Un emoji encode comme 🌍, texte chinois comme 你好. Des noms là où ils existent, des nombres partout ailleurs.
Une autre divergence par rapport au comportement du navigateur à connaître : le décodeur est sensible à la casse et nécessite le point-virgule. Les navigateurs vont résoudre © Et même un nu & sans point-virgule final dans certains contextes d'analyse, grâce aux règles de compatibilité existantes ; ce décodeur ne résout ni l'un ni l'autre. En pratique, cela et n° 39 ; c'est bien - tout ce qui est un outil moderne génère est minuscule et terminé - mais si vous et le numéro 39 ; décodez du HTML gratté à partir d'un ancien CMS, ce numéro 39 ; est le bord que vous et le numéro 39 ; va toucher.
Références numériques : décimale et hexadécimale
N'importe lequel Unicode le caractère peut être écrit comme une référence de caractère numérique - comme une décimale — ou Hex comme — (Les deux sont un em-dash). Le décodeur résout les deux formulaires. Il s'agit de la trappe d'échappement pour les personnages qui n'ont pas de nom dans la norme, et c'est la forme que vous rencontrerez constamment dans les réponses API et les flux RSS, où ’ (cote unique droite) est pratiquement une signature Les références hexagonales correspondent directement aux points de code Unicode - U+2014 l'est —- c'est pourquoi je les préfère lorsque I' ; m fait un croisement avec un graphique Unicode.
Limitation honnête, puisque vous le remarquerez dans la minute suivant l'utilisation de l'outil : le numérique encoder Le mode émet uniquement une décimale. Il n'y a pas d'option de sortie hexadécimale. décodage — fonctionne bien ; demander à l'encodeur de le produire ne fonctionne pas et n°39 ; t. Les deux formes sont sémantiquement identiques à chaque navigateur, donc cela ne vous coûte rien fonctionnellement, mais si votre base de code se standardise sur l'hexagone, vous et n°39 ; sera converti à la main. It' ; les références hors de portée se font attraper plutôt que mutiler - � est au-dessus du maximum Unicode et renvoie une erreur explicite au lieu d'un caractère de remplacement.
Couverture Unicode complète
Emoji, caractères CJK, arabe, combinant signes diacritiques, les œuvres S'il a un point de code, l'outil peut l'exprimer comme une entité et le résoudre en retour Cela compte plus que vous' ; penserait pour le travail de localisation - I' ; a débogué les trémas allemands arrivant comme ü d'un seul fournisseur de traduction et d'un UTF-8 brut ü d'un autre, dans le même fichier d'importation. Un outil qui s'étouffe en dehors du latin-1 est inutile pour cela. Les caractères au-dessus de U+FFFF (emoji vivent là-haut) sont traités correctement comme des points de code uniques, et non des paires de substituts mutimétriques.
Démêlez le texte à double échappatoire
le &amp; Problème. Lorsque deux couches d'un pipeline s'échappent, & se transforme &amp;- et trois couches vous donnent &amp;amp;. Le décodage une fois décollé d'une seule couche, afin que vous puissiez exécuter le décodeur à plusieurs reprises et regarder l'oignon se défaire : &amp;amp; → &amp; → & → &. Compter les passes vous indique combien de couches de votre pile s'échappent, ce qui est précisément le diagnostic dont j'avais besoin lors de ce bug de pied de page Adminify WP à s'échapper à quatre fois. Un décodage par couche. C'est le moyen le plus rapide que je connaisse de localiser où dans un pipeline se produit l'évasion supplémentaire.
Panneaux côte à côte avec nombre de personnages
Entrée à gauche, sortie à droite, le caractère compte au-dessus des deux Cette paire de comptage fait plus de travail qu'il n'y paraît : s'échapper est une opération en expansion, donc si vous encodez 40 caractères et récupérez 44, exactement un caractère spécial a été touché Lorsque I' ; m auditant si un modèle a déjà échappé à quelque chose, le delta me dit avant I' ; avoir lu un seul caractère de sortie Encoder, décoder, échanger et effacer sont des boutons - là' ; c'est pas de conversion en direct comme vous-type, ce que I' ; admettra est un compromis délibéré j'échappe des actions explicites signifient que vous connaissez toujours la direction X est un problème exploratoire, mais vous produisez le texte ; vous est un problème de touche exploratoire ; vous et vous êtes vraiment ; vous êtes un problème
100 % côté client - Rien téléchargé
Tout tourne dans votre navigateur Aucune demande, aucun serveur, aucun journal Ceci est & #39 ; t un chouette-à-avoir : le texte que vous et #39 ; s'échappez est souvent exactement le texte que vous devriez& #39 ; t coller dans des sites Web aléatoires - commentaires générés par les utilisateurs avec des noms réels, modèles de courriel avec des adresses de clients, contenu de ticket de soutien I & #39 ; a déjà écrit sur pourquoi cela compte dans Notre guide de confidentialité des données; la version courte est qu'un convertisseur qui télécharge votre entrée est un processeur de données que vous n'avez jamais vérifié. le Outil d'entité Toolz.dev fonctionne hors ligne une fois chargé Le mode avion est un test valide - essayez-le.
Comment utiliser l'encodeur et le décodeur d'entité HTML
Étape 1 : ouvrez l'outil et collez votre texte
se porter Toolz.dev/tools/html-entities et collez votre entrée - un extrait de code, un extrait RSS mutilé, un fragment de modèle de courrier électronique, peu importe. Là et n°39 ; n'a pas de plafond de taille qui mérite d'être inquiété pour une utilisation normale ; I' ; j'ai collé des journaux de modifications de plugin rendus entiers. Puisque le traitement est côté client, le contenu sensible est bien ici.
Étape 2 : Choisissez Encoder ou décoder
L'encodage transforme les caractères bruts en entités (< → <) - utilisez-le lorsque vous souhaitez que le balisage s'affiche sous forme de texte. Le décodage résout les entités en caractères (& → &) - utilisez-le lorsque vous' ; re lisez le contenu échappé Si vous' ; n'êtes pas sûr de l'état dans lequel se trouve votre texte, décodez d'abord et voyez quels changements. Une sortie inchangée signifie qu'elle était déjà claire.
Étape 3 : Choisissez le style de référence (lorsque l'encodage)
La liste déroulante de mode a exactement trois options, et le choix compte plus qu'il n'y paraît. nommé code tout ce pour quoi il a un nom et revient à la décimale pour le reste - lisible en source et en différences, mais il s'échappe également ©, —, é Et tous les autres caractères non ASCII, qui gonflent la sortie si vous êtes de toute façon sur UTF-8. numérique fait la même couverture en pure décimale. Caractères spéciaux uniquement ne touche que & < > " ' et laisse vos accents, vos em-dash et vos emoji comme UTF-8 brut - c'est celui que j'utilise pour le contenu réel, et it' ; c'est le mode qui correspond à quoi htmlspecialchars() fait en php. Notez que ' sort toujours comme ', jamais ', dans les trois modes, c'est délibéré, puisque ' n'est pas défini dans HTML 4 et les clients de messagerie plus anciens s'étouffent toujours avec.
Étape 4 : Vérifiez la sortie, puis copiez
Appuyez sur Encoder ou décoder et lisez le volet de droite. Pour les tâches de décodage, recherchez spécifiquement les restes & séquences - un survivant signifie que le texte a été double-échappé, alors appuyez sur Échanger et décoder à nouveau Quand il lit propre, copiez le résultat dans votre modèle, CMS ou code Pour les travaux répétés, aller-retour une fois (encoder puis décoder) pour confirmer que rien de perdu ne s'est produit ; avec le mode spécial-chars-only le voyage aller-retour est exact.
Nommés vs Entités numériques - et les cinq personnages qui comptent réellement
Let' ; s obtenir la terminologie droite, parce que " ; HTML entité" ; se fait utiliser de manière lâche La norme HTML WHATWG - la spécification vivante qui définit comment les navigateurs analysent réellement HTML - spécifie un tableau de Références de caractères nommées: plus de 2 200 noms comme , —, …, →, chaque mappage à un ou deux points de code Unicode. séparément, Références de caractères numériques Laissez-vous adresser un point de code directement : décimal (—) ou hexadécimal (—). Même em-dash, trois orthographes.
Voici ma prise d'opinion, aiguisée par des années de travail WordPress : Sur ces 2 200 noms, seuls cinq caractères sont vraiment importants pour l'exactitude et la sécurité. Tout le reste est typographie, et sur une page UTF-8 - qui est chaque page que vous devriez expédier en 2026 - vous pouvez simplement taper le vrai caractère Vous faites un don' ; pas besoin —; vous avez besoin de -. Les cinq qui comptent sont ceux qui ont une signification syntaxique en HTML :
| personnage | entité | Pourquoi c'est important |
|---|---|---|
& |
& |
Commence chaque entité - le personnage d'évasion lui-même |
< |
< |
Ouvre les balises |
> |
> |
Ferme les balises |
" |
" |
Délimite les attributs à double guillemet |
' |
' |
Délimite les attributs à guillemets uniques |
Notez la dernière ligne : ', pas '. le nom ' est valide en HTML5, mais c'était & #39 ; t partie de HTML4, et les anciens outils (et les anciens clients de messagerie - plus sur ceux plus tard) peuvent trébucher dessus La forme numérique fonctionne partout C'est le genre de pédantisme qui vous épargne un rapport de bug déroutant.
L'ordre des opérations est le jeu entier. Lors de l'encodage, & doit être échappé premier. Si vous vous échappez < à < Et puis échapper aux esperluettes, vous convertirez votre propre sortie en &lt;- félicitations, vous et le numéro 39 ; vous avez double échappée. Le décodage est l'image miroir : & doit être résolu dernier, ou &lt; se transforme < se transforme < et vous et n°39 ; avez sous-décodé (ou pire, réintroduit le balisage en direct à partir d'un texte qui a été délibérément échappé). Presque tous les bugs d'échappement roulés à la main I et n°39 ; a examiné - y compris le mien - est un bug de commande.
Le contexte est important, et c'est là que s'échapper rencontre la sécurité. La feuille de triche de prévention des scripts intersites OWASP est brutale à ce sujet : l'encodage des entités HTML est la bonne défense pour le HTML corps et attribuer contextes, mais c'est non Suffisant pour les chaînes de javascript, les URL ou les CSS. < à l'intérieur d' <script> block does' ; t decode - script content is' ; t analysée pour les entités - donc le codage d'entité n'y fait rien d'utile Chaque contexte a besoin de son propre encodeur : encodage d'entité pour HTML, \uXXXX s'échapper pour les chaînes JS, pourcentage d'encodage pour les URL (c'est ce que notre Encodeur/décodeur d'URL est pour). L'utilisation du bon encodeur dans le mauvais contexte est la façon classique dont le code d'aspect aseptisé reste exploitable.
Du côté PHP, Connaissez vos deux fonctions. htmlspecialchars() Échappe uniquement aux cinq promotions (passe ENT_QUOTES ou vous manquez la citation unique - un vrai gotcha). htmlentities() évasions tout qui a une entité nommée, tournant ü dans ü. Sur les pages UTF-8, htmlentities() est presque toujours le mauvais choix ; il gonfle la sortie et mutile le contenu lorsque les jeux de caractères sont mal déclarés. WordPress enveloppe cela de manière raisonnable :
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() et esc_attr() les deux échappent aux cinq spéciaux avec les bons drapeaux, choisis par contexte - exactement la discipline à évasion tardive prescrite par OWASP La règle que j'exerce dans chaque révision de code : évadez-vous au moment de la sortie, dans le contexte de sortie' ; s, exactement une fois.
Ce qui le ramène à la maison : avec UTF-8, vous besoin Entités pour les caractères typographiques. Vous en avez besoin pour les caractères significatifs du balisage et pour une entrée non fiable. Tout le reste est une habitude héritée.
Cas d'utilisation courants
Affichage des extraits de code dans les articles de blog et les documents
Rédiger un tutoriel contenant <script> ou <?php Et collez-le dans un CMS Raw, et le navigateur essaiera de exécuter ou avaler votre exemple au lieu de l'afficher. Chaque exemple de code dans un contexte HTML a besoin <, >, et & encodé. Je le fais constamment pour la documentation du plugin - readme HTML, articles de base de connaissances, exemples en ligne dans les onglets d'aide de l'interface utilisateur d'administration Le flux de travail : écrivez l'extrait, exécutez-le via le Encodeur d'entité, collez la version échappée à l'intérieur <pre><code>. trente secondes, et votre <script> Affiche comme <script> Au lieu de disparaître dans le DOM. Si vous construisez un flux de travail de Docs en général, notre Guide des outils de codage Couvre le reste de la boîte à outils autour de cela.
Nettoyage du texte à double échappatoire à partir de bases de données et de flux
le &amp; peste. Il apparaît lorsqu'un CMS s'échappe lors de la sauvegarde, qu'un plugin s'échappe lors du rendu et qu'une couche de mise en cache s'échappe à nouveau utilement. Une fois, j'ai expédié un journal des modifications WP Adminify où l'analyseur wordpress.org readme et mon propre script de build n'étaient pas d'accord sur qui s'échappe - le journal des modifications rendu en avait 23 visibles &s dedans avant qu'un utilisateur ne m'envoie par e-mail. Les flux RSS sont pires ; le contenu du flux est souvent échappé au code HTML à l'intérieur XML, donc les consommateurs le sur-décodent ou le sous-décodent régulièrement Le correctif est le décodage diagnostique : collez le texte cassé, décodez un passage à la fois, comptez combien de passages jusqu'à ce qu'il & #39 ; ce nombre est égal au nombre de couches qui s'échappent - maintenant vous savez exactement combien de morceaux de votre pipeline touchent le texte, et vous pouvez trouver le redondant.
Préparation du contenu généré par les utilisateurs en toute sécurité
Commentaires, texte de révision, bios de profil, tickets de support - tout ce qu'un utilisateur a tapé n'est pas fiable, et il contient fréquemment des informations personnelles : noms réels, e-mails, adresses Deux préoccupations se heurtent ici. Premièrement, la sécurité : ce contenu doit être codé par entité en sortie ou vous' ; en êtes un <img onerror=...> loin du XSS stocké (demandez-moi le champ des paramètres que j'ai failli expédier). Deuxièmement, la confidentialité : lorsque vous déboguez pourquoi un utilisateur spécifique' ; s bio brise votre mise en page, vous' ; manipulez leurs données personnelles - les coller dans un convertisseur côté serveur signifie expédier des informations personnelles à un tiers L'outil Toolz.dev traite tout localement, donc tester de vraies chaînes de problèmes est sûr Encodez l'échantillon, inspectez quel est votre modèle il faut que ont produit, différent de ce qu'il a produit.
Modèles HTML de courrier électronique
Email HTML est un développement web avec un moteur de rendu vieux de 20 ans Certains clients gèrent l'amende brute UTF-8 ; d'autres - selon la façon dont vos ensembles ESP transfèrent les encodages - garblent les caractères typographiques en mojibake La convention défensive que suivent encore de nombreux développeurs de messagerie : encodez la typographie non-ASCII en tant qu'entités (en)—, ’, pour les hacks d'espacement) afin que les octets sur le fil soient de l'ASCII pur. Et rappelez-vous ' au-dessus de '- Outlook' ; Les anciens moteurs sont exactement l'outillage qui n'a jamais appris les noms HTML5. puisque les modèles sont personnalisés avec les noms et adresses des clients, il s'agit encore d'un contenu I' ; n'exécutez qu'une seule fois un outil côté client. Encodez le chrome du modèle, gardez les champs de fusion bruts, échappez-les au moment de la fusion.
Décodage du contenu racheté et des réponses aux API
Grattez une page ou consommez une API bâclée et vous vous noierez dans ’, “, &, et . Certaines API renvoient des chaînes codées par entité dans JSON - un format qui ne nécessite aucun échappement HTML - afin que vous obteniez des artefacts tels que "title": "Fish & Chips". Avant que les données ne soient entrées dans votre propre base de données, décodez-la en UTF-8 ; stockez du texte canonique, échappez-vous à la sortie. J'ai frappé constamment ce contenu lors de l'importation de contenu dans les applications Laravel : décoder en premier lieu les entités. à ce moment- Pretty-print et inspectez la charge utile avec le Formateur JSON. Le faire dans l'autre ordre signifie lire JSON où chaque apostrophe a sept caractères. Si la charge utile est enveloppée en base64 en plus de cela - certains fournisseurs de webhook font cela - le Convertisseur de base64 gère la couche externe, et notre Guide d'encodage Base64 Explique pourquoi cet emballage existe.
Localiser le contenu avec des caractères spéciaux
Les fichiers de traduction arrivent dans chaque état imaginable. Un fournisseur envoie un UTF-8 propre ü; un autre envoie ü; un troisième envoie ü; occasionnellement, vous obtenez les trois dans un seul fichier PO Avant d'importer, je normalise tout à l'UTF-8 brut avec un passage de décodage - stockage canonique, recherche cohérente, diff sains d'esprit Il en va de même pour la ponctuation RTL, les crochets CJK et le latin accentué dans les chaînes expédiées. Décodez à l'importation, stockez des caractères réels et laissez votre couche de sortie échapper uniquement aux cinq spéciaux Vos traducteurs vous remercieront également : über N'est-ce pas un mot que quelqu'un devrait avoir à relire.
Nommé VS Decimal VS Hex VS RAW UTF-8 : Lequel utiliser ?
| se former | Exemple (em-dash) | lisibilité | Prise en charge du navigateur | Quand utiliser |
|---|---|---|---|---|
| Entité nommée | — |
Bien - auto-décrit | Universel pour les noms de l'ère HTML4 ; noms HTML5 uniquement (comme ') échouer dans les anciens outils |
Les cinq spéciaux, les contextes hérités comme le courrier électronique HTML |
| Référence décimale | — |
Pauvre - c'est le & #39 ; c'est un numéro | Universel, y compris les analyseurs anciens | caractères sans noms, s'échapper de la compatibilité maximale (') |
| référence hexagonale | — |
Mauvais, mais correspond aux points de code Unicode | Universel dans tout ce qui est moderne | Lors du croisement des graphiques Unicode ou des spécifications |
| UTF brut-8 | — |
parfaire | Universel sur les pages UTF-8 correctement déclarées | Tout typographique - cela devrait être votre défaut |
Ma position, clairement : Écrivez RAW UTF-8 pour la typographie, réservez des entités pour les cinq offres spéciales et les entrées non approuvées. Un document plein de — et … est un document que personne ne peut relire, et il signale un flux de travail qui a & #39 ; t a fait confiance à ses déclarations de jeux de caractères depuis 2008. piles modernes - WordPress, Laravel, Next.js, chaque base de données que vous et #39 ; choisiraient aujourd'hui - sont UTF-8 bout à bout Tapez le caractère réel.
Où les entités gagnent leur donjon : &, <, >, ", et ' pour tout ce qui pourrait être interprété comme du balisage, toujours, pas d'exceptions, appliqué au moment de la sortie Et dans les environnements de rendu hostiles - clients de messagerie, flux consommés par des analyseurs inconnus - les références numériques sont le choix paranoïaque mais justifié car elles sont antérieures à chaque argument de compatibilité Entre décimal et hex, it' ; s goûtent ; je penche hex parce que — Correspond à U+2014 et je peux arrêter de faire des conversions de base dans ma tête.
Questions fréquentes
Qu'est-ce qu'une entité HTML ?
Une entité HTML est une séquence de texte qui représente un caractère au lieu d'écrire directement le caractère. Cela commence par une esperluette et se termine par un point-virgule. Il existe des références nommées comme &Amp; et ©, et des références numériques comme © (décimal) ou © (hex) qui pointent un point de code Unicode. Les navigateurs les résolvent lors de l'analyse, donc < s'affiche comme un signe moins que au lieu d'ouvrir une balise. Ils existent pour que vous puissiez afficher des caractères qui seraient autrement interprétés comme un balisage.
Quels caractères doivent être échappés en HTML ?
Cinq : l'esperluette, moins que, plus grand que, guillemet double, et guillemet simple - écrit comme & amp ;, & lt ;, & gt ;, " ;, et ' ;. Ampersand, parce qu'il démarre des entités ; les crochets d'angle, parce qu'ils délimitent des balises ; les guillemets, parce qu'ils délimitent des valeurs d'attribut Dans le corps de l'élément texte vous pouvez vous en sortir avec seulement les trois premiers, mais échapper aux cinq partout est l'habitude qui ne vous mord jamais Tout le reste - accents, tirets, tirets, tirets, émojas, émo - peut être brut UTF-8 sur une page correctement déclarée.
Quelle est la différence entre < écrit comme une entité nommée et <?
Rien, une fois que le navigateur les analyse - les deux produisent un signe inférieur à. Le formulaire nommé est une recherche dans la table de références nommées WHATWG standard' ; s ; < ; adresse directement le point de code Unicode 60, et < ; est le même point de code en hex. Les entités nommées sont plus faciles à lire pour les humains ; les références numériques fonctionnent pour tous les caractères, y compris les milliers qui n'ont pas de nom. Pour les offres spéciales courantes, choisissez celle que votre équipe trouve la plus lisible - les navigateurs s'en moquent.
Pourquoi ma page affiche-t-elle une amp; au lieu d'une esperluette ?
Double échappement. Une couche de votre pile a échappé à une chaîne déjà échappée, transformant & amp ; en & amp ; amp ; Le navigateur décode un niveau et affiche les restes Cela signifie généralement que deux composants pensent tous deux que l'échappement est leur travail - un CMS en sauvegarde plus un modèle en rendu est la paire classique Décoder la chaîne un passage à la fois dans un décodeur ; le nombre de passages jusqu'à ce qu'elle soit lue propre est égal au nombre de couches qui lui échappent Ensuite rendre exactement une couche responsable, au moment de la sortie.
L'évasion HTML empêche-t-elle XSS ?
Dans les contextes de corps et d'attributs HTML, oui - entrée non fiable d'encodage d'entité il y a la défense de base, parce que la charge utile rend comme texte inerte Mais ce n'est pas suffisant partout La feuille de triche de prévention OWASP XSS est explicite que les chaînes, URL et CSS JavaScript ont chacun besoin de leur propre encodage spécifique au contexte ; l'encodage d'entité à l'intérieur d'un bloc de script ne fait rien Échapper en sortie, dans le contexte dans lequel vous êtes en sortie, en utilisant ce contexte' ; l'encodeur d'entité est un outil dans ce kit, pas le kit entier.
Quelle est la différence entre HTMLSpecialChars et HTMLEntities dans PHP ?
htmlspecialchars () échappe uniquement aux caractères significatifs de balisage - et vous devriez passer ENT_QUOTES pour qu'il couvre la citation unique htmlentities () convertit chaque caractère qui a une entité nommée, donc les lettres accentuées deviennent des choses comme la référence uuml. Sur les pages UTF-8, htmlspecialchars () est presque toujours ce que vous voulez ; htmlentities () bloat la sortie et provoque le mojibake lorsque les jeux de caractères sont mal configurés Les développeurs WordPress évitent surtout la question en utilisant esc_html () et esc_attr (), qui appliquent les bons drapeaux par contexte.
Dois-je utiliser l'entité nommée Apos pour les apostrophes ?
Préférez le & #39 ; Le nom apos est valide en HTML5 mais n'a jamais fait partie de HTML4, donc les analyseurs plus anciens - y compris les moteurs de rendu à l'intérieur de certains clients de messagerie - ne le reconnaissent pas et l'afficheront littéralement La forme numérique & #39 ; signifie le même caractère et fonctionne dans tout ce qui a jamais été expédié C'est un choix laid mais sûr, qui est généralement le bon compromis pour s'échapper Si vous savez que votre sortie ne frappe que les navigateurs modernes, apos est bien ; les modèles de messagerie sont exactement là où vous ne pouvez pas le savoir.
Est-il sûr de coller des données utilisateur dans un convertisseur d'entités en ligne ?
Seulement si l'outil traite du texte dans votre navigateur Les modèles de contenu et de courriel générés par l'utilisateur contiennent régulièrement des noms, des courriels et d'autres informations personnelles, et un convertisseur qui publie votre entrée sur un serveur vient de recevoir ces données sans accord en place Le codeur/décodeur Toolz.dev HTML Entities s'exécute à 100 % côté client - pas de téléchargement, pas de journalisation et il fonctionne hors ligne une fois la page chargée Si vous ne pouvez pas vérifier comment un outil gère la saisie, ne collez pas de données de production dedans.
Évadez-vous une fois, au bon endroit
Si vous prenez une chose d'une décennie de mes erreurs de fuite, prenez ceci : exactement une couche de votre pile devrait s'échapper, et cela devrait être la couche de sortie. Rangez l'UTF-8 propre. Échappez aux cinq spéciaux au moment du rendu, dans le contexte dans lequel vous vous rendez compte. chaque &amp; en production se trouve une carte de deux composants qui se battent pour ce travail - et chaque chaîne utilisateur non échappée est un XSS stocké en attente d'une révision de code qui pourrait ne pas se produire. Le mien a failli se produire et n°39 ; t.
Gardez le Encodeur/décodeur d'entités HTML dans votre rotation de débogage aux côtés de ses frères et sœurs - le Encodeur/décodeur d'URL Pour les contextes de codage en pourcentage (le Guide d'encodage des URL Parcoure %2520, le pourcentage de cousine d'encodage de &amp;), le Convertisseur de base64 pour les charges utiles emballées, et Convertisseur de boîtier Pour l'identifiant-renommer le travail de grognement entre eux. le Guide des outils de codage Parcoure tout le set.
Et comme les chaînes que vous déboguez sont si souvent quelqu'un' ; son nom réel ou son e-mail : tout ce qui précède fonctionne côté client, rien n'est téléchargé, vérifiable dans votre onglet réseau. That' ;s not marketing - it' ; est la raison pour laquelle j'ai construit ces outils comme je l'ai fait. Plus sur cette philosophie dans le Guide de confidentialité des données.


