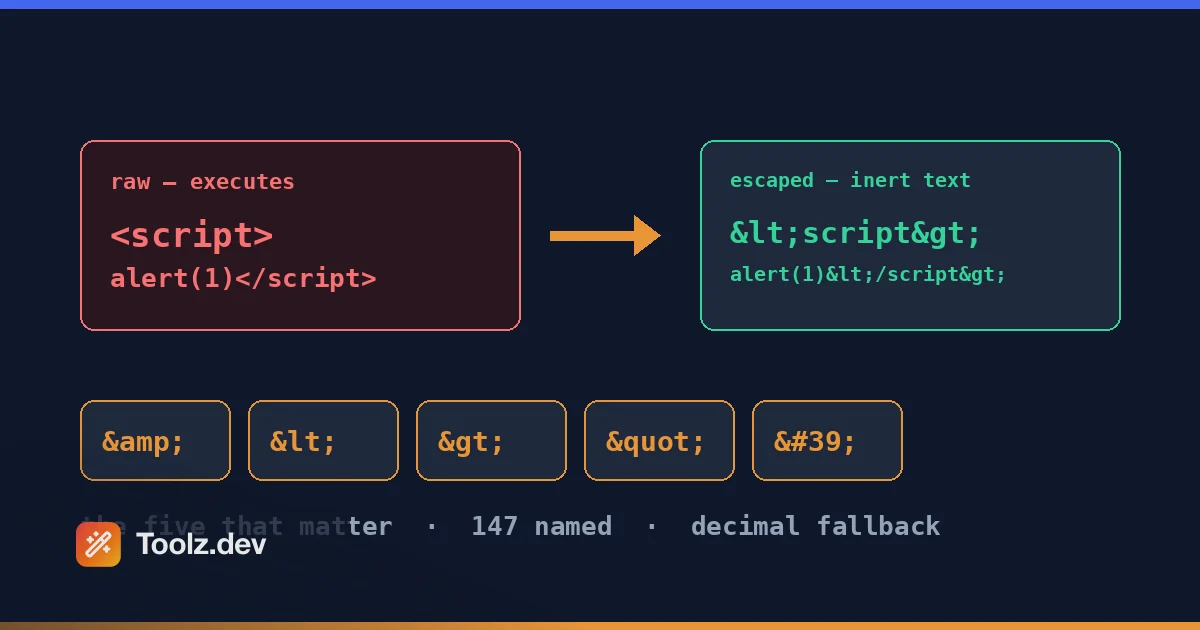
Intorno al 2021, un ticket di supporto WP Adminify è arrivato con uno screenshot che mi fa ancora sussultare. Un utente aveva impostato un testo personalizzato del piè di pagina dell'amministratore: una riga di copyright perfettamente innocente con a © e un collegamento alla loro agenzia. Sul loro schermo è stato reso come © 2021 — Bright & Co. Tre entità visibili, zero rendering caratteri. Il colpevole ero io. La mia routine di salvataggio è sfuggita al testo, la mia routine di rendering è sfuggita di nuovo e da qualche parte nel mezzo di un filtro è sfuggito per una terza volta. Quando ha colpito il browser, quella povera e commerciale era stata fuggita quattro volte. ho contato.
La correzione ha richiesto dieci minuti. Trovando che ci sono volute due serate, perché il testo sfuggito sembra quasi giusto. tu scremi © in un dump del database e il tuo cervello lo corregge automaticamente ©. Ho finito per incollare le stringhe in un file html scratch più e più volte solo per vedere cosa avrebbe effettivamente eseguito il rendering del browser a ogni livello. Questo è un flusso di lavoro miserabile, ed è proprio per questo che un codificatore di entità HTML è uno dei primi strumenti che ho integrato in Toolz.dev.
Il rovescio della medaglia è più spaventoso. Alcuni mesi prima di quel ticket, durante una revisione del codice del mio plugin, ho trovato un campo di impostazioni che ha fatto eco all'input dell'utente in un avviso di amministratore senza esc_html(). Chiunque abbia accesso a quel campo potrebbe aver archiviato <script> e l'ho fatto eseguire per ogni amministratore che ha caricato la pagina. Memorizzato XSS, nel mio codice, una chiamata di funzione mancante. Nessuno lo ha sfruttato: ho avuto fortuna. Ma ha cambiato permanentemente il modo in cui penso all'evasione: it' non è un compito di formattazione, it' è il confine tra & quot;text" e "codice."
Quindi questa guida copre entrambe le direzioni Codifica, quindi il testo non attendibile rimane testo Decodifica, così puoi leggere cosa ha mutilato qualche pipeline troppo ansiosa. E basta teoria - riferimenti denominati vs numerici, i cinque caratteri che contano davvero, perché l'ordine delle operazioni provoca una doppia fuga - che puoi eseguire il debug di questa roba invece di indovinare.
tl; dr: Incolla il tuo testo nel Encoder/decoder di entità HTML di Toolz.dev per convertire tra caratteri grezzi ed entità in entrambe le direzioni - con nome, decimale o esadecimale Funziona al 100% lato client, quindi il contenuto utente e le PII non lasciano mai il browser Regola pratica: sfuggire sempre alle cinque offerte speciali (evitare sempre le cinque offerte speciali)
& < > " ') in input non attendibile e codifica&Per prima cosa o farai una doppia fuga.
Caratteristiche principali
codificare e decodificare in entrambe le direzioni
La metà delle volte devo girare <script> dentro <script> quindi viene visualizzato come testo in un post del blog L'altra metà I & #39; sto andando nella direzione opposta - girando un raschiato &#8217;s torna in un apostrofo leggibile Lo strumento gestisce entrambi Incolla testo, scegli codifica o decodifica, fatto Nessuna caccia alla modalità, nessuno strumento separato per ogni direzione Sembra banale fino a te' hai usato strumenti che decodificano solo e ti ritrovi ad aprire una seconda scheda per codificare un campione di codice per i tuoi documenti Il giro è anche un ottimo controllo di integrità: codifica, decodifica e conferma che riavrai la tua stringa originale Se non lo fai' t, qualcosa nel tuo input era già parzialmente sfuggito, il che è di per sé un'informazione utile.
Entità nominate: &amp;, &lt;, &copy; e amici
I riferimenti ai personaggi nominati sono quelli leggibili dall'uomo - & per &, < per <, © per ©, — per un em-dash. Lo strumento porta una tabella curata di 147 nomi, non solo i famosi cinque: tipografia ( , …, ’, “), valuta, matematica e frecce, lettere greche, l'intera gamma accentata Latin-1 e alcune probabilità come i semi delle carte. Questa gamma è ciò di cui i contenuti del mondo reale hanno effettivamente bisogno: WordPress emette , …, e ’ Attraverso WpTexturize costantemente, e un decoder che conosce solo una dozzina di nomi lascia metà del tuo testo disseminato di riferimenti irrisolti.
Siate chiari su ciò che 147 non è: il WHATWG HTML Standard definisce oltre 2.200 riferimenti denominati, quindi questo è un sottoinsieme pratico piuttosto che la tabella completa Se un nome è' t in esso, la decodifica lascia il riferimento intatto piuttosto che indovinare - &bogus; esce come &bogus;. La codifica ha il comportamento complementare, ed è la metà più utile: qualsiasi personaggio senza Un nome nella tabella ricade automaticamente su un riferimento numerico decimale, quindi nulla viene mai lasciato cadere silenziosamente. Un emoji codifica come 🌍, testo cinese come 你好. Nomi dove esistono, numeri ovunque.
Un'altra divergenza dal comportamento del browser che vale la pena conoscere: il decoder fa distinzione tra maiuscole e minuscole e richiede il punto e virgola. I browser si risolveranno © E anche nudo & senza punto e virgola finale in alcuni contesti di analisi, grazie alle regole di compatibilità legacy; questo decoder non risolve nessuno dei due. In pratica va bene questo ' qualsiasi cosa sia uno strumento moderno genera è minuscolo e terminato, ma se tu' decodifica HTML raschiato da un antico CMS, quello' è il bordo tu' colpirà.
Riferimenti numerici: decimale ed esadecimale
Qualsiasi Unicode carattere può essere scritto come un riferimento numerico carattere - decimale come — o esadecimale — (entrambi sono un em-dash). Il decoder risolve entrambe le forme. Questo è il portello di fuga per i personaggi che non hanno nome nello standard, ed è la forma che incontrerai costantemente nelle risposte API e nei feed RSS, dove ’ (virgoletta singola destra) è praticamente una firma Riferimenti esadecimali mappa direttamente ai punti di codice Unicode - U+2014 è —- motivo per cui li preferisco quando I'm si incrociano con un grafico Unicode.
Limitazione onesta, poiché te ne accorgerai entro un minuto dall'utilizzo dello strumento: il numerico codificare La modalità emette solo decimale. Non c'è un'opzione di uscita esadecimale. deciframento — funziona bene; chiedere al codificatore di produrlo fa & #39; t. I due moduli sono semanticamente identici a ogni browser, quindi questo non ti costa nulla funzionalmente, ma se il tuo codice base si standardizza su hex you' starà convertendo a mano It's sulla mia lista I riferimenti fuori gamma vengono catturati piuttosto che mutilati - � è al di sopra del massimo di Unicode e restituisce un errore esplicito invece di un carattere sostitutivo.
Copertura Unicode completa
Emoji, caratteri CJK, arabo, combinazione di segni diacritici, funziona Se ha un punto di codice, lo strumento può esprimerlo come entità e risolverlo indietro Questo conta più di te' penserei per il lavoro di localizzazione - I' ho eseguito il debug delle dieresi tedesche che arrivano come ü da un fornitore di traduzioni e come RAW UTF-8 ü da un altro, nello stesso file di importazione. Uno strumento che si soffoca al di fuori del latino-1 è inutile per questo. I caratteri sopra U+FFFF (emoji live up there) vengono gestiti correttamente come singoli punti di codice, non coppie surrogate mutilate.
Districa il testo a doppia fuga
la &amp; problema. Quando due strati di una pipeline scappano entrambi, & diventa &amp;- e tre strati ti danno &amp;amp;. La decodifica una volta staccata esattamente uno strato, in modo da poter eseguire ripetutamente il decoder e guardare la cipolla scarta: &amp;amp; → &amp; → & → &. Il conteggio dei passaggi ti dice quanti livelli del tuo stack stanno scappando, che è proprio la diagnostica di cui avevo bisogno durante quel bug di piè di pagina WP di amministrazione di quattro volte. una decodifica per livello. È il modo più veloce che conosco per localizzare dove avviene in una pipeline la fuga extra.
Riquadri affiancati con conteggi caratteri
Input a sinistra, output a destra, i caratteri contano sopra entrambi Quella coppia di conteggio fa più lavoro di quanto sembri: evadere è un'operazione di espansione, quindi se codifichi 40 caratteri e ne ottieni 44 indietro, è stato toccato esattamente un carattere speciale Quando I'm auditing se un modello è già sfuggito a qualcosa, il delta mi dice prima di I' ho letto un singolo carattere di output Codifica, decodifica, Swap e Cancella sono pulsanti - there's nessuna conversione live-as-you-type, che io & #39; ammetterò è un compromesso deliberato a volte mi pento. Le azioni esplicite significano che sai sempre in quale direzione è stato prodotto il testo tu' riguardare, e con bug in fuga che l'ambiguità è l'intero problema Ma per il poking esplorativo, una versione guidata dalla sequenza di tasti sarebbe genuinamente più bella.
100% lato client: niente caricato
Tutto viene eseguito nel tuo browser Nessuna richiesta, nessun server, nessun registro Questo è' t un bello da avere: il testo you're escaping è spesso esattamente il testo che dovresti' t incollare in siti Web casuali - commenti generati dagli utenti con nomi reali, modelli di posta elettronica con indirizzi dei clienti, contenuto del ticket di supporto. I've scritto prima sul motivo per cui questo è importante in La nostra guida alla privacy dei datiLa versione breve è che un convertitore che carica il tuo input è un processore dati che non hai mai controllato. la Strumento Entità Toolz.dev funziona offline una volta caricata La modalità aereo è un test valido - provalo.
Come utilizzare il codificatore e il decoder di entità HTML
Passaggio 1: apri lo strumento e incolla il tuo testo
ricorrere Toolz.dev/tools/html-entità e incolla il tuo input: uno snippet di codice, un estratto RSS straziato, un frammento di modello di posta elettronica, qualunque cosa. Non c'è nessun tetto dimensionale di cui vale la pena preoccuparsi per un uso normale; I' ho incollato interi changelog di plugin renderizzati Poiché l'elaborazione è lato client, il contenuto sensibile va bene qui.
Passaggio 2: scegli la codifica o la decodifica
La codifica trasforma i caratteri grezzi in entità (< → <) - usalo quando vuoi che il markup venga visualizzato come testo La decodifica risolve le entità in caratteri (& → &) - usalo quando tu' stai leggendo il contenuto evaso Se tu' non sei sicuro in quale stato si trova il tuo testo, decodifica prima e vedi cosa cambia L'output immodificato significa che era già semplice.
Passaggio 3: scegli lo stile di riferimento (durante la codifica)
Il menu a discesa della modalità ha esattamente tre opzioni e la scelta conta più di quanto sembri. detto codifica tutto ciò per cui ha un nome e torna decimale per il resto - leggibile in source e diffs, ma sfugge anche ©, —, é E ogni altro personaggio non ASCII, che gonfiore l'output se sei comunque su UTF-8. numerico Fa la stessa copertura in decimale puro. Solo caratteri speciali non tocca altro che & < > " ' e lascia i tuoi accenti, trattini elettronici ed emoji come UTF-8 grezzo: questo è quello che uso per i contenuti reali, e it' è la modalità che corrisponde a cosa htmlspecialchars() lo fa in PHP. Nota che ' esce sempre come ', mai ', in tutte e tre le modalità, è deliberato, da allora ' non è definito in HTML 4 e i client di posta più vecchi ancora soffocano su di esso.
Passaggio 4: controlla l'output, quindi copia
Premi la codifica o la decodifica e leggi il riquadro di destra. Per i lavori di decodifica, cerca specificamente gli avanzi & sequenze - un sopravvissuto significa che il testo era a doppia escape, quindi premi Scambia e decodifica di nuovo Quando si legge pulito, copia il risultato nel modello, CMS o codice Per i lavori ripetuti, andata e ritorno una volta (codifica quindi decodifica) per confermare che non è successo nulla di con perdita; con la modalità solo per le chat speciali il viaggio di andata e ritorno è esatto.
Entità denominate vs numeriche - e i cinque personaggi che contano davvero
Let's ottenere la terminologia dritto, perché & quot;HTML entità" viene utilizzato in modo approssimativo Il WHATWG HTML Standard - la vivente spec che definisce come i browser effettivamente analizzare HTML - specifica una tabella di Riferimenti di caratteri nominati: oltre 2.200 nomi come , —, …, →, ciascuna mappatura su uno o due punti di codice Unicode. separatamente, Riferimenti di caratteri numerici Consenti di indirizzare direttamente qualsiasi punto di codice: decimale (—) o esadecimale (—). Stesso EM-Dash, tre ortografie.
Ecco la mia opinione supponente, affinata da anni di lavoro su WordPress: Di questi oltre 2.200 nomi, solo cinque caratteri contano effettivamente per correttezza e sicurezza. Tutto il resto è tipografia, e su una pagina UTF-8 - che è ogni pagina che si dovrebbe essere spedizione nel 2026 - si può solo digitare il carattere reale Si don' t bisogno —; hai bisogno -. I cinque che contano sono quelli con significato sintattico in HTML:
| carattere | entità | Perché è importante |
|---|---|---|
& |
& |
Avvia ogni entità - il personaggio di fuga stesso |
< |
< |
Apre i tag |
> |
> |
Chiude i tag |
" |
" |
Delimita gli attributi con citazioni doppie |
' |
' |
Delimita gli attributi con virgolette singole |
Nota l'ultima riga: ', no '. il nome ' è valido in HTML5, ma era & #39; t parte di HTML4, e i vecchi strumenti (e i vecchi client di posta elettronica - più su quelli successivi) possono inciampare su di esso Il modulo numerico funziona ovunque Questo è il tipo di pedanteria che ti salva una segnalazione di bug confusa.
L'ordine delle operazioni è l'intero gioco. Quando si codifica, & deve essere fuggito innanzi tutto. Se scappi < a < E poi evade le e commerciali, convertirai la tua output in &lt;- congratulazioni, tu've double-escaped La decodifica è l'immagine speculare: & deve essere risolto ultimo, o &lt; diventa < diventa < e tu've sotto-decodificato (o peggio, reintrodotto il markup live dal testo che è stato deliberatamente sfuggito) Quasi ogni bug di fuga arrotolato a mano I've recensito - incluso il mio - è un bug di ordinazione.
Il contesto è importante, ed è qui che l'evasione incontra la sicurezza. Il cheat sheet per la prevenzione dello scripting cross-site OWASP è schietto al riguardo: la codifica dell'entità HTML è la difesa corretta per l'HTML entità e attribuire contesti, ma lo è no Sufficiente per stringhe JavaScript, URL o CSS. < Dentro a <script> blocco does' t decodifica - il contenuto dello script is' t analizzato per le entità - quindi la codifica delle entità non fa nulla di utile lì Ogni contesto ha bisogno del proprio codificatore: codifica delle entità per HTML, \uXXXX in fuga per stringhe JS, codifica percentuale per gli URL (questo è ciò che il nostro Encoder/decoder URL è per). L'uso dell'encoder giusto nel contesto sbagliato è il classico modo in cui il codice dall'aspetto igienizzato rimane sfruttabile.
Sul lato PHP, conosci le tue due funzioni. htmlspecialchars() sfugge solo ai cinque speciali (pass ENT_QUOTES oppure ti manca la singola citazione: un vero incastro). htmlentities() fuoriuscire tutto che ha un'entità denominata, in svolta ü dentro ü. Su pagine UTF-8, htmlentities() è quasi sempre la scelta sbagliata; gonfia l'output e mangle il contenuto quando i caratteri sono errati. WordPress lo avvolge in modo sensato:
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() e esc_attr() entrambi sfuggono ai cinque speciali con i flag giusti, scelti per contesto - esattamente la disciplina di fuga tardiva prescritta da OWASP La regola che eseguo in ogni revisione del codice: escape al momento dell'output, nel contesto output' ss, esattamente una volta.
Il che lo porta a casa: con UTF-8, raramente occorrere entità per caratteri tipografici a tutti. Ne hai bisogno per caratteri significativi di markup e per input non attendibili. Tutto il resto è abitudine all'eredità.
Casi d'uso comuni
Visualizzazione di frammenti di codice nei post del blog e nei documenti
Scrivi un tutorial contenente <script> oppure <?php e incollalo in un CMS RAW e il browser proverà a farlo eseguire o ingoiare il tuo esempio invece di visualizzarlo. Ogni esempio di codice in un contesto HTML ha bisogno <, >, e & codificato. Lo faccio costantemente per la documentazione del plugin: leggimi HTML, articoli della knowledge base, esempi in linea nelle schede di aiuto dell'interfaccia utente di amministrazione. Il flusso di lavoro: scrivi lo snippet, eseguilo attraverso il codificatore di entità, incolla la versione evasa all'interno <pre><code>. trenta secondi, e il tuo <script> visualizza come <script> invece di svanire nel dom. Se stai creando un flusso di lavoro Documenti in generale, il nostro Guida agli strumenti di codifica Copre il resto della cassetta degli attrezzi attorno a questo.
Ripulire il testo a doppia fuga da database e feed
la &amp; piaga. Si manifesta quando un CMS sfugge durante il salvataggio, un plugin sfugge sul rendering e un livello di memorizzazione nella cache sfugge ancora una volta. Una volta ho spedito un registro delle modifiche WP Adminify in cui il parser readme di WordPress.org e il mio script di compilazione non erano d'accordo su chi scappa: il registro delle modifiche renderizzato ne aveva 23 visibili &s in esso prima che un utente mi inviasse un'e-mail. I feed RSS sono peggiori; il contenuto del feed viene spesso evaso dall'HTML interiore XML, quindi i consumatori lo sovra-o sotto-decodificano abitualmente La correzione è la decodifica diagnostica: incolla il testo rotto, decodifica un passaggio alla volta, conta quanti passaggi fino a quando it's pulisce Quel conteggio equivale al numero di livelli in fuga - ora sai esattamente quanti pezzi della tua pipeline toccano il testo, e puoi trovare quello ridondante.
Preparare i contenuti generati dagli utenti in modo sicuro
Commenti, testo di revisione, biografie del profilo, ticket di supporto: tutto ciò che un utente ha digitato non è attendibile e spesso contiene PII: nomi reali, e-mail, indirizzi Qui si scontrano due preoccupazioni Innanzitutto, sicurezza: quel contenuto deve essere codificato da entità all'output o tu're uno <img onerror=...> lontano da XSS memorizzato (chiedimi del campo delle impostazioni che ho quasi spedito). Secondo, privacy: quando stai debug perché un utente specifico's bio rompe il layout, you're handling their personal data - incollarlo in un convertitore lato server significa spedire PII a terzi Lo strumento Toolz.dev elabora tutto localmente, quindi testare le stringhe di problemi reali è sicuro Codifica il campione, ispeziona quale è il tuo modello dovere hanno prodotto, diff contro ciò che ha prodotto.
Modelli HTML e-mail
Email HTML è lo sviluppo web con un motore di rendering vecchio di 20 anni Alcuni client gestiscono UTF-8 grezzo fine; altri - a seconda di come i tuoi set ESP trasferiscono le codifiche - garble caratteri tipografici in mojibake La convenzione difensiva molti sviluppatori di posta elettronica ancora seguono: codificare la tipografia non ASCII come entità (—, ’, per gli hack di spaziatura) in modo che i byte sul filo siano puri ASCII. E ricorda ' da cima a fondo '- Outlook's motori più vecchi sono esattamente gli strumenti che non hanno mai imparato i nomi HTML5 Poiché i modelli vengono personalizzati con i nomi e gli indirizzi dei clienti, questo è di nuovo contenuto I & #39; d solo eseguire attraverso uno strumento lato client Codifica il modello cromo una volta, mantenere i campi di unione grezzi, sfuggirli al momento della fusione.
Decodifica del contenuto raschiato e delle risposte API
raschiare una pagina o consumare un'API sciatta e affogare ’, “, &, e . Alcune API restituiscono stringhe codificate da entità all'interno di JSON - un formato che non necessita affatto di escape HTML - in modo da ottenere artefatti come "title": "Fish & Chips". Prima che i dati entrino nel tuo database, decodificali per pulire UTF-8; memorizza il testo canonico, esca all'output. Lo colpisco costantemente durante l'importazione di contenuti in app Laravel: prima le entità di decodifica, poi bella stampa e ispezionare il carico utile con il Formattatore JSON. Farlo nell'altro ordine significa leggere JSON dove ogni apostrofo è lungo sette caratteri Se il payload è basato64-avvolto sopra di quello - alcuni fornitori di webhook fanno questo - il convertitore base64 gestisce lo strato esterno e il nostro Guida alla codifica Base64 Spiega perché esiste quel wrapping.
localizzare i contenuti con caratteri speciali
I file di traduzione arrivano in ogni stato immaginabile. Un fornitore invia UTF-8 pulito ü; un altro invia ü; un terzo invia ü; occasionalmente li ottieni tutti e tre in un file PO Prima dell'importazione, normalizzo tutto in UTF-8 grezzo con un passaggio di decodifica - archiviazione canonica, ricerca coerente, differenze sane Lo stesso vale per la punteggiatura RTL, parentesi CJK e latino accentato nelle stringhe spedite Decodifica all'importazione, memorizza caratteri reali e lascia che il tuo livello di output sfugga solo alle cinque speciali Anche i tuoi traduttori ti ringrazieranno: über Non è una parola che nessuno dovrebbe dover correggere.
Nominato vs decimale vs hex vs raw UTF-8: quale dovresti usare?
| forma | Esempio (em-dash) | leggibilità | Supporto per browser | Quando utilizzare |
|---|---|---|---|---|
| Entità nominata | — |
Buono - autodescrittivo | Universal per i nomi HTML4-era; nomi solo HTML5 (come ') Fallire nella vecchia attrezzatura |
I cinque speciali; contesti legacy come l'HTML di posta elettronica |
| riferimento decimale | — |
Povero - it's un numero | Universale, compresi gli antichi parser | caratteri senza nomi; fuga massima compatibilità (') |
| Riferimento esadecima | — |
Scarso, ma mappa ai punti di codice Unicode | universale in qualsiasi cosa lontanamente moderna | Quando si riferisce a grafici o specifiche Unicode incrociati |
| UTF-8 grezzo | — |
perfetto | Universale sulle pagine UTF-8 correttamente dichiarate | Tutto tipografico - questo dovrebbe essere il tuo default |
La mia posizione, chiaramente: Scrivi RAW UTF-8 per tipografia, entità di riserva per i cinque speciali e input non attendibili. un documento pieno di — e … è un documento che nessuno può correggere le bozze e segnala un flusso di lavoro che ha' t si fidava delle sue dichiarazioni di caratteri dal 2008. Stack moderni - WordPress, Laravel, Next.js, ogni database che tu'd scegli oggi - sono UTF-8 end to end Digita il personaggio reale.
Dove le entità guadagnano la loro mantenenza: &, <, >, ", e ' per tutto ciò che potrebbe essere interpretato come markup, sempre, nessuna eccezione, applicato al momento dell'output. E in ambienti di rendering ostili - client di posta elettronica, feed consumati da parser sconosciuti - i riferimenti numerici sono la scelta paranoica ma giustificata perché sono antecedenti a ogni argomento di compatibilità. Tra decimale ed esadecimale, it's taste; I lean hex perché — Corrisponde a u+2014 e posso smettere di fare conversioni di base nella mia testa.
Domande frequenti
Che cos'è un'entità HTML?
Un'entità HTML è una sequenza di testo che rappresenta un carattere invece di scrivere direttamente il carattere. Si inizia con una sapone e termina con un punto e virgola. Ci sono riferimenti denominati come & & ©, e riferimenti numerici come © (decimale) o © (hex) che puntano a un punto di codice Unicode. I browser li risolvono durante l'analisi, quindi < viene visualizzato come segno non inferiore a quello di aprire un tag. Esistono in modo da poter mostrare caratteri che altrimenti sarebbero interpretati come markup.
Quali caratteri devono essere evasi in HTML?
Cinque: la e commerciale, minore di, maggiore di, doppia citazione e singola citazione - scritta come & amp;, <, >, & quot;, e '. e commerciale, perché avvia entità; le parentesi angolari, perché delimitano i tag; le virgolette, perché delimitano i valori degli attributi In testo del corpo elemento si può farla franca con solo i primi tre, ma sfuggire a tutti e cinque ovunque è l'abitudine che non ti morde mai Tutto il resto - accenti, trattini, emoji - può essere grezzo UTF-8 su una pagina correttamente dichiarata.
Qual è la differenza tra < scritto come entità denominata e <?
Niente, una volta che il browser li analizza - entrambi producono un segno di meno-che Il modulo denominato è una ricerca nello standard WHATWG's tabella dei riferimenti con nome; < indirizza il punto di codice Unicode 60 direttamente, e < è lo stesso punto di codice in hex Le entità con nome sono più facili da leggere per gli esseri umani; i riferimenti numerici funzionano per tutti i caratteri, comprese le migliaia che non hanno nome Per le offerte speciali comuni, scegli qualunque cosa il tuo team trovi più leggibile - ai browser non importa.
Perché la mia pagina mostra &amp; invece di una e commerciale?
Doppio escape Un certo livello del tuo stack è sfuggito a una stringa già escape, girando & amp; in & amp; amp; Il browser decodifica un livello e visualizza l'avanzo Di solito significa che due componenti pensano entrambi che l'escape sia il loro lavoro - un CMS sul salvataggio più un modello sul rendering è la coppia classica Decodifica la stringa un passaggio alla volta in un decoder; il numero di passaggi fino a quando non legge pulito è uguale al numero di livelli che sfuggono Poi rendi responsabile esattamente un livello, al momento dell'output.
L'escape di HTML impedisce XSS?
Nei contesti di corpo e attributo HTML, sì - l'input non attendibile che codifica entità c'è la difesa principale, perché il payload rende come testo inerte Ma non è sufficiente ovunque Il Cheat Sheet di prevenzione XSS OWASP è esplicito che le stringhe JavaScript, gli URL e i CSS hanno bisogno ciascuno della propria codifica specifica per il contesto; la codifica delle entità all'interno di un blocco di script non fa nulla Fuggire all'output, nel contesto in cui stai emettendo, utilizzando quel contesto's encoder La codifica delle entità è uno strumento in quel kit, non l'intero kit.
Qual è la differenza tra HTMLSpecialChars e HTMLEntities in PHP?
htmlspecialchars () sfugge solo ai caratteri significativi del markup - e dovresti passare ENT_QUOTES in modo che copra la singola citazione. htmlentities () converte ogni carattere che ha un'entità con nome, quindi le lettere accentate diventano cose come il riferimento uuml. Nelle pagine UTF-8, htmlspecialchars () è quasi sempre ciò che desideri; htmlentities () gonfia l'output e causa mojibake quando i set di caratteri sono configurati in modo errato Gli sviluppatori di WordPress evitano per lo più la domanda utilizzando esc_html () ed esc_attr (), che applicano i flag giusti per contesto.
Dovrei usare l'entità denominata APOS per gli apostrofi?
Preferisci ' Il nome apos è valido in HTML5 ma non ha mai fatto parte di HTML4, quindi i parser più vecchi - inclusi i motori di rendering all'interno di alcuni client di posta elettronica - non lo riconoscono e lo visualizzeranno letteralmente Il modulo numerico ' significa lo stesso carattere e funziona in tutto ciò che è mai stato spedito È una scelta brutta ma sicura, che di solito è il giusto compromesso per fuggire Se sai che il tuo output colpisce solo i browser moderni, apos va bene; i modelli di posta elettronica sono esattamente dove non puoi saperlo.
È sicuro incollare i dati degli utenti in un convertitore di entità online?
Solo se lo strumento elabora il testo nel browser I modelli di contenuto e di posta elettronica generati dall'utente contengono abitualmente nomi, e-mail e altre PII e un convertitore che pubblica il tuo input su un server ha appena ricevuto tali dati senza alcun accordo in atto Il Toolz.dev HTML Entities Encoder/Decoder esegue il 100% lato client - nessun caricamento, nessuna registrazione e funziona offline una volta caricata la pagina Se non è possibile verificare come uno strumento gestisce l'input, non incollarvi i dati di produzione.
Fuga una volta, nel posto giusto
Se prendi una cosa da un decennio dei miei errori di fuga, prendi questo: esattamente uno strato del tuo stack dovrebbe scappare e dovrebbe essere il livello di output. Conservare pulito UTF-8. Fuggi dalle cinque offerte speciali al rendering del tempo, nel contesto in cui stai traendo. ciascuno &amp; in produzione c'è una mappa di due componenti che combattono per quel lavoro - e ogni stringa utente non recuperata è un XSS memorizzato in attesa di una revisione del codice che potrebbe non accadere Il mio quasi lo fece' t.
Tieni il Entità HTML/Decoder nella rotazione del debug insieme ai suoi fratelli: il Encoder/decoder URL Per contesti di codifica percentuale (il Guida alla codifica URL Passa attraverso %2520, il cugino che codifica in percentuale di &amp;), il convertitore base64 per carichi utili avvolti e il convertitore di borsa per il lavoro di ridenominazione dell'identificatore tra di loro. la Guida agli strumenti di codifica Cammina l'intero set.
E poiché le stringhe che esegui il debug sono così spesso qualcuno's nome o email effettivi: tutto quanto sopra viene eseguito lato client, nulla caricato, verificabile nella scheda di rete That's non marketing - it's il motivo per cui ho costruito questi strumenti nel modo in cui l'ho fatto Più su quella filosofia nel Guida alla privacy dei dati.


