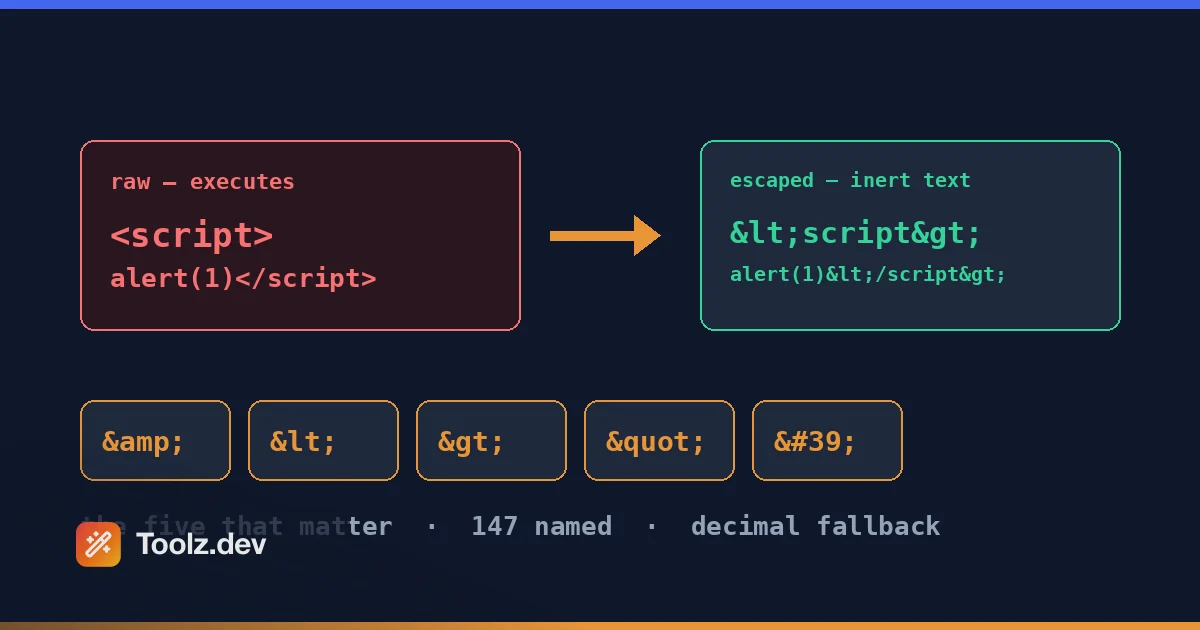
Por volta de 2021, um ticket de suporte do WP Adminify pousou com uma captura de tela que ainda me faz estremecer Um usuário havia definido um texto de rodapé de administrador personalizado - uma linha de direitos autorais perfeitamente inocente com um © e um link para sua agência. Na tela, ele renderizou como © 2021 — Bright & Co. Três entidades visíveis, zero caracteres renderizados. O culpado era eu. Minha rotina de salvamento escapou do texto, minha rotina de renderização escapou novamente e, em algum lugar entre um filtro, escapou pela terceira vez. Quando chegou ao navegador, aquele pobre comercial havia escapado quatro vezes. eu contei.
A correção demorou dez minutos. Encontrar isso levou duas noites, porque o texto Escapeia parece quase Certo. você desnata © Em um despejo de banco de dados e seu cérebro corrige automaticamente para ©. Acabei colando strings em um arquivo HTML de rascunho várias vezes apenas para ver o que o navegador realmente renderiza em cada camada. Esse é um fluxo de trabalho miserável e é exatamente por isso que um decodificador de entidade HTML é uma das primeiras ferramentas que incorporei ao Toolz.dev.
O outro lado da mesma moeda é mais assustador. Alguns meses antes desse ticket, durante uma revisão de código do meu próprio plugin, encontrei um campo de configurações que ecoava a entrada do usuário em um aviso do administrador sem esc_html(). Qualquer pessoa com acesso a esse campo poderia ter armazenado <script> e tinha-o executado para cada administrador que carregava a página XSS armazenado, no meu próprio código, uma chamada de função ausente Away Ninguém explorou - Eu tive sorte Mas mudou permanentemente como EU penso sobre escapar: it' s não é uma tarefa de formatação, it' s o limite entre & quot; text" e & quot; code."
Então este guia cobre ambas as direções Codificação, então texto não confiável permanece texto Decodificação, para que você possa ler o que algum pipeline excessivamente ansioso mutilou E teoria suficiente - referências nomeadas vs numéricas, os cinco caracteres que realmente importam, por que a ordem das operações causa escape duplo - que você pode depurar essas coisas em vez de adivinhar.
tl;dr: Cole seu texto no Toolz.dev HTML Entidades codificador/decodificador para converter entre caracteres brutos e entidades em qualquer direção - nomeado, decimal ou hex. Ele roda 100% do lado do cliente, para que o conteúdo do usuário e as PII nunca saiam do seu navegador. Regra prática: sempre escape dos cinco especiais (
& < > " ') na entrada não confiável e codificar&Primeiro ou você vai escapar duas vezes.
Principais características
Codifique e decodifique em ambas as direções
Metade do tempo eu preciso virar <script> em <script> então ele exibe como texto em um post do blog A outra metade I & #39; estou indo na direção oposta - transformando um raspado &#8217;s Voltar para um apóstrofo legível A ferramenta lida com ambos Colar texto, escolher codificar ou decodificar, feito Não modo-caça, sem ferramentas separadas para cada direção Isso soa trivial até que você' usei ferramentas que apenas decodificam, e você se encontra abrindo uma segunda guia para codificar uma amostra de código para seus docs Round-tripping também é uma grande verificação de sanidade: codificar, decodificar, e confirmar que você obter a sua string original de volta Se você não & #39; t, algo em sua entrada já foi parcialmente escapou - que é em si informação útil.
Entidades nomeadas: &amp;, &lt;, &copy; e amigos
As referências de personagens nomeados são as legíveis por humanos - & para &, < para <, © Para ©, — para um em-traço. A ferramenta carrega uma tabela com curadoria de 147 nomes, não apenas os famosos cinco: tipografia ( , …, ’, “), moeda, matemática e setas, letras gregas, o intervalo completo com sotaque latino-1 e algumas probabilidades como naipes de cartas Esse intervalo é o que o conteúdo do mundo real realmente precisa - o WordPress emite , …, e ’ Através do WPtexturize constantemente, e um decodificador que conhece apenas uma dúzia de nomes deixa metade do seu texto repleto de referências não resolvidas.
Seja claro sobre o que não é 147: o QUEWG O Padrão HTML define mais de 2.200 referências nomeadas, portanto, este é um subconjunto prático, em vez da tabela completa Se um nome é & #39; t nele, a decodificação deixa a referência intocada em vez de adivinhar - &bogus; sai como &bogus;. A codificação tem o comportamento complementar e é a metade mais útil: qualquer caractere sem Um nome na tabela volta a uma referência numérica decimal automaticamente, para que nada seja descartado silenciosamente. Um emoji codifica como 🌍, texto chinês como 你好. Nomes onde existem, números em todos os outros lugares.
Mais uma divergência do comportamento do navegador que vale a pena conhecer: o decodificador diferencia maiúsculas de minúsculas e requer o ponto e vírgula. Os navegadores serão resolvidos © E até mesmo um nu & sem ponto e vírgula em alguns contextos de análise, graças às regras de compatibilidade legadas; este decodificador não resolve nenhum dos dois. Na prática, tudo bem - qualquer coisa é uma ferramenta moderna gera é minúsculo e encerrado - mas se você & #39; está decodificando HTML raspado de um CMS antigo, isso & #39; é a vantagem que você & #39; vai bater.
Referências numéricas: decimal e hexadecimal
Qualquer Unicode o caractere pode ser escrito como uma referência numérica de caractere - semelhante a um decimal — ou hex como — (ambos são um em-traço). O decodificador resolve os dois formulários. Esta é a escotilha de escape para personagens que não têm nome no padrão, e é a forma que você encontrará constantemente em respostas de API e feeds RSS, onde ’ (citação única direita) é praticamente uma assinatura As referências hexadecimais mapeiam diretamente para pontos de código Unicode - U+2014 is —- e é por isso que EU prefiro-los quando I & #39; m referência cruzada contra um gráfico Unicode.
Limitação honesta, pois você notará isso dentro de um minuto após usar a ferramenta: o numérico codificar O modo emite apenas decimal. Não há opção de saída hexadecimal. decifração — funciona bem; pedir ao codificador para produzi-lo não & #39; t. Os dois formulários são semanticamente idênticos a todos os navegadores, então isso não custa nada funcionalmente, mas se sua base de código padronizar em hex you& #39; estará convertendo à mão It& #39; s na minha lista. Referências fora de alcance são capturadas em vez de mutiladas - � está acima do máximo Unicode e retorna um erro explícito em vez de um caractere de substituição.
Cobertura completa do Unicode
Emoji, caracteres CJK, árabe, combinando diacríticos, as obras Se ele tem um ponto de código, a ferramenta pode expressá-lo como uma entidade e resolvê-lo de volta Isso importa mais do que você'd pensar para o trabalho de localização - I've depurado alemão tremas chegando como ü De um fornecedor de tradução e como UTF-8 bruto ü de outro, no mesmo arquivo de importação. Uma ferramenta que se enganchia fora do Latin-1 é inútil para isso. Os personagens acima de U+FFFF (emoji ao vivo) são tratados corretamente como pontos de código único, não pares substitutos mutilados.
Desembaraça texto com duas escapadas
o &amp; problema. Quando duas camadas de um pipeline escapam, & torna-se &amp;- e três camadas dão a você &amp;amp;. A decodificação uma vez descasca exatamente uma camada, para que você possa executar o decodificador repetidamente e assistir o desembrulhar da cebola: &amp;amp; → &amp; → & → &. A contagem das passagens informa quantas camadas da sua pilha estão escapando, que é precisamente o diagnóstico que eu precisava durante aquele bug de rodapé de adminsidade do WP quatro vezes. Uma decodificação por camada. É a maneira mais rápida que conheço de localizar onde, em um pipeline, o escape extra acontece.
Painéis lado a lado com contagem de personagens
Entrada à esquerda, saída à direita, contagem de caracteres acima de ambos Esse par de contagem faz mais trabalho do que parece: escapar é uma operação em expansão, então se você codificar 40 caracteres e obter 44 de volta, exatamente um caractere especial foi tocado Quando I & #39; m auditando se um modelo já escapou de algo, o delta me diz antes de I & #39; li um único caractere de saída Codificar, Decodificar, Trocar e Limpar são botões - lá & #39; não é conversão ao vivo como você, que I & #39; admitirá é uma troca deliberada às vezes me arrependo Ações explícitas significam que você sempre sabe qual direção produziu o texto você & #39; está olhando, e com bugs de escape que a ambiguidade é todo o problema Mas para cutucar exploratório, uma versão orientada por pressionamento de tecla seria genuinamente mais agradável.
100% do lado do cliente - nada carregado
Tudo é executado no seu navegador Sem solicitação, sem servidor, sem logs Este é & #39; t um bom-para-ter: o texto you're escape é muitas vezes exatamente o texto que você deve' t colar em sites aleatórios - comentários gerados pelo usuário com nomes reais, modelos de e-mail com endereços de clientes, conteúdo de ticket de suporte I & #39; já escreveu antes sobre por que isso importa em Nosso guia de privacidade de dados; A versão curta é que um conversor que carrega sua entrada é um processador de dados que você nunca fez. o Ferramenta de entidades Toolz.dev funciona offline uma vez carregado O modo avião é um teste válido - tente.
Como usar o codificador e decodificador de entidade HTML
Etapa 1: abra a ferramenta e cole seu texto
ir a Toolz.dev/tools/html-entities e cole sua entrada - um trecho de código, um trecho RSS mutilado, um fragmento de modelo de e-mail, tanto faz. Não há teto de tamanho com o qual valha a pena se preocupar para uso normal; I & #39; colou changelogs de plugins renderizados inteiros. Como o processamento é do lado do cliente, o conteúdo sensível está bem aqui.
Etapa 2: escolha codificar ou decodificar
A codificação transforma caracteres brutos em entidades (< → <) - use-o quando quiser que a marcação seja exibida como texto A decodificação resolve entidades de volta aos caracteres (& → &) - use - o quando você & #39; estiver a ler conteúdo escapado Se você & #39; não tiver a certeza em que estado se encontra o seu texto, descodifique primeiro e veja o que muda A saída inalterada significa que já estava simples.
Etapa 3: escolha o estilo de referência (ao codificar)
O menu suspenso de modos tem exatamente três opções, e a escolha importa mais do que parece. nomeado codifica tudo o que tem um nome e cai decimal para o resto - legível em fonte e diffs, mas também escapa ©, —, é E todos os outros caractere não-ASCII, que incham a saída se você estiver no UTF-8 de qualquer maneira. numérico Faz a mesma cobertura em decimal puro. Somente caracteres especiais não toca nada, mas & < > " ' e deixa seus sotaques, traços eletrônicos e emoji como UTF-8 bruto - este é o que uso para conteúdo real, e é o modo que corresponde a quê htmlspecialchars() faz em PHP. Observe que ' sempre sai como ', nunca ', em todos os três modos; isso é deliberado, pois ' É indefinido em HTML 4 e clientes de e-mail mais antigos ainda se engancham.
Etapa 4: verifique a saída e copie
Clique em codificar ou decodificar e leia o painel direito. Para trabalhos de decodificação, procure especificamente sobras & sequências - um sobrevivente significa que o texto escapou duas vezes, então clique em Trocar e decodificar novamente. Quando estiver limpo, copie o resultado em seu modelo, CMS ou código. Para trabalhos repetidos, viagem de ida e volta uma vez (codifique e depois decodifique) para confirmar que nada de com perdas aconteceu; no modo somente para chars especiais, a viagem de ida e volta é exata.
Entidades nomeadas versus numéricas - e os cinco personagens que realmente importam
Deixe o & #39; s obter a terminologia em linha reta, porque o & quot; entidade HTML" é usado livremente O WHATWG HTML Standard - a especificação viva que define como os navegadores realmente analisam HTML - especifica uma tabela de Referências de personagens nomeados: mais de 2.200 nomes como , —, …, →, cada mapeamento para um ou dois pontos de código Unicode. separadamente, Referências de personagens numéricos Permite que você endereça qualquer ponto de código diretamente: Decimal (—) ou hexadecimal (—). O mesmo em-dash, três grafias.
Aqui está minha opinião opinativa, aprimorada por anos de trabalho do WordPress: Desses mais de 2.200 nomes, apenas cinco personagens realmente importam para a exatidão e segurança. Todo o resto é tipografia, e em uma página UTF-8 - que é cada página que você deve enviar em 2026 - você pode simplesmente digitar o personagem real Você não precisa & #39; t precisa —; você precisa - . Os cinco que importam são aqueles com significado sintático em HTML:
| personagem | pessoa | Por que é importante |
|---|---|---|
& |
& |
Inicia cada entidade - o próprio personagem de fuga |
< |
< |
abre tags |
> |
> |
fecha tags |
" |
" |
Delimita atributos com aspas duplas |
' |
' |
Delimita atributos de aspas simples |
Observe a última linha: ', não '. o nome ' é válido em HTML5, mas era & #39; t parte do HTML4, e ferramentas antigas (e clientes de e-mail antigos - mais sobre aqueles posteriores) podem tropeçar nele O formulário numérico funciona em todos os lugares Este é o tipo de pedantismo que salva um relatório de bug confuso.
Ordem das operações é o jogo inteiro. Ao codificar, & deve ser escapado primeiro. Se você escapar < até < E, em seguida, escapar dos e comercial, você converterá sua própria saída em &lt;- parabéns, você e #39; escaparam duas vezes. Decodificação é a imagem espelhada: & deve ser resolvido antecede, ou &lt; torna-se < torna-se < e você & #39; under-decoded (ou pior, re-introduzido marcação ao vivo de texto que foi deliberadamente escapou) Quase todos os bug de escape enrolado à mão I & #39; revisou - incluindo o meu próprio - é um bug de ordenação.
O contexto é importante, e é aí que o escape encontra-se em segurança. A folha de dicas de prevenção de scripts do OWASP é contundente: a codificação de entidade HTML é a defesa correta para o HTML cadáver e atributo contextos, mas é não Suficiente para strings, URLs ou CSS do JavaScript. < Dentro de um <script> block does' t decodificar - conteúdo de script isn' t analisado para entidades - então a codificação de entidade não faz nada de útil lá Cada contexto precisa de seu próprio codificador: codificação de entidade para HTML, \uXXXX Escapando para strings JS, codificação por cento para URLs (é o que é nosso Codificador/decodificador de URL é para). Usar o codificador correto no contexto errado é a maneira clássica de como o código de aparência sanitizada permanece explorável.
do lado do PHP, conheça suas duas funções. htmlspecialchars() Escapa apenas dos cinco especiais (PASS ENT_QUOTES ou você perde a única citação - um verdadeiro gotcha). htmlentities() fugas tudo que possui uma entidade nomeada, virando ü em ü. Nas páginas UTF-8, htmlentities() É quase sempre a escolha errada; incham a saída e murmura o conteúdo quando os charsets são mal declarados. WordPress envolve isso de forma sensata:
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() e esc_attr() ambos escapam dos cinco especiais com os sinalizadores certos, escolhidos por contexto - exatamente a disciplina de fuga tardia que o OWASP prescreve A regra que EU perfuro em cada revisão de código: escape no momento da saída, no contexto output' s, exatamente uma vez.
O que o traz para casa: com o UTF-8, raramente você necessidade Entidades para personagens tipográficos. Você precisa deles para caracteres significativos e para entradas não confiáveis. Todo o resto é um hábito legado.
Casos de uso comuns
Exibindo trechos de código em postagens de blog e documentos
Escreva um tutorial contendo <script> ou <?php e cole-o em um CMS Raw, e o navegador tentará Executar ou engolir Seu exemplo em vez de exibi-lo. Cada amostra de código em um contexto HTML precisa <, >, e & codificado. Faço isso constantemente para documentação de plugins - leia-me HTML, artigos de base de conhecimento, exemplos inline em guias de ajuda da UI de administrador. O fluxo de trabalho: escreva o trecho, execute-o através do codificador de entidade, cole a versão escape dentro <pre><code>. Trinta segundos, e seu <script> exibe como <script> Em vez de desaparecer no DOM. Se você estiver criando um fluxo de trabalho do Documentos em geral, nosso Guia de ferramentas de codificação Cobre o restante da caixa de ferramentas em torno disso.
Limpando o texto com fuga dupla de bancos de dados e feeds
o &amp; praga. Ele aparece quando um CMS escapa no save, um plugin escapa no render e uma camada de cache escapa mais uma vez. Certa vez, enviei um changelog WP Adminify onde o analisador wordpress.org readme e meu próprio script de construção discordavam sobre quem escapava - o changelog renderizado tinha 23 visíveis &s nele antes de um usuário me enviar um e-mail. Os feeds RSS são piores; o conteúdo do feed geralmente é escapado do HTML interior XML, então os consumidores rotineiramente sobre - ou sub-decodificar-lo A correção é decodificação de diagnóstico: colar o texto quebrado, decodificar uma passagem de cada vez, contar quantas passagens até que ele' s limpo Essa contagem é igual ao número de camadas escapando - agora você sabe exatamente quantas peças de seu pipeline estão tocando o texto, e você pode encontrar o redundante.
Preparando o conteúdo gerado pelo usuário com segurança
Comentários, texto de revisão, biografias de perfil, tickets de suporte - qualquer coisa que um usuário digitou não é confiável, e frequentemente contém PII: nomes reais, e-mails, endereços Duas preocupações colidem aqui Primeiro, segurança: esse conteúdo deve ser codificado por entidade na saída ou você're um <img onerror=...> Longe do XSS armazenado (pergunte-me sobre o campo de configurações que quase enviei). Em segundo lugar, privacidade: quando você está depurando por que um usuário específico' s bio quebra seu layout, você're manipulação de seus dados pessoais - colá-lo em um conversor do lado do servidor significa enviar PII para um terceiro A ferramenta Toolz.dev processa tudo localmente, então testar cadeias de problemas reais é seguro Codificar a amostra, inspecionar o que seu modelo deveria produziram, diff contra o que produziu.
Modelos de HTML de e-mail
Email HTML é o desenvolvimento web com um motor de renderização de 20 anos de idade, Alguns clientes lidam com UTF-8 bruto fino; outros - dependendo de como seus conjuntos ESP transferir codificações - garble caracteres tipográficos em mojibake A convenção defensiva muitos desenvolvedores de e-mail ainda seguem: codificar tipografia não-ASCII como entidades (—, ’, para espaçamentos de hacks) para que os bytes no fio sejam ASCII puros. E lembre-se ' acima de '- Outlook' s motores mais antigos são exatamente o ferramental que nunca aprendeu nomes HTML5 Desde modelos obter personalizado com nomes de clientes e endereços, este é novamente conteúdo I & #39; d só executar através de uma ferramenta do lado do cliente Codificar o modelo chrome uma vez, manter campos de mesclagem em bruto, escapar deles no momento da mesclagem.
Decodificando conteúdo raspado e respostas de API
Raspe uma página ou consuma uma API desleixada e você se afogará ’, “, &, e . Algumas APIs retornam strings codificadas por entidades dentro do JSON - um formato que não precisa de nenhum escape de HTML - para que você obtenha artefatos como "title": "Fish & Chips". Antes que os dados entrem em seu próprio banco de dados, decodifique-os para limpar UTF-8; armazene texto canônico, escape na saída. Eu apertei isso constantemente ao importar conteúdo para os aplicativos Laravel: decodificar entidades primeiro, então Imprima e inspecione a carga útil com o formatador json. Fazer isso na outra ordem significa ler JSON onde cada apóstrofo tem sete caracteres Se a carga útil estiver embrulhada em base64 em cima disso - alguns provedores de webhook fazem isso - o conversor de base64 Manuseia a camada externa e nosso Guia de codificação de base64 Explica por que existe esse embrulho.
Localizando conteúdo com caracteres especiais
Os arquivos de tradução chegam em todos os estados imagináveis. Um fornecedor envia UTF-8 limpo ü; outro envia ü; um terceiro envia ü; ocasionalmente você obtém todos os três em um arquivo PO. Antes de importar, EU normalizo tudo para UTF-8 bruto com uma passagem de decodificação - armazenamento canônico, pesquisa consistente, diferenças sãs O mesmo se aplica à pontuação RTL, colchetes CJK e latim acentuado em strings enviadas Decodificar na importação, armazenar caracteres reais e deixar sua camada de saída escapar apenas dos cinco especiais Seus tradutores também agradecerão: über Não é uma palavra que alguém deveria ter que revisar.
Nomeado vs decimal vs hex vs raw UTF-8: qual você deve usar?
| formar | Exemplo (em-traço) | legibilidade | Suporte ao navegador | Quando usar |
|---|---|---|---|---|
| Entidade nomeada | — |
Bom - autodescritivo | Universal para nomes da era HTML4; nomes somente HTML5 (como ') falhar em ferramentas antigas |
Os cinco especiais; contextos legados, como HTML de e-mail |
| referência decimal | — |
Pobre - it' é um número | Universal, incluindo parsers antigos | Personagens sem nomes; escapamento de compatibilidade máxima (') |
| Referência hexadecimal | — |
Pobre, mas mapas para pontos de código Unicode | Universal em qualquer coisa remotamente moderna | Quando referenciar gráficos ou especificações do Unicode cruzados |
| UTF-8 bruto | — |
perfeito | Universal em páginas UTF-8 devidamente declaradas | Tudo tipográfico - este deve ser o seu padrão |
Minha postura, claramente: Escreva UTF-8 bruto para tipografia, entidades de reserva para os cinco especiais e entradas não confiáveis. um documento cheio de — e … é um documento que ninguém pode revisar e sinaliza um fluxo de trabalho que tem & #39; confiou em suas declarações de conjunto de caracteres desde 2008. pilhas modernas - WordPress, Laravel, Next.js, todos os bancos de dados que você e #39; escolher hoje - são UTF-8 de ponta a ponta Digite o caractere real.
Onde as entidades ganham seu sustento: &, <, >, ", e ' para qualquer coisa que possa ser interpretada como marcação, sempre, sem exceções, aplicada no momento da saída E em ambientes de renderização hostis - clientes de e-mail, feeds consumidos por analisadores desconhecidos - as referências numéricas são a escolha paranóica, mas justificada, porque são anteriores a todo argumento de compatibilidade entre decimal e hex, gosto it' s; Eu me inclino hex porque — Corresponde a U+2014 e posso parar de fazer conversões básicas na minha cabeça.
Perguntas frequentes
O que é uma entidade HTML?
Uma entidade HTML é uma seqüência de texto que representa um caractere em vez de escrever o personagem diretamente. Começa com um e comercial e termina com um ponto e vírgula. Existem referências nomeadas como & e © e referências numéricas como © (decimal) ou © (hex) que apontam para um ponto de código Unicode. Os navegadores os resolvem durante a análise, então o < é exibido como um sinal inferior ao em vez de abrir uma tag. Eles existem para que você possa mostrar personagens que de outra forma seriam interpretados como marcação.
Quais caracteres devem ser escapados em HTML?
Cinco: o ampersand, less-than, larger-than, double quote e single quote - escrito como & amp;, & lt;, & gt;, & quot;, e '. Ampersand, porque inicia entidades; os colchetes angulares, porque delimitam tags; as aspas, porque delimitam valores de atributos No texto do corpo do elemento você pode se safar apenas com os três primeiros, mas escapar de todos os cinco em todos os lugares é o hábito que nunca morde você Todo o resto - acentos, traços, emoji - pode ser UTF-8 bruto em uma página devidamente declarada.
Qual é a diferença entre < escrito como uma entidade nomeada e <?
Nada, uma vez que o navegador os analisa - ambos produzem um sinal de menor que. O formulário nomeado é uma pesquisa no padrão WHATWG' s tabela de referências nomeadas; < endereços de código Unicode ponto 60 diretamente, e & #x3 C; é o mesmo ponto de código em hex. Entidades nomeadas são mais fáceis para os seres humanos lerem; referências numéricas funcionam para todos os caracteres, incluindo milhares que não têm nome Para as especiais comuns, escolha o que sua equipe achar mais legível - os navegadores não se importam.
Por que minha página mostra &amp; em vez de um e comercial?
Escapar duplamente Alguma camada da sua pilha escapou a uma cadeia já escapada, virando o & amp; para o & amp; O navegador descodifica um nível e mostra as sobras Geralmente significa que dois componentes pensam que escapar é o seu trabalho - um CMS em salvar mais um modelo em render é o par clássico Decodificar a cadeia uma passagem de cada vez num descodificador; o número de passagens até ler limpo é igual ao número de camadas que escapam dele Então faça exatamente uma camada responsável, no momento da saída.
O escapamento de HTML impede o XSS?
Em contextos de corpo e atributo HTML, sim - entrada não confiável de codificação de entidade há a defesa central, porque a carga útil é renderizada como texto inerte. Mas não é suficiente em todos os lugares. A folha de dicas de prevenção OWASP XSS é explícita que cadeias de caracteres JavaScript, URLs e CSS precisam de sua própria codificação específica de contexto; a codificação de entidade dentro de um bloco de script não faz nada. Escape na saída, no contexto para o qual você está enviando, usando esse codificador context' s. A codificação de entidade é uma ferramenta desse kit, não o kit completo.
Qual é a diferença entre HTMLSpecialchars e HTMLEntities em PHP?
htmlspecialchars () escapa apenas dos caracteres significativos de marcação - e você deve passar ENT_QUOTES para que cubra a única citação. htmlentities () converte cada caractere que tem uma entidade nomeada, então letras acentuadas tornam-se coisas como a referência uuml Nas páginas UTF-8, htmlspecialchars () é quase sempre o que você deseja; htmlentities () incha a saída e causa mojibake quando os charsets são mal configurados Os desenvolvedores do WordPress evitam principalmente a pergunta usando esc_html () e esc_attr (), que aplicam os sinalizadores certos por contexto.
Devo usar o APOS nomeado Entity for Apostrophes?
Prefira o & #39; O nome apos é válido em HTML5 mas nunca fez parte do HTML4, por isso os analisadores mais antigos - incluindo os motores de renderização dentro de alguns clientes de e - mail - não o reconhecem e irão exibi - lo literalmente A forma numérica & #39; significa o mesmo carácter e funciona em tudo o que foi enviado É uma escolha feia mas segura, que é normalmente o trade - off certo para escapar Se souber que a sua saída só chega aos navegadores modernos, o apos está bem; os modelos de e - mail estão exactamente onde não pode saber isso.
É seguro colar dados do usuário em um conversor de entidades online?
Somente se a ferramenta processar texto no seu navegador O conteúdo gerado pelo usuário e os modelos de e-mail contêm rotineiramente nomes, e-mails e outras PII, e um conversor que publica sua entrada em um servidor acaba de receber esses dados sem acordo em vigor O codificador/decodificador de entidades HTML Toolz.dev é executado 100% no lado do cliente - sem upload, sem registro e funciona offline depois que a página for carregada Se você não puder verificar como uma ferramenta lida com a entrada, não cole os dados de produção nela.
Escape uma vez, no lugar certo
Se você pegar uma coisa de uma década de meus erros de fuga, execute o seguinte: exatamente uma camada da sua pilha deve escapar e deve ser a camada de saída. Armazenar UTF-8 limpo. Escape os cinco especiais no momento da renderização, no contexto em que você está renderizando. todos &amp; em produção está um mapa de dois componentes lutando por esse trabalho - e cada string de usuário não escapada é um XSS armazenado esperando por uma revisão de código que pode não acontecer Meu quase não & #39; t.
mantenha o Encoder/decodificador de entidades HTML na sua rotação de depuração ao lado de seus irmãos - o Codificador/decodificador de URL Para contextos de codificação por cento (o Guia de codificação de URL passa por %2520, o primo de codificação por cento de &amp;), o conversor de base64 para cargas úteis embrulhadas e o conversor de caixa Para o trabalho grunhido de renomeação de identificador entre eles. o Guia de ferramentas de codificação Anda todo o conjunto.
E como as strings que você depura são muitas vezes o nome ou e-mail real de alguém e #39;: tudo acima é executado no lado do cliente, nada carregado, verificável na guia da sua rede. Isso e #39; não é marketing - é a razão pela qual construí essas ferramentas da maneira que fiz. Mais sobre essa filosofia no Guia de privacidade de dados.


