Примерно в 2021 году билет поддержки WP Adminify получил скриншот, который все еще заставляет меня вздрогнуть. Пользователь установил собственный текст нижнего колонтитула администратора - совершенно невинную строку авторских прав с © и ссылка на их агентство. На их экране он отображается как © 2021 — Bright & Co, йо- Три видимые сущности, нулевые символы. Виновником был я. Моя процедура сохранения избежала текста, моя процедура рендеринга снова избежала его, а где-то между фильтром выбежали из него третий раз. К тому времени, когда он попал в браузер, этот бедный Амперсанд сбежал четыре раза. Я посчитал.
Исправление заняло десять минут. Нахождение этого заняло два вечера, потому что сбежавший текст выглядит почти вправо. ты снимаешь © в дампе базы данных, и ваш мозг автоматически исправляет его ©, йо- В итоге я снова и снова вставлял строки в файл Scratch HTML, просто чтобы посмотреть, что на самом деле будет отображать браузер на каждом уровне. Это несчастный рабочий процесс, и именно поэтому декодер Endocer Entity-энкодера HTML является одним из первых инструментов, которые я встроил в Toolz.dev.
Обратная сторона той же монеты страшнее. За несколько месяцев до этого билета во время проверки кода моего собственного плагина я нашел поле настроек, которое перекликало ввод пользователя в уведомление администратора без esc_html(), йо- Любой, у кого есть доступ к этому полю, мог сохранить <script> и если бы он выполнялся для каждого администратора, загрузившего страницу. Сохраненный XSS, в моем собственном коде, один недостающий вызов функции. Никто не воспользовался этим - мне повезло. Но это навсегда изменило то, как я думаю о побеге: it's не работа по форматированию, it's граница между "text" и "code."
Итак, это руководство охватывает оба направления. кодирование, поэтому ненадежный текст остается текстом. декодирование, чтобы вы могли прочитать, что исказил какой-то слишком нетерпеливый конвейер. И достаточно теории - именованные и числовые ссылки, пять символов, которые действительно имеют значение, почему порядок операций вызывает двойной выход - что вы можете отладить этот материал вместо того, чтобы угадывать.
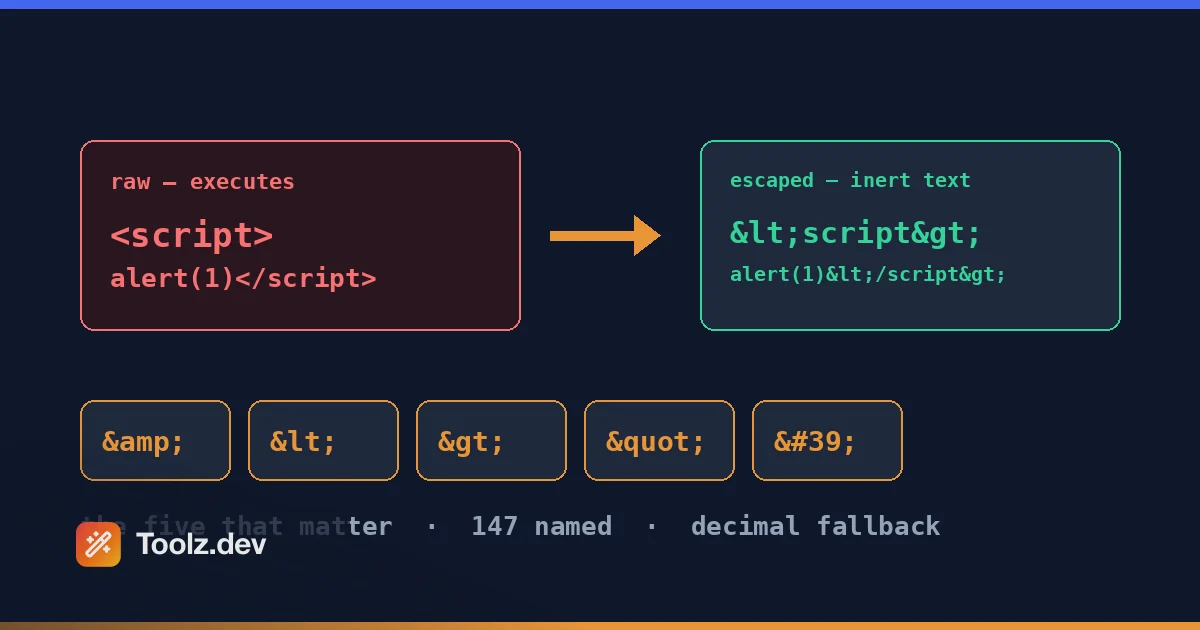
TL;DR: Вставьте свой текст в Toolz.dev сущности HTML кодировщик/декодер для преобразования между необработанными символами и сущностями в любом направлении - именованном, десятичном или шестнадцатеричном. Он работает на 100% клиентской стороне, поэтому пользовательский контент и PII никогда не покидают ваш браузер. эмпирическое правило: всегда избегайте пяти специальных предложений (
& < > " ') в ненадежных вводах и кодировать&Сначала или вы двойной побег.
Основные характеристики
Кодировать и декодировать в обоих направлениях
половину времени мне нужно повернуть <script> в <script> так что он отображается как текст в блоге пост. другая половина I'm идет противоположным путем - поворачивая скребком &#8217;s обратно в читаемый апостроф. инструмент обрабатывает и то, и другое. Вставить текст, выбрать кодирование или декодировать, сделано. нет поиска режима, нет отдельных инструментов для каждого направления. Это звучит тривиально, пока вы ' не использовали инструменты, которые только декодируют, и вы обнаруживаете, что открываете вторую вкладку для кодирования образца кода для ваших документов. Круглый отбор также является отличной проверкой здравомыслия: кодируйте, декодируйте и подтверждайте, что вы получаете обратно исходную строку. Если вы не сделаете 't, что-то на вашем входе уже частично удалось избежать - что само по себе является полезной информацией.
Именованные сущности: &, &lt;, &copy; и друзья
Именованные отсылки к персонажам удобочитаемы - & для &, < для <, © для ©, — Для EM-Dash. Инструмент несет в себе кураторскую таблицу из 147 имен, а не только знаменитую «пятерку: типографику» ( , …, ’, “), валюта, математика и стрелки, греческие буквы, полный диапазон с акцентом на латиницу-1, и несколько коэффициентов, как карточные масти. этот диапазон - то, что действительно нужно реальному контенту - WordPress излучает , …, и ’ Через WPTexturize постоянно, и декодер, который знает только дюжину имен, оставляет половину вашего текста, заваленного неразрешенными ссылками.
Уточните, чем не является 147: the WHATWG Стандарт HTML определяет более 2200 именных ссылок, так что это практическое подмножество, а не полная таблица. если имя в нем 't, декодирование оставляет ссылку нетронутой, а не угадывает - &bogus; выходит как &bogus;, йо- Кодировка имеет дополнительное поведение, и это более полезная половина: любой символ без Имя в таблице автоматически возвращается к десятичной числовой ссылке автоматически, поэтому ничего не отбрасывается. Эмодзи кодирует как 🌍, китайский текст как 你好, йо- Названия, где они существуют, номера везде.
Еще одно отличие от поведения браузера, которое стоит знать: декодер чувствителен к регистру и требует точки с запятой. Браузеры разрешат © И даже голый & без задней точки с запятой в некоторых контекстах синтаксического анализа благодаря устаревшим правилам совместимости; этот декодер не решает ни того, ни другого. На практике это 's хорошо - все, что является современным инструментом вырабатывает строчные и завершенные - но если вы 're декодирование очищенного HTML с древней CMS, то 's край вы 'll ударить.
Числовые ссылки: десятичные и шестнадцатеричные
Любой Юникод символ можно записать как числовую характеристику символа - десятичную — или гекс как — (оба - em-dash). Декодер разрешает обе формы. Это люк для персонажей, у которых нет имени в стандарте, и это форма, которую вы будете постоянно встречать в ответах API и RSS-канале, где ’ (правая одиночная цитата) - это практически подпись. шестигранные ссылки отображаются непосредственно в кодовые точки Юникода - U+2014 является —- вот почему я предпочитаю их, когда I'm сопоставляет диаграмму Юникода.
Честное ограничение, так как вы заметите его в течение минуты после использования инструмента: числовой кодировать Режим излучает только десятичную дробь. Нет опции HEX-вывода. декодирующий — работает нормально; просить энкодер произвести его не 't. две формы семантически идентичны каждому браузеру, так что это ничего не стоит вам функционально, но если ваша кодовая база стандартизирует на хекс вы ' будет конвертировать вручную. It's в моем списке. Вне диапазона ссылки пойман, а не искажен - � находится выше максимума Unicode и возвращает явную ошибку вместо символа замены.
Полное покрытие Unicode
Эмодзи, символы CJK, арабский, комбинируя диакритические знаки, работы. если у него есть кодовая точка, инструмент может выразить ее как сущность и разрешить обратно. это имеет большее значение, чем вы 'd подумать для работы по локализации - I've отладил немецкие умлауты, прибывающие как ü от одного поставщика перевода и как RAW UTF-8 ü из другого, в том же файле импорта. Инструмент, который задыхается от латинской 1, для этого бесполезен. Символы над u+ffff (смайли с эмодзи там) обрабатываются правильно как отдельные кодовые точки, а не искаженные суррогатные пары.
Распутывать двойной текст
выше &amp; проблема Когда два слоя конвейера убегают, & становиться &amp;- и три слоя дают вам &amp;amp;, йо- Декодирование один раз снимает ровно один слой, так что вы можете запускать декодер многократно и смотреть, как луковица разворачивается: &amp;amp; → &amp; → & → &, йо- Подсчет проходов говорит вам, сколько уровней вашего стека убегает, что именно является диагностикой, необходимой мне во время этой ошибки в нижнем колонтитуле WP с четырьмя побегами. Один декодирование на слой. Это самый быстрый способ, который я знаю, чтобы локализовать, где в трубопроводе происходит дополнительное побег.
бок о бок с подсчетом символов
Ввод слева, вывод справа, количество символов выше обоих. Эта пара счётов работает больше, чем кажется: выход - это расширяющаяся операция, поэтому, если вы закодируете 40 символов и получите 44 обратно, был затронут ровно один специальный символ. Когда I'm проверяется, избежал ли шаблон чего-то, дельта сообщает мне перед I've прочитал один символ вывода. Кодируйте, декодируйте, меняйте и очищайте кнопки - там's нет преобразования типа "живи как ты", о котором I' признаю, это преднамеренный компромисс. Я иногда сожалею. Явнятные действия означают, что вы всегда знаете, в каком направлении создавался текст, на который вы и #39; смотрите, и с ускользающими ошибками эта двусмысленность является всей проблемой. Но для взрывного тыкания версия с нажатием клавиши была бы действительно приятнее.
100% клиентская сторона - ничего не загружено
Все работает в вашем браузере. нет запроса, нет сервера, нет журналов. это 't приятно иметь: текст вы're escaping часто является именно тем текстом, который вы должны't вставить в случайные веб-сайты - созданные пользователем комментарии с реальными именами, шаблоны электронной почты с адресами клиентов, поддержка содержимого билетов. I' уже писал ранее о том, почему это важно в Наше руководство по конфиденциальности данныхКороткая версия заключается в том, что конвертер, который загружает ваш вход, — это процессор данных, который вы никогда не проверяли. выше Инструмент сущности Toolz.dev работает в автономном режиме после загрузки.Режим самолета - это действительный тест - попробуйте.
Как использовать кодер и декодер сущности HTML
Шаг 1: откройте инструмент и вставьте текст
доводить до Toolz.dev/tools/html-entities и вставить свой ввод - фрагмент кода, искаженный отрывок RSS, фрагмент шаблона электронной почты, что угодно. There's нет размера потолок, о котором стоит беспокоиться для нормального использования; I'вклеил в него целые визуализированные журналы изменений плагина. Поскольку обработка на стороне клиента, конфиденциальный контент здесь в порядке.
Шаг 2: выберите код или декодирование
Кодировка превращает необработанные символы в сущности (< → <) - используйте его, когда хотите, чтобы разметка отображалась в виде текста. декодирование разрешает сущности обратно к символам (& → &) - используйте его, когда вы 're читаете сбежавший контент. если вы ' не уверены, в каком состоянии находится ваш текст, сначала декодируйте и посмотрите, какие изменения. неизмененный вывод означает, что он уже был простым.
Шаг 3: Выберите стиль эталона (при кодировании)
В раскрывающемся списке режима есть ровно три варианта, и выбор имеет большее значение, чем кажется. названный кодирует все, для чего имеет имя, и для остальных возвращается к десятичному знаку - читается в исходном и различном источниках, но также ускользает ©, —, é И любой другой символ, не являющийся ASCII, который раздувает выход, если вы все равно находитесь на UTF-8. числовой То же самое покрытие в чистом десятичном. Только специальные символы не касается ничего, кроме & < > " ' и оставляет ваши акценты, тире и смайлы в виде необработанного UTF-8 - это тот, который я использую для реального контента, и it's режим, который соответствует чему htmlspecialchars() делает в PHP. заметьте, что ' всегда выходит как ', никогда ', во всех трех режимах, это преднамеренно, поскольку ' не определен в HTML 4, и старые почтовые клиенты по-прежнему заглушаются.
Шаг 4: Проверьте вывод, затем скопируйте
Нажмите «Кодировать» или «Декодировать» и прочитать правую панель. Для декодирования вакансий смотрите конкретно на остатки & последовательности - выживший означает, что текст был дважды экранирован, поэтому нажмите "Обмен" и снова декодируйте. Когда он читается чисто, скопируйте результат в свой шаблон, CMS или код. Для повторных заданий один раз выполните туда и обратно (кодируйте, а затем декодируйте), чтобы подтвердить, что ничего потерянного не произошло; в режиме только со специальными чарами поездка туда и обратно является точной.
Имя против числовых сущностей - и пять символов, которые действительно имеют значение
Пусть 's прояснит терминологию, потому что & quot;HTML entity& quot; используется свободно.WHATWG HTML Standard - живая спецификация, которая определяет, как браузеры на самом деле анализируют HTML - определяет таблицу Именованные ссылки на символы: более 2200 имен, как , —, …, →, каждое сопоставление с одной или двумя кодовыми точками Юникода. Отдельно, Ссылки на цифры Позвольте вам обратиться напрямую к любой точке кода: десятичный (—) или шестнадцатеричная (—). Тот же em-dash, три написания.
Вот мой самоуверенный взгляд, отточенный годами работы на WordPress: Из этих более 2200 имен только пять персонажей имеют значение для правильности и безопасности. Все остальное - типографика, и на странице UTF-8 - а это каждая страница, которую вы должны отправить в 2026 году - вы можете просто ввести настоящий символ. Вы don't нуждаетесь —; вам нужно -. Пять, которые имеют значение, - это те, которые имеют синтаксическое значение в HTML:
| характер | сущность | Почему это важно |
|---|---|---|
& |
& |
Запускает каждую сущность - сам escape-символ |
< |
< |
Открывает теги |
> |
> |
Закрывает теги |
" |
" |
Разделяет двойные цитируемые атрибуты |
' |
' |
Разделяет однокавычные атрибуты |
Обратите внимание на последнюю строку: ', не ', йо- имя ' действителен в HTML5, но это была 't часть HTML4, и старые инструменты (и старые почтовые клиенты - больше на тех, что позже) могут споткнуться на нем. числовая форма работает везде. это вид педантизма, который сохраняет вам запутанный отчет об ошибке.
Порядок операций — это вся игра. При кодировании, & должен быть сбежен в первую очередь, йо- Если вы убежите < на < а затем выйти из амперсанда, вы преобразуете свой собственный вывод в &lt;- поздравляю вас и #39;ve double escaped.Decoding - это зеркальное отражение: & Должно быть решено продленный, или &lt; становиться < становиться < и вы 've недостаточно декодированы (или, что еще хуже, повторно ввели живую разметку из текста, который был намеренно удален). Почти каждый вручную свернутый аварийный ошибка I've review - включая мою собственную - является ошибкой заказа.
Контекст имеет значение, и именно здесь спасение соответствует безопасности. Шпаргалка по предотвращению межсайтовых скриптов OWASP тупой в этом отношении: кодирование сущности HTML является правильной защитой для HTML главная часть а атрибут контексты, но это не Достаточно для строк JavaScript, URL-адресов или CSS. < внутри <script> блок des't декодирует - содержимое скрипта isn't анализируется для сущностей - так что кодирование сущностей там не приносит никакой пользы. каждому контексту нужен свой собственный кодер: кодировка сущностей для HTML, \uXXXX Эскиз для строк JS, процент-кодирование для URL-адресов (это то, что наш кодер/декодер URL для). Использование правильного кодировщика в неправильном контексте — это классический способ, которым код санитизированного вида остается эксплуатируемым.
на стороне PHP, знайте две ваши функции. htmlspecialchars() Избегает только пяти специальных предложений (проход ENT_QUOTES или вы пропустите единственную цитату - настоящий попался). htmlentities() побеги все который имеет именованную сущность, поворачивающую ü в ü, йо- На UTF-8 страницах, htmlentities() Почти всегда неправильный выбор: он раздувает вывод и извращает содержимое, когда кодировки неверно объявляются. WordPress осознает это разумно:
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() а esc_attr() оба избегают пяти специальных выпусков с правильными флагами, выбранными для каждого контекста - именно та дисциплина, которую предписывает OWASP с поздним выходом Правило, которое я сверляю в каждом обзоре кода: escape во время вывода, в контексте вывода и #39;s, ровно один раз.
Что приносит домой: с UTF-8 вы редко нуждаться сущности для типографских символов вообще. Они нужны для разметки-значимых символов и для ненадежных вводов. Все остальное — наследственная привычка.
Общие варианты использования
Отображение фрагментов кода в сообщениях блога и документах
Напишите учебник, содержащий <script> или <?php и вставьте его в CMS RAW, и браузер попытается выполнить или проглотить ваш пример вместо отображения его. Каждый пример кода в контексте HTML <, >, и & закодировано. я делаю это постоянно для документации плагина - readme HTML, статьи базы знаний, встроенные примеры в вкладках справки пользовательского интерфейса администратора. рабочий процесс: напишите фрагмент, проведите его через Кодировщик сущностей, вставьте сбежавшийся внутри <pre><code>, йо- тридцать секунд, и твой <script> отображает как <script> Вместо того, чтобы исчезнуть в Доме. Если вы строите рабочий процесс документов в целом, наш Руководство по инструментам кодирования Покрывает остальную часть набора инструментов вокруг этого.
Очистка двойного текста из баз данных и каналов
выше &amp; чума. Это проявляется, когда CMS убегает при сохранении, плагин убегает при рендеринге, а слой кэширования снова услужливо убегает. Однажды я отправил журнал изменений WP Adminify, в котором анализатор чтения wordpress.org и мой собственный сценарий сборки разошлись во мнениях относительно того, кто сбегает - в визуализированном журнале изменений было видно 23 &s в нем до того, как пользователь отправил мне электронное письмо. RSS-каналы хуже, содержимое фида часто избегается HTML внутренняя часть XML, поэтому потребители обычно переопределяют или недодекодируют его. Исправление - это диагностическое декодирование: вставляйте сломанный текст, декодируйте по одному проходу за раз, считайте, сколько проходов, пока он не станет чистым. Этот счетчик равен количеству выходящих слоев - теперь вы точно знаете, сколько частей вашего конвейера касается текста, и вы можете найти избыточный.
Безопасное подготовка пользовательского контента
Комментарии, текст обзора, биографии профилей, билеты в службу поддержки - все, что набрал пользователь, не доверяет, и часто содержит PII: реальные имена, электронные письма, адреса. Здесь сталкиваются две проблемы. во-первых, безопасность: этот контент должен быть закодирован в виде сущности на выходе или вы ' это один <img onerror=...> Вдали от сохраненных XSS (спросите меня о поле настроек, которое я чуть не отправил). Во-вторых, конфиденциальность: когда вы отлаживаете почему конкретный пользователь's био ломает ваш макет, вы'переобработка их персональных данных - вставить его в конвертер на стороне сервера означает доставку PII третьей стороне.инструмент Toolz.dev обрабатывает все локально, поэтому тестирование реальных проблемных строк безопасно. закодируйте образец, проверьте, какой ваш шаблон должен произвели, не смотря на то, что он произвел.
Электронная почта HTML-шаб
Электронная почта HTML - это веб-разработка с механизмом рендеринга 20-летней давности. Некоторые клиенты справляются с необработанным UTF-8 хорошо; другие - в зависимости от того, как ваши наборы ESP переносят кодировки - искажают типографские символы в моджибаке. Защитное соглашение, которому до сих пор следуют многие разработчики электронной почты: кодируйте типографику, отличную от ASCII, как сущности (—, ’, для взлома между интервалами), поэтому байты на проводе — чистый ASCII. И помните ' по '- Outlook's старые движки - это именно тот инструмент, который никогда не изучал имена HTML5. Поскольку шаблоны персонализируются с именами и адресами клиентов, это снова контент I'd запускается только через инструмент на стороне клиента. Кодируйте хром шаблона один раз, сохраняйте поля слияния необработанными и избегайте их во время слияния.
Декодирование содержимого и ответов API
Сотрите страницу или потратьте небрежный API, и вы утонете ’, “, &, и . Некоторые API возвращают строки, закодированные сущностями, внутри JSON - формата, который вообще не требует выхода HTML - поэтому вы получаете такие артефакты, как "title": "Fish & Chips", йо- Прежде чем эти данные попадут в вашу собственную базу данных, расшифруйте их для очистки UTF-8; сохраните канонический текст, побег на выходе. Я постоянно нажимаю на это при импорте контента в приложения Laravel: сначала декодируйте сущности, к тому же Pretty-Print и осмотрите полезную нагрузку с помощью Форматтер JSON. Сделать это в другом порядке означает прочитать JSON, где каждый апостроф имеет длину семь символов. Если полезная нагрузка упакована в базу 64 поверх этого - некоторые поставщики веб-крючков делают это - Конвертер Base64 обрабатывает внешний слой, и наш Руководство по кодированию Base64 Объясняет, почему эта оболочка существует.
Локализация контента с помощью специальных символов
Файлы перевода приходят в каждое вообразимое состояние. Один поставщик отправляет чистый UTF-8 ü; другой отправляет ü; третий отправляет ü; иногда вы получаете все три в одном файле ПО. Перед импортом я нормализую все до необработанного UTF-8 с помощью прохода декодирования - каноническое хранилище, последовательный поиск, разумные различия. То же самое относится к пунктуации RTL, скобкам CJK и латинице с акцентом в отправленных строках. Декодируйте импорт, сохраняйте реальные символы и позволяйте выходному слою избежать только пяти специальных предложений. Ваши переводчики также скажут вам спасибо: über это не то слово, которое нужно писать.
Именовано VS Decimal против Hex против RAW UTF-8: что следует использовать?
| форма | Пример (ЭМ-Дэш) | читабельность | Поддержка браузера | Когда использовать |
|---|---|---|---|---|
| Именованная сущ | — |
Хороший - самоописывающий | Универсальный для имен HTML4-эры; имена только HTML5 (например, ') не работает в старых инструментах |
Пять специальных контекстов, устаревшие контексты, такие как email html |
| десятичная ссылка | — |
Бедный - это 's номер | Универсальный, включая древние парсеры | символы без имен; максимальная совместимость сбега (')) |
| ссылка на шестнадцатеричный | — |
Плохо, но сопоставляется с кодовыми точками Юникода | Универсальный в чем-либо отдаленно современном | При перекрестных ссылках на графики или спецификации Юникода |
| Сырой УТФ-8 | — |
совершенный | Универсальный на правильно заявленных страницах UTF-8 | Все типографское - это должно быть по вашему умолчанию |
Моя позиция, прямо: Напишите RAW UTF-8 для типографики, резервируйте сущности для пяти специальных и ненадежных данных. документ, полный — а … является документом, который никто не может исправить, и он сигнализирует о рабочем процессе, который имеет 't доверял своим объявлениям о наборах с 2008 г. Современные стеки - WordPress, Laravel, Next.js, каждая база данных, которую вы 'd выбираете сегодня - это UTF-8 от начала до конца. Введите реальный символ.
Где зарабатывают на сущности свои сущности: &, <, >, ", и ' для всего, что может быть интерпретировано как разметка, всегда, никаких исключений, применяемых во время вывода. и во враждебных средах рендеринга - почтовых клиентах, каналах, потребляемых неизвестными анализаторами - числовые ссылки являются параноидальным, но оправданным выбором, потому что они предшествуют каждому аргументу совместимости. Между десятичным и шестнадцатеричным, it's вкус; Я склоняюсь к шестнадцатеричному, потому что — Соответствует U+2014, и я могу перестать делать конверсию в голове.
Часто задаваемые вопросы
Что такое сущность HTML?
Объект HTML — это текстовая последовательность, представляющая символ, а не писать символ напрямую. Он начинается с амперсанда и заканчивается точкой с запятой. Есть названия ссылок, таких как & и ©, и числовые ссылки, такие как © (десятичное) или © (hex), указывающие на точку кода Юникода. Браузеры разрешают их при синтаксическом анализе, поэтому < отображается как знак меньше, чем открывается тег. Они существуют, поэтому вы можете отображать символы, которые в противном случае интерпретировались бы как разметка.
Какие символы должны быть сброшены в HTML?
Пять: амперсанд, меньше, больше, двойная цитата и одинарная цитата - написаны как &, <, >, " и '. Амперсанд, потому что он запускает сущности; угловые скобки, потому что они ограничивают теги; кавычки, потому что они ограничивают значения атрибутов. в тексте тела элемента вам могут сойти с рук только первые три, но ускользнуть от всех пяти повсюду - это привычка, которая никогда вас не кусает. Все остальное - акценты, тире, эмодзи - может быть необработанным UTF-8 на правильно объявленной странице.
В чем разница между написанным как именованная сущность и <?
Ничего, как только браузер их анализирует - оба производят знак меньше.именованная форма представляет собой поиск в таблице именованных ссылок WHATWG 's; < адресованы кодовому пункту Unicode 60 напрямую, и < является той же кодовой точкой в шестнадцатеричном формате. Именованные объекты легче читать людям; числовые ссылки работают для всех символов, включая тысячи, у которых нет имени. для общих специальных предложений выберите, какой бы ваш коллектив ни нашел более читабельным - браузерам все равно.
Почему моя страница показывает, а не амперсанд?
Двойной выход. некоторый слой вашего стека избежал уже сбежавшей строки, превратив & amp; в & amp; amp;. браузер декодирует один уровень и отображает оставшееся. обычно это означает два компонента, которые оба думают, что выход - это их работа: CMS на сохранении плюс шаблон на рендеринге - это классическая пара. Декодируйте строку по одному проходу в декодере; количество проходов до тех пор, пока она не прочитает чисто, равно количеству слоев, выходящих из нее. Затем возложите ответственность ровно на один уровень во время вывода.
Предотвращает ли экран HTML-код XSS?
В контекстах тела и атрибутов HTML, да - кодирование сущностей ненадежный ввод есть основная защита, потому что полезная нагрузка отображается как инертный текст. Но этого не достаточно везде.Площадка предотвращения OWASP XSS явная, что строки JavaScript, URL-адреса и CSS нуждаются каждый в своей собственной контекстно-специфической кодировке; кодирование сущностей внутри блока сценария ничего не делает. Escape на выходе, в контексте, в который вы выводите, используя этот контекст's кодировщик сущностей является одним инструментом в этом наборе, а не всем набором.
В чем разница между HTMLSpecialChars и HTMLentities в PHP?
htmlspecialchars () ускользает только от символов, значимых для разметки, - и вам следует пройти ENT_QUOTES, чтобы он охватывал одну цитату. htmlentities () преобразует каждый символ, имеющий именованную сущность, поэтому буквы с акцентом становятся такими вещами, как ссылка на uuml. На страницах UTF-8 htmlspecialchars () почти всегда то, что вы хотите; htmlentities () раздувает вывод и вызывает моджибейк, когда зарядные устройства неправильно настроены. Разработчики WordPress в основном избегают вопроса, используя esc_html () и esc_attr (), которые применяют правильные флаги для каждого контекста.
Должен ли я использовать сущность APOS для апострофов?
Предпочитать '. имя apos действительно в HTML5, но никогда не было частью HTML4, поэтому более старые парсеры - включая механизмы рендеринга внутри некоторых почтовых клиентов - не распознают его и будут отображать буквально. числовая форма ' означает один и тот же символ и работает во всем, что когда-либо отправлялось. это уродливый, но безопасный выбор, который обычно является правильным компромиссом для побега. если вы знаете, что ваш вывод когда-либо попадает только в современные браузеры, apos - это нормально; шаблоны электронной почты - это именно то, что вы не можете знать.
Безопасно ли вставлять пользовательские данные в онлайн-конвертер сущностей?
Только если инструмент обрабатывает текст в вашем браузере. пользовательский контент и шаблоны электронной почты обычно содержат имена, электронные письма и другие PII, а конвертер, который публикует ваш ввод на сервере, только что получил эти данные без какого-либо соглашения. Кодер/декодер объектов HTML Toolz.dev работает на 100% стороне клиента - без загрузки, без регистрации и работает в автономном режиме после загрузки страницы. Если вы не можете проверить, как инструмент обрабатывает ввод, не вставляйте в него производственные данные.
Сбежать один раз, в нужном месте
Если вы возьмете одну вещь из десятилетия моих побегов, возьмите это: ровно один слой вашего стека должен ускользнуть, и это должен быть выходной слой. Хранить чистый UTF-8. Избегайте пяти специальных предложений во время рендеринга в контексте, в который вы перерисовываете. все &amp; в производстве карта двух компонентов, борющихся за эту работу - и каждая неэкранированная строка пользователя является сохраненным XSS, ожидающим проверки кода, которая может не произойти. Мой почти не сделал 't.
держать Кодировщик/декодер сущностей HTML в вашем вращении отладки вместе с его братьями и сестрами - кодер/декодер URL Для контекстов процентного кодирования ( Руководство по кодированию URL проходит через %2520, процент-кодирующий двоюродный брат &amp;), Конвертер Base64 Для упакованных полезных нагрузок и конвертер для идентификации-переименовывающей работы между ними. выше Руководство по инструментам кодирования Проходит весь набор.
А поскольку строки, которые вы отлаживаете, часто являются кем-то & #39;s фактическое имя или электронная почта: все, что указано выше, работает на стороне клиента, ничего не загружается, проверяется на вашей вкладке сети. Это & # 39;s не маркетинг - it& # 39;s причина, по которой я построил эти инструменты так, как я это сделал. Подробнее об этой философии в Руководство по конфиденциальности данных, йо-


