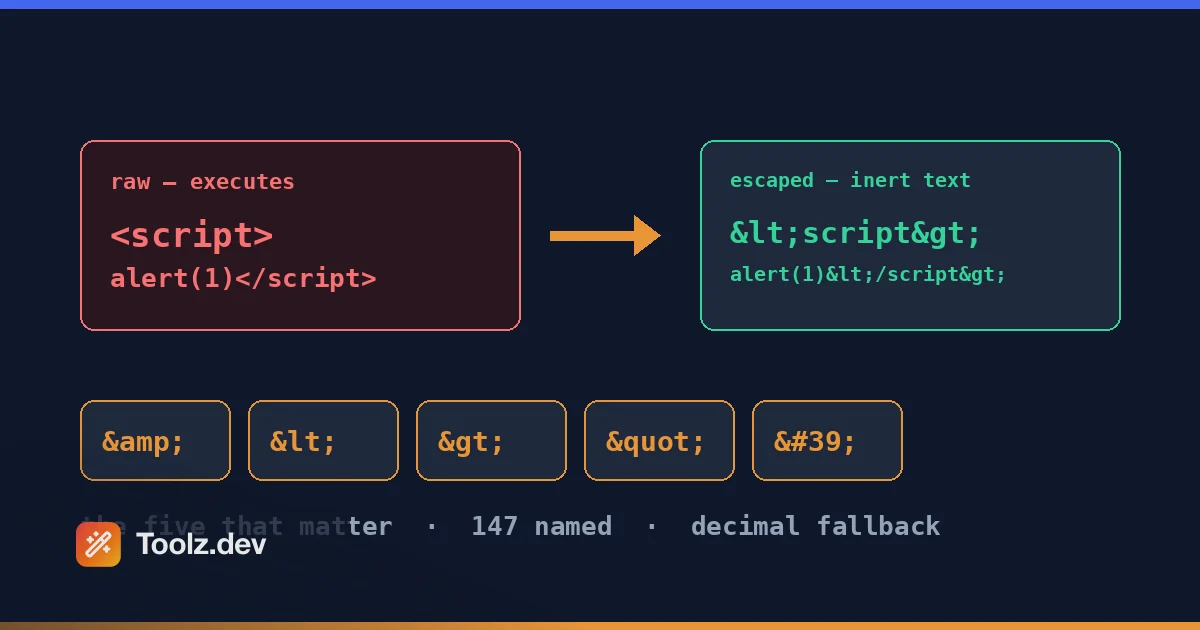
Alrededor de 2021, un ticket de soporte de WP Adminify apareció con una captura de pantalla que todavía me hace hacer una mueca de dolor. Un usuario había configurado un texto de pie de página de administrador personalizado, una línea de derechos de autor perfectamente inocente con a © y un enlace a su agencia. En su pantalla se renderiza como © 2021 — Bright & Co. Tres entidades visibles, cero caracteres renderizados. El culpable era yo. Mi rutina de guardado escapó del texto, mi rutina de renderizado lo escapó nuevamente y en algún lugar entre un filtro se le escapó por tercera vez. Cuando llegó al navegador, ese pobre ampersand había sido escapado cuatro veces. conté.
La solución tomó diez minutos. Encontrar que tomó dos noches, porque el texto escapado parece casi Correcto tu desnatas © en un volcado de base de datos y su cerebro lo autocorrecta a ©. Terminé pegando cadenas en un archivo HTML de Scratch una y otra vez solo para ver qué renderizaría realmente el navegador en cada capa. Ese es un flujo de trabajo miserable, y es exactamente por lo que un decodificador de entidades HTML es una de las primeras herramientas que incorporé en Toolz.dev.
La otra cara de la misma moneda da más miedo. Unos meses antes de ese ticket, durante una revisión de código de mi propio complemento, encontré un campo de configuración que hizo eco de la entrada del usuario en un aviso de administrador sin esc_html(). Cualquier persona con acceso a ese campo podría haber almacenado <script> y lo ejecuté para cada administrador que cargó la página. Almacené XSS, en mi propio código, faltaba una llamada de función. Nadie lo explotó, tuve suerte. Pero cambió permanentemente mi forma de pensar sobre escapar: it' no es una tarea de formato, it's el límite entre "text" y "code."
Entonces esta guía cubre ambas direcciones. Codificación, por lo que el texto que no es de confianza permanece como texto. Decodificación, para que puedas leer lo que algún oleoducto demasiado ansioso destrozó. Y suficiente teoría (referencias nombradas versus numéricas, los cinco caracteres que realmente importan, por qué el orden de las operaciones provoca un doble escape) como para poder depurar estas cosas en lugar de adivinar.
TL;Dr: Pegue su texto en el Codificador/descodificador de entidades HTML de Toolz.dev para convertir entre caracteres sin procesar y entidades en cualquier dirección: con nombre, decimal o hexadecimal. Se ejecuta 100% del lado del cliente, por lo que el contenido del usuario y la PII nunca abandonan su navegador. Regla general: escape siempre de los cinco especiales (
& < > " ') en entrada no confiable, y codificar&Primero o tendrás doble escape.
Características clave
Codificar y decodificar en ambas direcciones
La mitad del tiempo que necesito girar <script> hacia el interior de <script> entonces se muestra como texto en una publicación de blog. La otra mitad I' Voy en sentido contrario, girando un raspado &#8217;s de nuevo en un apóstrofe legible. La herramienta maneja ambos. Pegar texto, seleccionar codificar o decodificar, hecho. Sin búsqueda de modo, sin herramientas separadas para cada dirección. Eso suena trivial hasta que usted ' He usado herramientas que solo decodifican y te encuentras abriendo una segunda pestaña para codificar una muestra de código para tus documentos. El ida y vuelta también es una excelente prueba de cordura: codifica, decodifica y confirma que recuperas tu cadena original. Si lo hace 't, algo en su entrada ya se escapó parcialmente, lo cual es en sí mismo información útil.
Entidades con nombre: &amp;, &lt;, &copia; y amigos
Las referencias de personajes nombrados son legibles por humanos & para &, < para <, © para ©, — para un guión em-tail. La herramienta lleva una tabla curada de 147 nombres, no solo los cinco famosos: tipografía ( , …, ’, “), moneda, matemáticas y flechas, letras griegas, el rango completo con acento latino 1 y algunas probabilidades como palos de cartas. Ese rango es lo que realmente necesita el contenido del mundo real: emite WordPress , …y ’ A través de WPTtexturize constantemente, y un decodificador que solo conoce una docena de nombres deja la mitad de su texto lleno de referencias sin resolver.
Ten claro lo que no es 147: el QUÉWG El estándar HTML define más de 2200 referencias con nombre, por lo que este es un subconjunto práctico en lugar de la tabla completa. Si un nombre es 't en él, la decodificación deja la referencia intacta en lugar de adivinar - &bogus; sale como &bogus;. La codificación tiene el comportamiento complementario, y es la mitad más útil: cualquier carácter sin Un nombre en la tabla vuelve a una referencia numérica decimal automáticamente, por lo que nunca se elimina nada silenciosamente. Un emoji codifica como 🌍, texto chino como 你好. Nombres donde existen, números en todas partes.
Una divergencia más del comportamiento del navegador que vale la pena conocer: el decodificador distingue entre mayúsculas y minúsculas y requiere el punto y coma. Los navegadores se resolverán © e incluso un desnudo & sin punto y coma final en algunos contextos de análisis, gracias a reglas de compatibilidad heredadas; este decodificador no resuelve ninguno de los dos. En la práctica eso' está bien, cualquier cosa es una herramienta moderna genera está en minúsculas y terminado, pero si 're decodificando HTML raspado de un CMS antiguo, eso 's la ventaja que 'll golpeará.
Referencias numéricas: decimal y hexadecimal
Cualquiera Unicode el carácter se puede escribir como una referencia numérica de caracteres, similar a un decimal — o maleficio como — (Ambos son un em-dash). El decodificador resuelve ambas formas. Esta es la escotilla de escape para los personajes que no tienen nombre en el estándar, y es el formulario que se reunirá constantemente en las respuestas de la API y las fuentes RSS, donde ’ (cita única derecha) es prácticamente una firma. Las referencias hexadecimales se asignan directamente a puntos de código Unicode - U+2014 es —- por eso los prefiero cuando I'm hacen referencias cruzadas con un gráfico Unicode.
Limitación honesta, ya que la notarás en un minuto después de usar la herramienta: la numérica cifrar El modo solo emite decimal. No hay una opción de salida hexadecimal. desciframiento — funciona bien; pedirle al codificador que lo produzca no es 't. Las dos formas son semánticamente idénticas a cada navegador, por lo que esto no le cuesta nada funcionalmente, pero si su código base se estandariza en hexadecimal, usted ' lo convertirá a mano. It's en mi lista. Las referencias fuera de rango quedan atrapadas en lugar de destrozadas - � está por encima del máximo Unicode y devuelve un error explícito en lugar de un carácter de reemplazo.
Cobertura completa de Unicode
Emoji, caracteres CJK, árabe, combinando signos diacríticos, funciona. Si tiene un punto de código, la herramienta puede expresarlo como una entidad y resolverlo. Esto importa más que tú'd piensa en el trabajo de localización - I' He depurado diéresis alemanas que llegan como ü De un proveedor de traducción y como UTF-8 sin procesar ü de otro, en el mismo archivo de importación. Una herramienta que se atraganta fuera de Latin-1 es inútil para eso. Los caracteres sobre u+ffff (emoji viven allí) se manejan correctamente como puntos de código único, no pares de subrogación destrozados.
Desenredar texto de doble fuga
los &amp; Problema. Cuando dos capas de una tubería se escapan, & se convierte en &amp;- y te dan tres capas &amp;amp;. La decodificación una vez se despega exactamente una capa, para que pueda ejecutar el decodificador repetidamente y ver cómo se desenvuelve la cebolla: &amp;amp; → &amp; → & → &. Contar los pases le dice cuántas capas de su pila se están escapando, que es precisamente el diagnóstico que necesitaba durante ese error de pie de página de administración de WP que se escapa de cuatro veces. Una decodificación por capa. Es la forma más rápida que conozco de localizar dónde en una tubería ocurre la fuga adicional.
Paneles de lado a lado con conteos de caracteres
La entrada a la izquierda, la salida a la derecha, los caracteres cuentan por encima de ambos. Ese par de conteo funciona más de lo que parece: escapar es una operación en expansión, por lo que si codificas 40 caracteres y recuperas 44, se tocó exactamente un carácter especial. Cuando I' Estoy auditando si una plantilla ya escapó de algo, el delta me dice antes de I' he leído un solo carácter de salida. Codificar, decodificar, intercambiar y borrar son botones - ahí ' no hay conversión de vivir como tú, lo cual I' admitiré que es una compensación deliberada de la que a veces me arrepiento. Las acciones explícitas significan que siempre sabes en qué dirección produjo el texto que estás mirando, y con errores de escape, esa ambigüedad es todo el problema. Pero para el punteo exploratorio, una versión basada en pulsaciones de teclas sería realmente mejor.
100% del lado del cliente: nada subido
Todo se ejecuta en tu navegador. Sin solicitud, sin servidor, sin registros. Este es ' Es agradable tenerlo: el texto que usted 'escapar es a menudo exactamente el texto que debe 'pegar en sitios web aleatorios: comentarios generados por usuarios con nombres reales, plantillas de correo electrónico con direcciones de clientes, contenido de tickets de soporte. Yo y #39; He escrito antes sobre por qué esto importa Nuestra Guía de Privacidad de DatosLa versión corta es que un convertidor que carga tu entrada es un procesador de datos que nunca has probado. los Herramienta de entidad Toolz.dev funciona sin conexión una vez cargado. El modo avión es una prueba válida; pruébalo.
Cómo utilizar el codificador y decodificador de entidades HTML
Paso 1: Abre la herramienta y pega tu texto
IR A Toolz.dev/tools/entities y pegue su entrada: un fragmento de código, un extracto RSS destrozado, un fragmento de plantilla de correo electrónico, lo que sea. Allí ' No hay límite de tamaño por el que valga la pena preocuparse para un uso normal; I' He pegado registros de cambios completos de complementos renderizados. Dado que el procesamiento es del lado del cliente, el contenido confidencial está bien aquí.
Paso 2: Elija codificar o decodificar
La codificación convierte caracteres sin procesar en entidades (< → <) - úselo cuando desee que el marcado se muestre como texto. La decodificación resuelve entidades en caracteres (& → &) - úselo cuando ' estés leyendo contenido escapado. Si usted ' No estoy seguro de en qué estado se encuentra su texto, decodifique primero y vea qué cambia. La salida sin cambios significa que ya era simple.
Paso 3: Elija el estilo de referencia (al codificar)
El menú desplegable de modo tiene exactamente tres opciones, y la elección importa más de lo que parece. nombrado codifica todo para lo que tiene nombre y vuelve a ser decimal para el resto, legible en origen y diferencias, pero también escapa ©, —, é y todos los demás caracteres que no son ASCII, que inflan la salida si de todos modos están en UTF-8. numérico Hace la misma cobertura en decimal puro. Solo caracteres especiales no toca nada más que & < > " ' y deja tus acentos, guiones y emoji como UTF-8 sin formato: este es el que uso para contenido real, y es el modo que coincide con qué htmlspecialchars() lo hace en PHP. tenga en cuenta que ' siempre sale como ', nunca ', en los tres modos; eso es deliberado, ya que ' no está definido en HTML 4 y los clientes de correo electrónico anteriores aún se atragantan.
Paso 4: verifique la salida, luego copie
Presiona Encode o Decode y lee el panel derecho. Para trabajos de decodificación, busque específicamente sobras & secuencias: un superviviente significa que el texto se escapó dos veces, así que presione Intercambiar y decodificar nuevamente. Cuando lea limpio, copie el resultado en su plantilla, CMS o código. Para trabajos repetidos, ida y vuelta una vez (codificar y luego decodificar) para confirmar que no ocurrió nada con pérdidas; Con el modo de solo caracteres especiales, el viaje de ida y vuelta es exacto.
Entidades nombradas versus numéricas y los cinco caracteres que realmente importan
Let's aclara la terminología, porque "entidad HTML" se utiliza de forma vaga. El estándar WHATWG HTML, la especificación viva que define cómo los navegadores realmente analizan HTML, especifica una tabla de Referencias de caracteres con nombre: Más de 2.200 nombres como , —, …, →, cada mapeo a uno o dos puntos de código Unicode. por separado, Referencias de caracteres numéricos Le permite abordar cualquier punto de código directamente: decimal (—) o hexadecimal (—). El mismo em-dash, tres ortografías.
Aquí está mi opinión obstinada, agudizada por años de trabajo de WordPress: De esos más de 2200 nombres, solo cinco caracteres son realmente importantes para la corrección y la seguridad. Todo lo demás es tipografía, y en una página UTF-8, que es cada página que deberías enviar en 2026, puedes simplemente escribir el personaje real. No lo necesitas & #39; No lo necesitas —; necesitas - . Los cinco que importan son los que tienen significado sintáctico en HTML:
| carácter | entidad | Por qué importa |
|---|---|---|
& |
& |
Inicia cada entidad: el propio personaje de escape |
< |
< |
abre etiquetas |
> |
> |
Cierra las etiquetas |
" |
" |
Delimita los atributos de comillas dobles |
' |
' |
Delimita atributos de comillas simples |
Tenga en cuenta la última fila: ', no '. el nombre ' es válido en HTML5, pero era 't parte de HTML4, y las herramientas antiguas (y los clientes de correo electrónico antiguos, más sobre ellos más adelante) pueden dispararse. La forma numérica funciona en todas partes. Este es el tipo de pedantería que le ahorra un informe de error confuso.
El orden de las operaciones es todo el juego. Al codificar, & debe ser escapado primero. si escapas < para < Y luego escapar de los signos de ampersand, convertirás tu propia salida en &lt;- felicidades, tú've doble escape. La decodificación es la imagen especular: & DEBE SER RESOLVIDO mantenerse, o &lt; se convierte en < se convierte en < y tú' He decodificado poco (o peor aún, reintroducido el marcado en vivo del texto que se escapó deliberadamente). Casi todos los errores de escape enrollados a mano I' He revisado, incluido el mío, es un error de pedido.
El contexto importa, y aquí es donde la escapada se encuentra con la seguridad. La hoja de trucos de prevención de scripts cruzados de OWASP es contundente: la codificación de entidades HTML es la defensa correcta para el HTML conjunto y cualidad contextos, pero es no Suficiente para cadenas, URL o CSS de JavaScript. < Dentro de un <script> block no't decodificar - el contenido del script es't analizado para entidades - por lo que la codificación de entidades no hace nada útil allí. Cada contexto necesita su propio codificador: codificación de entidad para HTML, \uXXXX Escapando de cadenas JS, codificación de porcentaje para URL (eso es lo que nuestro Codificador de URL/decodificador es para). El uso del codificador correcto en el contexto incorrecto es la forma clásica de que el código de aspecto desinfectado sigue siendo explotable.
en el lado de php, conozca sus dos funciones. htmlspecialchars() Escapa sólo los cinco especiales (Pase ENT_QUOTES o te pierdes la cita única: un verdadero problema). htmlentities() escapada todo que tiene una entidad con nombre, ü hacia el interior de ü. En las páginas UTF-8, htmlentities() Casi siempre es la elección equivocada, infla y destroza el contenido cuando los juegos de caracteres se declaran erróneamente. WordPress envuelve esto con sensatez:
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() y esc_attr() ambos escapan de los cinco especiales con las banderas correctas, elegidas por contexto, exactamente la disciplina de escape tardío que prescribe OWASP. La regla que profundizo en cada revisión de código: escape en el momento de salida, en el contexto de salida y #39;s, exactamente una vez.
Lo que lo lleva a casa: con UTF-8, rara vez cosa necesaria entidades para caracteres tipográficos. Los necesita para caracteres significativos de marcado y para entradas no confiables. Todo lo demás es un hábito heredado.
Casos de uso comunes
Mostrar fragmentos de código en publicaciones de blog y documentos
Escribe un tutorial que contenga <script> investigaciones operacionales <?php y péguelo en un CMS RAW, y el navegador intentará ejecutar o tragar su ejemplo en lugar de mostrarlo. Cada ejemplo de código en un contexto HTML necesita <, >y & codificado. Hago esto constantemente para obtener documentación del complemento: léame HTML, artículos de la base de conocimientos, ejemplos en línea en pestañas de ayuda de la interfaz de usuario de administración. El flujo de trabajo: escriba el fragmento, ejecútelo a través de Codificador de entidad, pegue la versión escapada dentro <pre><code>. treinta segundos, y tu <script> se muestra como <script> en lugar de desvanecerse en el Dom. Si está construyendo un flujo de trabajo de documentos en general, nuestro Guía de herramientas de codificación Cubre el resto de la caja de herramientas alrededor de esto.
Limpieza de texto de doble escape de bases de datos y fuentes
los &amp; plaga. Aparece cuando un CMS se escapa al guardar, un complemento se escapa en el renderizado y una capa de almacenamiento en caché se escapa útilmente una vez más. Una vez envié un registro de cambios de WP Adminify donde el analizador wordpress.org readme y mi propio script de compilación no estaban de acuerdo sobre quién escapa: el registro de cambios renderizado tenía 23 visibles &s en él antes de que un usuario me envíe un correo electrónico. Las fuentes RSS son peores; el contenido de la fuente a menudo se escapa a HTML entromete XML, por lo que los consumidores habitualmente lo decodifican demasiado o menos. La solución es la decodificación de diagnóstico: pegar el texto roto, decodificar una pasada a la vez, contar cuántas pasadas hasta que esté limpio 's. Ese recuento es igual al número de capas que se escapan; ahora sabes exactamente cuántas piezas de tu canalización tocan el texto y puedes encontrar la redundante.
Preparar contenido generado por el usuario de forma segura
Comentarios, texto de revisión, biografías de perfiles, tickets de soporte: cualquier cosa que haya escrito un usuario no es de confianza y con frecuencia contiene PII: nombres reales, correos electrónicos, direcciones. Aquí chocan dos preocupaciones. Primero, seguridad: ese contenido debe estar codificado por entidad en la salida o usted 're uno <img onerror=...> lejos de XSS almacenado (pregúnteme sobre el campo de configuración que casi envié). Segundo, privacidad: cuando estás depurando porque un usuario específico 's bio rompe su diseño, usted 're maneja sus datos personales: pegarlos en un convertidor del lado del servidor significa enviar PII a un tercero. La herramienta Toolz.dev procesa todo localmente, por lo que probar cadenas de problemas reales es seguro. Codifique la muestra, inspeccione cuál es su plantilla debería han producido, diff lo que sí produjo.
Plantillas HTML de correo electrónico
Email HTML es un desarrollo web con un motor de renderizado de 20 años. Algunos clientes manejan bien UTF-8 sin formato; otros, dependiendo de cómo su ESP establezca codificaciones de transferencia, confunden caracteres tipográficos en mojibake. La convención defensiva que muchos desarrolladores de correo electrónico todavía siguen: codificar tipografía que no sea ASCII como entidades (—, ’, para los espaciados de hacks) por lo que los bytes en el cable son ASCII puro. y recuerda ' superior '- Outlook' Los motores más antiguos son exactamente las herramientas que nunca aprendieron nombres HTML5. Dado que las plantillas se personalizan con los nombres y direcciones de los clientes, esto nuevamente es contenido I' solo se ejecuta a través de una herramienta del lado del cliente. Codifique la plantilla Chrome una vez, mantenga los campos de combinación sin procesar y escapelos en el momento de la combinación.
Decodificación de contenidos raspados y respuestas API
Raspe una página o consuma una API descuidada y se ahogará en ’, “, &y . Algunas API devuelven cadenas codificadas por entidades dentro de JSON, un formato que no necesita ningún escape HTML, por lo que obtienes artefactos como "title": "Fish & Chips". Antes de que esos datos entren en su propia base de datos, decodifique para limpiar UTF-8; almacene texto canónico, escape en la salida. Presiono esto constantemente al importar contenido a aplicaciones de Laravel: primero decodificar entidades, de entonces Imprimir bonito e inspeccionar la carga útil con el Formateador JSON. Hacerlo en el otro orden significa leer JSON donde cada apóstrofe tiene siete caracteres. Si la carga útil está envuelta en base 64, algunos proveedores de webhooks hacen esto Convertidor Base64 maneja la capa exterior, y nuestro Guía de codificación Base64 explica por qué existe ese envoltorio.
Localización de contenido con caracteres especiales
Los archivos de traducción llegan a todos los estados imaginables. Un proveedor envía UTF-8 limpio ü; otro envía ü; un tercero envía ü; De vez en cuando obtienes los tres en un archivo PO. Antes de importar, normalizo todo a UTF-8 sin formato con un pase de decodificación: almacenamiento canónico, búsqueda consistente, diferencias sanas. Lo mismo se aplica a la puntuación RTL, los corchetes CJK y el latín acentuado en las cadenas enviadas. Decodifique al importar, almacene caracteres reales y deje que su capa de salida escape solo de los cinco especiales. Tus traductores también te lo agradecerán: über No es una palabra que nadie deba tener que corregir.
Nombrado vs decimal vs hex vs RAW UTF-8: ¿cuál debería usar?
| hacerse | Ejemplo (em-guión) | interés | Soporte de navegador | Cuándo usar |
|---|---|---|---|---|
| entidad nombrada | — |
Bueno - autodescribirse | Universal para nombres de la era HTML4; nombres de HTML5 (como ') falla en las herramientas antiguas |
Los cinco especiales; contextos heredados como HTML de correo electrónico |
| Referencia decimal | — |
Pobre - it's un número | Universal, incluidos los antiguos analizadores | Caracteres sin nombres; Escapando de máxima compatibilidad (') |
| Referencia hexadecimal | — |
Pobres, pero se asignan a puntos de código Unicode | Universal en cualquier cosa remotamente moderna | Al hacer referencias cruzadas de gráficos Unicode o especificaciones |
| UTF-8 crudo | — |
perfecto | Universal en las páginas UTF-8 declaradas correctamente | Todo tipográfico: esto debería ser tu valor predeterminado |
Mi postura, claramente: Escriba RAW UTF-8 para tipografía, entidades de reserva para los cinco especiales y entradas no confiables. Un documento lleno de — y … es un documento que nadie puede corregir y señala un flujo de trabajo que ha 't confió en sus declaraciones de conjunto de caracteres desde 2008. Pilas modernas - WordPress, Laravel, Next.js, cada base de datos que usted 'd elija hoy - son UTF-8 de un extremo a otro. Escribe el carácter real.
Donde las entidades ganan su mantenimiento: &, <, >, "y ' para cualquier cosa que pueda interpretarse como marcado, siempre, sin excepciones, aplicado en el momento de la salida. Y en entornos de renderizado hostiles (clientes de correo electrónico, feeds consumidos por analizadores desconocidos), las referencias numéricas son la opción paranoica pero justificada porque son anteriores a cada argumento de compatibilidad. Entre decimal y hexadecimal, it's gusto; Me inclino hexadecimal porque — Coincide con U+2014 y puedo dejar de hacer conversiones base en mi cabeza.
Preguntas frecuentes
¿Qué es una entidad HTML?
Una entidad HTML es una secuencia de texto que representa un carácter en lugar de escribir el carácter directamente. Comienza con un ampersand y termina con un punto y coma. Hay referencias con nombre como & y © y referencias numéricas como © (decimal) o © (hex) que apuntan a un punto de código Unicode. Los navegadores los resuelven mientras analizan, así que < se muestra como un signo menos que abrir una etiqueta. Existen para que puedas mostrar personajes que de otro modo se interpretarían como marcado.
¿Qué personajes deben escaparse en HTML?
Cinco: el signo comercial, menor que, mayor que, comilla doble y comilla simple, escrito como &, <, > " y ' Ampersand, porque inicia entidades; los corchetes angulares, porque delimitan etiquetas; las comillas, porque delimitan valores de atributos. En el texto del cuerpo del elemento, puedes salirte con la tuya solo con los tres primeros, pero escapar de los cinco en todas partes es el hábito que nunca te muerde. Todo lo demás (acentos, guiones, emoji) puede ser UTF-8 sin formato en una página correctamente declarada.
¿Cuál es la diferencia entre < escrito como una entidad con nombre y <
Nada, una vez que el navegador los analiza, ambos producen un signo menor que. El formulario nombrado es una búsqueda en el estándar WHATWG 's tabla de referencias nombradas; < aborda el punto 60 del código Unicode directamente y < es el mismo punto de código en hexadecimal. Las entidades nombradas son más fáciles de leer para los humanos; Las referencias numéricas funcionan para todos los caracteres, incluidos miles que no tienen nombre. Para los especiales comunes, elija lo que su equipo encuentre más legible; a los navegadores no les importa.
¿Por qué mi página muestra &amp; en lugar de un ampersand?
Doble escape. Alguna capa de su pila escapó de una cadena ya escapada, convirtiendo & en &amp;. El navegador decodifica un nivel y muestra el resto. Por lo general, significa que dos componentes piensan que escapar es su trabajo: un CMS al guardar más una plantilla al renderizar es el par clásico. Decodificar la cadena una pasada a la vez en un decodificador; el número de pasadas hasta que se lea limpio es igual al número de capas que se escapan. Luego haga exactamente una capa responsable, en el momento de la salida.
¿Escapar HTML previene XSS?
En contextos de atributos y cuerpo HTML, sí, la entrada no confiable de codificación de entidades es la defensa central, porque la carga útil se representa como texto inerte. Pero no es suficiente en todas partes. La hoja de trucos de prevención de OWASP XSS es explícita en que las cadenas, URL y CSS de JavaScript necesitan cada uno su propia codificación específica del contexto; la codificación de entidades dentro de un bloque de script no hace nada. Escape en la salida, en el contexto en el que está saliendo, usando ese contexto & #39;s codificador. La codificación de entidades es una herramienta de ese kit, no de todo el kit.
¿Cuál es la diferencia entre HTMLSpecialChars y HtmlEntities en PHP?
htmlspecialchars() escapa solo a los caracteres significativos del marcado, y debes pasar ENT_QUOTES para que cubra la cita única. htmlentities() convierte cada carácter que tiene una entidad nombrada, por lo que las letras acentuadas se convierten en cosas como la referencia uuml. En las páginas UTF-8, htmlspecialchars() es casi siempre lo que desea; htmlentities() infla la salida y provoca mojibake cuando los conjuntos de caracteres están mal configurados. Los desarrolladores de WordPress en su mayoría evitan la pregunta utilizando esc_html() y esc_attr(), que aplican los indicadores correctos por contexto.
¿Debo usar la entidad APOS llamada para apóstrofes?
Prefiero '. El nombre apos es válido en HTML5 pero nunca formó parte de HTML4, por lo que los analizadores más antiguos, incluidos los motores de renderizado dentro de algunos clientes de correo electrónico, no lo reconocen y lo mostrarán literalmente. La forma numérica ' significa el mismo carácter y funciona en todo lo que se envía. Es una opción fea pero segura, que suele ser la compensación adecuada para escapar. Si sabes que tu salida sólo llega a los navegadores modernos, apos está bien; Las plantillas de correo electrónico están exactamente donde no puedes saberlo.
¿Es seguro pegar datos de usuario en un conversor de entidades en línea?
Sólo si la herramienta procesa texto en su navegador. El contenido generado por el usuario y las plantillas de correo electrónico contienen habitualmente nombres, correos electrónicos y otras PII, y un conversor que publica su entrada en un servidor acaba de recibir esos datos sin ningún acuerdo vigente. El codificador/decodificador de entidades HTML Toolz.dev se ejecuta 100% del lado del cliente, sin carga ni registro, y funciona sin conexión una vez que la página se ha cargado. Si no puede verificar cómo una herramienta maneja la entrada, no pegue datos de producción en ella.
Escape una vez, en el lugar correcto
Si tomas una cosa de una década de mis errores de escape, toma esto: exactamente una capa de tu pila debería escapar y debería ser la capa de salida. Guardar UTF-8 limpio. Escape de los cinco especiales en el momento del renderizado, en el contexto en el que se está renderizando. cada &amp; en producción hay un mapa de dos componentes peleando por ese trabajo, y cada cadena de usuario sin escapar es un XSS almacenado esperando una revisión del código que podría no suceder. El mío casi no lo hizo 't.
mantener el Codificador de entidades HTML en su rotación de depuración junto a sus hermanos, el Codificador de URL/decodificador Para contextos de codificación porcentual (el Guía de codificación de URL pasa por %2520, el primo codificador de porcentaje de &amp;), el Convertidor Base64 para cargas útiles envueltas, y el Convertidor de caja para el trabajo de gruñido de cambio de nombre de identificador entre ellos. los Guía de herramientas de codificación Camina todo el conjunto.
Y dado que las cadenas que depuras suelen ser el nombre real o el correo electrónico de alguien ': todo lo anterior se ejecuta en el lado del cliente, nada cargado, verificable en la pestaña de tu red. Eso' no es marketing - eso' es la razón por la que construí estas herramientas como lo hice. Más sobre esa filosofía en el Guía de privacidad de datos.


