2021 年頃、WP Adminifyのサポートチケットが、まだひるむようなスクリーンショットで着陸しました。 ユーザーがカスタム管理者のフッターテキストを設定していました - aと完全に無実の著作権行 © そして彼らの代理店へのリンク。 彼らの画面上で、次のようにレンダリングされます © 2021 — Bright & Co。 3 つのエンティティが表示され、ゼロにレンダリングされた文字。 犯人は私でした。 保存ルーチンはテキストをエスケープし、レンダリング ルーチンは再びエスケープされ、フィルターの間のどこかで 3 回目のエスケープが発生しました。 ブラウザーにぶつかるまでに、その貧弱なアンパサンドは 4 回エスケープされていました。 数えました。
修正には 10 分かかりました。 エスケープされたテキストが見えるので、2 晩かかった ほぼ そうです。 あなたはすくい取る © データベースのダンプで、脳がそれを自動修正します ©。 ブラウザが各レイヤーで実際に何をレンダリングするかを確認するためだけに、文字列をスクラッチ HTML ファイルに何度も貼り付けました。 これは、悲惨なワークフローであり、まさにそのため、HTML エンティティ エンコーダ デコーダーが、私が Toolz.dev に組み込んだ最初のツールの 1 つです。
同じコインの裏側はもっと怖いです。 そのチケットの数か月前、自分のプラグインのコード レビュー中に、ユーザーの入力を管理者通知に反映させる設定フィールドを見つけました。 esc_html()。 そのフィールドにアクセスできる人は誰でも保存できたはずです <script> そしてページを読み込んだ管理人全員に対して実行させました XSSを自分のコードに保存し 1 つの欠落していた関数呼び出しを離れて 誰も悪用しませんでした - 幸運にも恵まれました しかしそれはエスケープに対する私の考え方を 永久に変えました: it's not a formatting chore, it's the boundary between "text" and "code."
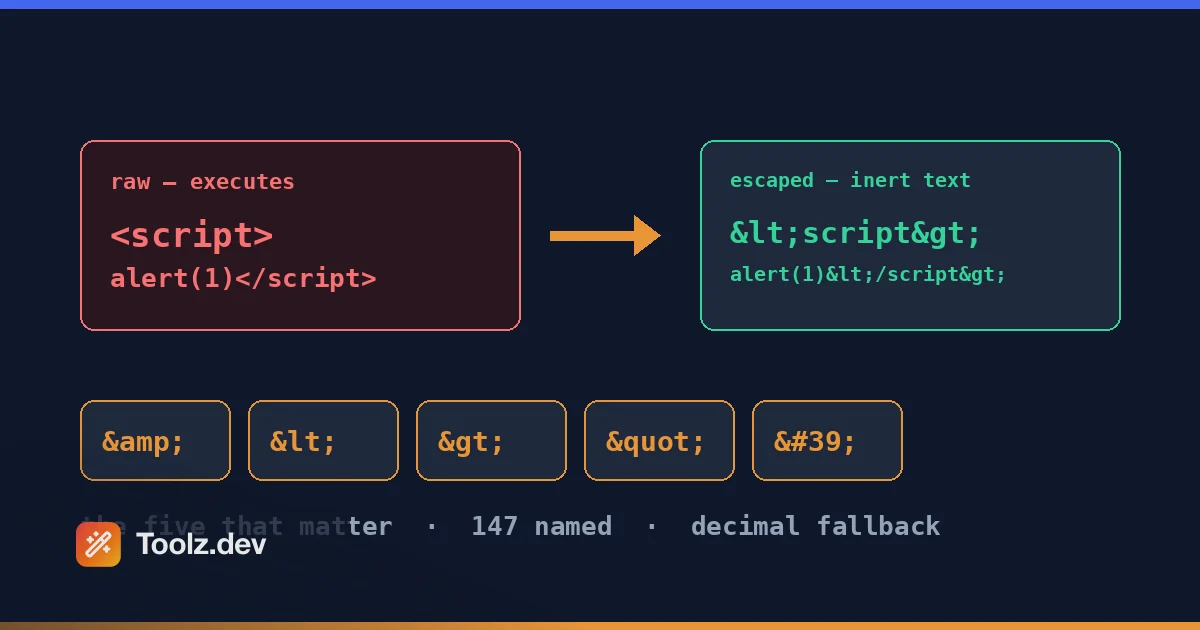
したがって、このガイドでは両方向をカバーしています。エンコーディングなので、信頼できないテキストはテキストのままです。デコーディングなので、一部の過度に熱心なパイプラインがめちゃくちゃになっているものを読むことができます。そして、十分な理論 - 名前付き参照と数値参照、実際に重要な 5 文字、なぜ操作の順序が二重エスケープを引き起こすのか - を推測する代わりにデバッグできます。
tl;dr: テキストにテキストを貼り付けます Toolz.dev HTML エンティティ エンコーダ/デコーダ 生の文字とエンティティをいずれかの方向 (名前付き、10 進数、または 16 進数) に変換するには。 100% クライアント側で実行されるため、ユーザー コンテンツと PII はブラウザから離れることはありません。経験則: 常に 5 つのスペシャルをエスケープします ()
& < > " ') 信頼できない入力でエンコード&最初に、またはあなたがダブルエスケープします。
主な機能
両方向にエンコードしてデコードする
半分は回す必要がある <script> に <script> だから、それはブログ記事のテキストとして表示されます. I& #39; mの反対方向に行く - スクレープを回します &#8217;s 読みやすいアポストロフィに戻ります ツールは両方を処理します テキストを貼り付けます エンコードまたはデコードを選択します 完了しました モードハンティングはありません 方向ごとに個別のツールはありません それは些細なことのように聞こえます あなた& #39; デコードのみを行うツールを使用し、あなたは自分自身がドキュメントのコードサンプルをエンコードするために2 番目のタブを開くことを見つけます ラウンドトリッピングも素晴らしい正気度チェックです: エンコード、デコード、そして元の文字列を取り戻すことを確認します あなたが & #39; t を行うと、入力内の何かがすでに部分的にエスケープされていました - それ自体が有用な情報です。
名前付きエンティティ: &amp;lt;、© およびその友達
名前付き文字参照は人間が読めるものです - & &、 < &lt;、 © ©のために、 — EM-DASH の場合。 このツールには、有名な 5 つだけでなく、147 の名前のキュレートされた表があります: タイポグラフィ ( 、 …、 ’、 “)、通貨、数学と矢印、ギリシャ文字、完全なラテン-1 アクセント付きの範囲、およびカードスーツのようないくつかのオッズ。 その範囲は、現実世界のコンテンツが実際に必要とするものです - WordPressは発します 、 …、そして ’ wptextureize を介して、12 の名前しか知らないデコーダが、テキストの半分が未解決の参照で散らばったままになります。
147 が何ではないのかを明確にしてください WHATWG HTML Standardは2,200 以上の名前付き参照を定義しているので、これは完全な表ではなく実用的なサブセットです。 name isn' tがその中にある場合、デコードすると、参照は推測するのではなく、手つかずのままになります - &bogus; として出てくる &bogus;。 エンコーディングには補完的な動作があり、半分の方が役に立ちます: 任意の文字 なしで テーブル内の名前は自動的に 10 進数値参照にフォールトするため、何もサイレントにドロップされません。 絵文字は次のようにエンコードされます。 🌍、中国語のテキストとして 你好。 それらが存在する場所の名前、他の場所の数字。
ブラウザの動作との相違がもう 1 つあります。デコーダは大文字小文字を区別し、セミコロンが必要です。 ブラウザは解決します © そしてむき出しでも & いくつかの解析コンテキストで後続のセミコロンなし, レガシー互換性ルールのおかげで; このデコーダはどちらも解決しません. 実際には that& #39; s 罰金 - 何でもモダンなツール 生成します 小文字で終了しますが、you'古代の CMS からスクレイピングされた HTML を再デコードすると、that's のエッジ you'll がヒットします。
数値参照: 10 進数および 16 進数
任意 ユニコード 文字は、数値文字参照 (10 進数) として記述できます — または、16 進数のよう — (どちらも em-dash です)。 デコーダは両方のフォームを解決します。 これは、標準に名前がない文字のエスケープ ハッチであり、API レスポンスと RSS フィードで常に満たされるフォームです。 ’ (右一重引用符) は実質的に署名です。 hex references map directly to Unicode code points - U+2014 は —- だからこそ、I' が Unicode チャートと相互参照する場合に、私はそれらを好みます。
正直なところ、ツールを使用してから 1 分以内に気付くでしょう: 数値 エンコードする モードは 10 進のみを出力します。 16 進出力オプションはありません。 デコード — うまく動作します; エンコーダにそれを生成するように依頼する does't. 2 つのフォームは意味的にすべてのブラウザと同一であるため、これは機能的には何もかかりませんが、コードベースが16 進数で標準化されている場合 you' 手動で変換されます 私のリストにあるIt' s.範囲外の参照は、めちゃくちゃではなく捕まります - � は Unicode Maximum を超えており、置換文字ではなく明示的なエラーを返します。
完全な Unicode カバレ
絵文字、CJK文字、アラビア語、発音記号を組み合わせ、作品.コードポイントがある場合、ツールはエンティティとして表現し、それを解決することができますバック.これはあなたよりも重要です& #39; d ローカリゼーション作業のために考える - I& #39; として到着するドイツのumlautsをデバッグしました ü 1 つの翻訳ベンダーから、そして RAW UTF-8 として ü 別の、同じインポート ファイルから。 Latin-1 の外で窒息するツールは、それには役に立ちません。 U+FFF の上の文字 (絵文字はそこにある) は、マングルの代理ペアではなく、単一のコード ポイントとして正しく処理されます。
もつれを解く ダブルエスケープテキスト
ザ・ &amp; 問題。 パイプラインの 2 つの層が両方とも脱出すると、 & なる &amp;- そして 3 つのレイヤーがあなたに与えます &amp;amp;。 一度デコードすると、1 つのレイヤーが剥がれ落ちます。デコーダを繰り返し実行して、Onion のラップを解除するのを確認できます。 &amp;amp; → &amp; → & → &。 パスを数えると、スタックの何層がエスケープされているかがわかります。これは、4 回エスケープされた WP がフッター バグを管理するときに必要な診断とまったく同じです。 レイヤーごとに 1 つのデコード。 これは、パイプラインのどこに余分なエスケープが発生するかをローカライズする最も簡単な方法です。
文字数を含む並列のペイン
左に入力、右に出力、文字は両方の上にカウント そのカウントペアは、それが聞こえるよりも多くの仕事をします: エスケープは拡張操作なので、40 文字をエンコードして44 を取り戻すと、ちょうど1 つの特殊文字がタッチされたときに、I& #39; mは、テンプレートがすでに何かをエスケープしたかどうかを監査すると、デルタ、I& #39; 出力の単一の文字を読み取る前に私に教えてくれます エンコード、デコード、スワップ、クリアはボタンです - there& #39; sは、意図的なトレードオフであることを認めますI& #39; 私は時々後悔します 明示的なアクションは、テキストを生成した方向を常に知っていることを意味しますyou& #39;re 見て、バグをエスケープすると、あいまいさが問題全体ですが、探索的な突っ込みの場合、キーストローク駆動型バージョンは本当に素敵になります。
100% クライアント側 - 何もアップロードされていません
すべてブラウザで実行されます。リクエストなし、サーバーなし、ログなし。これは isn't 持ちやすいです。テキスト you're エスケープは、多くの場合、ランダムな Web サイトに貼り付ける必要があるテキスト 't です。実名でユーザーが作成したコメント、顧客アドレスを含む電子メール テンプレート、サポート チケット コンテンツ。 I'これがなぜ重要なのかについては、以前に書いています データ プライバシー ガイド; 短いバージョンは、入力をアップロードするコンバータが、精査したことのないデータ プロセッサであるというものです。 ザ・ Toolz.dev エンティティ ツール ロードされるとオフラインで動作します。 飛行機モードは有効なテストです - 試してみてください。
HTML エンティティ エンコーダとデコーダの使い方
ステップ 1: ツールを開いてテキストを貼り付ける
に行く Toolz.dev/tools/html-entities そしてあなたの入力を貼り付けます - コードスニペット、めちゃくちゃなRSSの抜粋、電子メールのテンプレートの断片、何でも. there& #39; s no size ceiling worth worrying about for normal use; I& #39; ve pasted entire rendered plugin changelogs in. 処理はクライアント側であるため、ここでは機密性の高いコンテンツで問題ありません。
ステップ 2: エンコードまたはデコードを選択
エンコーディングは、生の文字をエンティティに変換します (< → <) - マークアップをテキストとして表示したいときに使用します。 decoding はエンティティを文字 (文字) に戻します& → &) - you're reading escaped content のときに使用します。 you're sure which state your text is in.なら、まずデコードして、どんな変化があるか見てみましょう。 unchanged output は、それがすでに明白だったことを意味します。
ステップ 3: 参照スタイルを選択する (エンコードする場合)
モード ドロップダウンには、3 つのオプションがあり、選択は見た目よりも重要です。 なんだ 名前を持つすべてをエンコードし、残りの部分は 10 進数に戻ります。ソースと差分で読み取り可能ですが、エスケープもします ©、 —、 é とにかく UTF-8 を使用している場合、出力が膨らむ以外のすべての非 ASCII 文字。 数字 同じカバレッジは、10 進数で同じようにします。 特別な文字のみ 何も触れない & < > " ' そして、アクセント、em-dash、絵文字を生の UTF-8 として残します。これは私が実際のコンテンツに使用するもので、it'何に一致するモードです htmlspecialchars() PHPで行います。 注意してください ' いつものように出てくる '、決して '、3 つのモードすべてで、意図的なものです。 ' HTML 4 以降のメール クライアントでは未定義です。
ステップ 4: 出力を確認してからコピーします
エンコードまたはデコードを押して、右側のペインを読み込みます。 デコード ジョブの場合は、特に残り物を探します & sequences - a survivor はテキストが二重にエスケープされたことを意味するため、Swap を押して再度デコードします。 swap をきれいに読み取るときは、結果をテンプレート、CMS、またはコードにコピーします。 repeat ジョブの場合、損失が発生していないことを確認するために 1 回往復します (エンコードしてからデコードします)。
名前付きエンティティと数値エンティティ - そして実際に重要な 5 つの文字
Let's は、"HTML entity" が大まかに使用されるため、用語を正確に理解します。 WHATWG HTML 標準 (ブラウザーが実際に HTML を解析する方法を定義するリビングスペック) は、次のテーブルを指定します 名前付き文字参照: 2,200 以上の名前のような 、 —、 …、 →、それぞれの 1 つまたは 2 つの Unicode コード ポイントへのマッピング。 別に、 数字の参照 任意のコード ポイントに直接対処できるようにします。小数 (10 進数) (—) または 16 進数 (—. 同じ em-dash、3 つのスペル。
これは、何年にもわたる WordPress の仕事によって鋭く、私の意見のある見解です。 これらの 2,200 以上の名前のうち、正確性と安全性を重視するのは 5 文字だけです。 他のすべてはタイポグラフィーであり、UTF-8 ページで - これは2026 年に出荷するべきすべてのページです - あなたはただ本当の文字を入力することができます。 you don' need —; you need -. 重要となる5 つは、HTMLで構文上の意味を持つものです:
| キャラクタ | エンティティ | なぜ重要なのか |
|---|---|---|
& |
& |
すべてのエンティティ - エスケープ文字自体を開始します |
< |
< |
タグを開く |
> |
> |
タグを閉じる |
" |
" |
二重引用符付き属性を区切る |
' |
' |
一重引用符で囲まれた属性を区切る |
最後の行に注意してください。 '、ない '。 名前 ' は HTML5 で有効ですが、それは & #39; t HTML4 の一部であり、古いツーリング (および古い電子メール クライアント - 後でさらに詳しく) はそれにトリップする可能性があります。数値形式はどこでも機能します。これは、混乱を招くバグ レポートを保存する一種の衒学的なものです。
操作の順序はゲーム全体です。 エンコードするとき、 & 逃げなければならない 先に。 逃げたら < にする < そして、アンパサンドをエスケープすると、自分の出力を変換します &lt;ーおめでとう、you& #39;ve double-escaped.デコードは鏡像です: & 解決する必要があります 最後の、または &lt; なる < なる < そして、you' はデコードが不足しています (または、さらに悪いことに、意図的にエスケープされたテキストからライブ マークアップが再導入されました)。ほぼすべての手巻きエスケープ バグ I' がレビューしました (私自身のものも含めて) は注文バグです。
コンテキストが重要であり、ここでエスケープとセキュリティが出会います。 OWASP クロスサイト スクリプティング防止のチート シートは、それについては率直です: HTML エンティティ エンコーディングは、HTML に対する正しい防御策です。 からだ あんど 属性 文脈ですが、 でないよ JavaScript 文字列、URL、または CSS に十分です。 < 中 <script> block does't decode - スクリプトコンテンツ isn't parsed for entities - so entity-encoding does nothing useful there.各コンテキストは独自のエンコーダを必要とします: HTML用のエンティティエンコーディング、 \uXXXX JS 文字列のエスケープ、URL のパーセントエンコーディング (これが私たちの URL エンコーダ/デコーダ のためです)。 適切なエンコーダを間違ったコンテキストで使用することは、サニタイズされたコードを悪用できる従来の方法です。
PHP側で、あなたの 2 つの機能を知ってください。 htmlspecialchars() 5 つの特売品のみを脱出します (パス ENT_QUOTES あるいは、一言引用を見逃してしまうかもしれません。本当に気になります。 htmlentities() 脱出 every 名前付きエンティティがあり、回転 ü に ü。 UTF-8 ページでは、 htmlentities() ほとんどの場合、選択が間違っています。文字セットが誤って宣言されていると、出力が膨れ、コンテンツがマングルします。 WordPress はこれを賢明にまとめています。
echo esc_html( $footer_text );              // body context
echo '<a title="' . esc_attr( $title ) . '">'; // attribute context
esc_html() あんど esc_attr() どちらも、コンテキストごとに選択された、適切なフラグを持つ 5 つのスペシャルをエスケープします。OWASP が規定する、まさに遅れてエスケープする規律です。すべてのコード レビューにドリルインするルール: 出力時にエスケープし、output's コンテキストで、正確に 1 回エスケープします。
家に持ち帰る: UTF-8 を使用すると、めったにありません 必要 文字体裁のエンティティ。 マークアップの重要な文字と、信頼できない入力に必要です。 それ以外はすべてレガシーの習慣です。
よくある使用例
ブログ投稿やドキュメントにコード スニペットを表示する
を含むチュートリアルを書く <script> や <?php それを CMS RAW に貼り付ければ、ブラウザは 実行または飲み込む 表示する代わりに、あなたの例。 HTML コンテキスト内のすべてのコード サンプルが必要です <、 >、そして & エンコード. 私はプラグインドキュメントのためにこれを絶えず行います - readme HTML, ナレッジベースの記事, 管理者UIのヘルプタブでのインラインの例. ワークフロー: スニペットを書き, を通して実行します エンティティ エンコーダ、エスケープされたバージョンを中に貼り付けます <pre><code>。 30 秒、そしてあなたの <script> として表示 <script> ドムに消える代わりに。 ドキュメント ワークフローを一般的に構築している場合は、 コーディング ツール ガイド この周りのツールボックスの残りの部分をカバーします。
データベースとフィードからダブルエスケープされたテキストをクリーンアップする
ザ・ &amp; plague. cmsが保存時にエスケープし、プラグインがrenderでエスケープし、キャッシュレイヤーがもう一度助けになるときに表示されます。 wordpress.org readmeパーサーと私自身のビルドスクリプトがエスケープする人について意見が一致しないWP Adminifyの変更ログを出荷したことがあります - レンダリングされた変更ログには23 が表示されていました &ユーザーが私にメールを送る前に、そこにあります。 RSS フィードは悪く、フィードのコンテンツはしばしばエスケープされません。 中に XML, だから、消費者は日常的に過大または過小デコードします. fix は診断デコードです: 壊れたテキストを貼り付けます, 一度に 1 つのパスをデコード, それまで何回のパスを数えます & #39; s クリーンなそのカウントはエスケープするレイヤーの数に等しい - 今、あなたは正確にあなたのパイプラインの何個の部分がテキストに触れているか知っています, そして、あなたは冗長なものを見つけることができます。
ユーザー生成コンテンツを安全に準備する
コメント、レビューテキスト、プロフィールバイオ、サポートチケット - ユーザーが入力したものはすべて信頼されず、PIIを含むことがよくあります: 実名、電子メール、アドレス ここでは2 つの懸念が衝突します まず、安全性: そのコンテンツは出力時にエンティティエンコードされているか、あなた& #39; 1 つです <img onerror=...> 保存された XSS から離れています (私がほぼ出荷した設定フィールドについて聞いてください)。 第二に、プライバシー: デバッグ中 なんでや 特定のuser& #39; sバイオはあなたのレイアウトを壊し、you& #39; reは彼らの個人データを扱います - サーバー側のコンバーターに貼り付けることは、PIIをサードパーティに発送することを意味します Toolz.devツールはすべてをローカルで処理するため、実際の問題文字列をテストすることは安全です サンプルをエンコードし、テンプレートを検査します すべきです 生産してきたものとは異なり、生産したものとは異なります。
メール HTML テンプレート
EメールHTMLは20 年前のレンダリングエンジンを備えたWeb開発です 一部のクライアントは生のUTF-8 を問題なく処理します; 他のクライアント - ESPが転送エンコーディングを設定する方法に応じて - タイポグラフィ文字を文字化けする防御的な慣習 多くの電子メール開発者はまだ続きます: エンティティとして非ASCIIタイポグラフィをエンコードする ()—、 ’、 間隔のハックの場合) であるため、ワイヤ上のバイトは純粋な ASCII です。 そして覚えておいてください ' 上 '- Outlook& #39; s 古いエンジンは、HTML5 名を学習したことがないツーリングです。 templates は顧客名とアドレスでパーソナライズされるため、これもコンテンツ I& #39; d はクライアント側のツールを介してのみ実行されます。 template chrome を一度エンコードし、マージ フィールドを生のままにして、マージ時にエスケープします。
スクレイピングされたコンテンツと API の応答のデコード
ページをスクレイピングするか、ずさんな API を消費すると、夢中になるでしょう ’、 “、 &、そして 。 APIによっては、JSON (HTMLエスケープを全く必要としない形式) 内にエンティティエンコードされた文字列を返すので、 のようなアーティファクトが得られます "title": "Fish & Chips"。 データを自分のデータベースに入れる前に、それをデコードして UTF-8 をクリーンアップし、出力にエスケープする正規文を保存します。 Laravel アプリにコンテンツをインポートするとき、私は常にこれを打ちます: 最初にエンティティをデコードします。 そしたら かなり印刷してペイロードを検査します。 JSON フォーマッタ.他の順序で行うということは、すべてのアポストロフィが7 文字の長さのJSONを読み取ることを意味します。 payloadがその上にbase64-wrapされている場合は - 一部のWebhookプロバイダーがこれを行います - the Base64 コンバーター 外側のレイヤーを処理します。 Base64 エンコーディングガイド ラッピングが存在する理由を説明します。
特殊文字を使用したコンテンツのローカライズ
翻訳ファイルは、考えられるすべての州に到着します。 あるベンダーがクリーン UTF-8 を送信する ü; 別の送信 ü; 3 分の 1 の送信 ü; 時折、3 つすべてを1 つのPOファイルで取得します。 importする前に、デコードパス - 正規ストレージ、一貫性のある検索、正気の差分 - ですべてをraw UTF-8 に正規化します。 RTL句読点、CJK括弧、および出荷された文字列のアクセント付きラテン語にも同じことが当てはまります。 import時にデコードし、実際の文字を保存し、出力レイヤーを5 つの特殊のみエスケープさせます。 あなたの翻訳者もまた感謝します: über 誰でも校正しなければならない言葉ではありません。
名前付き vs 10 進数 vs 16 進数と 生 UTF-8: どれを使用する必要がありますか?
| フォーム | 例 (em-dash) | 可読性 | ブラウザのサポート | いつ使うか |
|---|---|---|---|---|
| 名前付きエンティティ | — |
良い - 自己記述 | HTML4 時代の名前にユニバーサル、HTML5 のみの名前 (たとえば、次のようにします) ') 古いツールで失敗する |
5 つの特集; メール HTML などのレガシー コンテキスト |
| 10 進参照 | — |
悪い - it' s 数 | ユニバーサル、古代のパーサーを含む | 名前のない文字; 最大互換性のエスケープ (') |
| 16進数の参照 | — |
悪いけど、Unicode コード ポイントへのマップ | どこでも普遍的で、どこでも現代的 | Unicode チャートまたは仕様を相互参照する場合 |
| 生の UTF-8 | — |
完璧 | UTF-8 ページで正しく宣言されている場合 | すべて活版印刷 - これがデフォルトである必要があります |
私のスタンス、はっきり言って: 生の UTF-8 をタイポグラフィに書き、エンティティを 5 つのスペシャルと信頼できない入力に予約します。 でいっぱいのドキュメント — あんど … は誰も校正できない文書であり、2008 年以来その charset 宣言を信頼してきた 't ワークフローを示しています。最新のスタック - WordPress、Laravel、Next.js、あなたと #39;d が今日選択したすべてのデータベース - は UTF-8 の端から端まで実際の文字を入力します。
エンティティが保たれる場所: &、 <、 >、 "、そして ' マークアップと解釈できるものについては、出力時に適用される例外は、常にありません。 そして、敵対的なレンダリング環境では - 電子メールクライアント、未知のパーサーによって消費されるフィード - 数値参照は、すべての互換性引数よりも前のものであるため、偏執的だが正当な選択です。 10 進数と 16 進数の間では、it's の味; 私は 16 進数をリーンします — U+2014 に一致し、頭の中で基本変換をやめることができます。
よくある質問
HTML エンティティとは何ですか?
HTML エンティティは、文字を直接書き込むのではなく、文字を表すテキスト シーケンスです。 アンパサンドで始まり、セミコロンで終わります。 & および © などの名前付き参照と、Unicode コード ポイントを指す © (10 進数) または © (16 進数) などの数値参照があります。 ブラウザは解析中に解決するため、< タグを開くのではなく、より少ない記号として表示します。 それらは存在するので、他の方法ではマークアップと解釈される文字を表示できます。
HTML でエスケープする必要がある文字はどれですか?
5: the ampersand, less-than, greater-than, double quote, and single quote - written as &, <, >, ", and '. ampersand, because it starts entities; the angle brackets, because they delimit tags; the quotes, because they delimit attribute values.要素の本文テキストでは、最初の3 つだけで済むが、どこにでも5 つすべてから逃げることは、あなたを噛むことのない習慣である。 else - アクセント、ダッシュ、絵文字 - は、適切に宣言されたページで生のUTF-8 になることができます。
< が名前付きエンティティとして書かれていることと < との違いは何ですか?
何も、一度ブラウザがそれらを解析すると - どちらも少ない符号を生成します。 namedフォームは、WHATWG標準でルックアップです& #39; 名前付き参照のテーブル; & #60; アドレスUnicodeコードポイント60 直接、および& #x3C; 16 進数で同じコードポイントです 名前付きエンティティは、人間が読みやすいです; 数値参照は、名前のない何千もの文字を含むすべての文字のために動作します。 一般的なスペシャルのために、チームがより読みやすいものを見つけたものを選びます - ブラウザは気にしません。
ページにアンパサンドではなく、なぜページが表示されますか?
ダブルエスケープ.スタックのいくつかのレイヤーは、すでにエスケープされた文字列をエスケープし、& を &amp; にしました.ブラウザは 1 つのレベルをデコードし、残りを表示します.通常、2 つのコンポーネントの両方がエスケープが自分の仕事であると考えていることを意味します - 保存時の CMS とレンダー上のテンプレートが古典的なペアです.デコーダで一度に 1 回パスする文字列をデコードします; クリーンに読み取られるまでのパス数は、エスケープするレイヤーの数に等しくなります。その後、出力時に正確に 1 つのレイヤーに責任を持たせます。
HTML を逃れると XSS が防げますか?
HTML body と attribute コンテキストでは、はい - エンティティエンコーディングの信頼できない入力にはコア防御があります、なぜならペイロードは不活性テキストとしてレンダリングするからです。しかし、どこでも十分ではありません。 OWASP XSS 防止チートシートは、JavaScript 文字列、URL、および CSS にはそれぞれ独自のコンテキスト固有のエンコーディングが必要であることを明示しています; スクリプトブロック内のエンティティエンコーディングは何もしません。出力時に、出力しているコンテキストで、そのコンテキスト' s エンコーダを使用してエスケープします。エンティティエンコーディングは、キット全体ではなく、そのキット内の1つのツールです。
htmlspecialchars と htmlentities の php の違いは何ですか?
htmlspecialchars()は markup-significant 文字のみをエスケープします - そして、それが単一の引用をカバーするようにent_quotesを渡す必要があります。 htmlentities()は、名前付きエンティティを持つすべての文字を変換するので、アクセント付き文字は uuml 参照のようなものになります。 utf-8 ページでは、htmlspecialchars()はほとんど常に必要なものです; htmlentities()は出力を肥大化し、文字セットが誤って構成されているときに mojibake を引き起こします。 wordpress 開発者は、コンテキストごとに右フラグを適用する esc_html()と esc_attr()を使用して、ほとんど質問を回避します。
アポストロフィに APOS 名前付きエンティティを使用する必要がありますか?
Prefer '. apos名はHTML5 では有効だがHTML4 の一部ではなかったので、古いパーサー - いくつかのメールクライアント内部のレンダリングエンジンを含む - はそれを認識せず、文字通りに表示する。 ' という数値形式は同じ文字を意味し、これまで出荷されたすべてのものの中で動作する。 醜いが安全な選択であり、これは通常、エスケープするための適切なトレードオフである。出力は最新のブラウザにのみヒットすることがわかっている場合は、aposは問題ありません。 emailテンプレートは、あなたがそれを知ることができない場所に正確に存在します。
ユーザー データをオンライン エンティティ コンバーターに貼り付けても安全ですか?
ツールがブラウザでテキストを処理する場合のみ ユーザー生成コンテンツとメールテンプレートには、名前、メール、その他のPIIが日常的に含まれており、入力をサーバーに投稿するコンバーターは、合意が締結されていない状態でそのデータを受信したばかりです。 Toolz.dev HTML Entities Encoder/Decoderは100% クライアント側で実行されます - アップロードもログもせず、ページがロードされるとオフラインで動作します。 ツールが入力をどのように処理するかを確認できない場合は、そのツールに生産データを貼り付けないでください。
一度逃げる、正しい場所で
私の 10 年間のエスケープ ミスから 1 つのことを理解した場合、次のことを考えてみましょう。スタックの 1 つのレイヤーがエスケープされ、それが出力レイヤーである必要があります。 きれいな UTF-8 を保管してください。 レンダリング時にレンダリングするコンテキストで、5 つの特集をエスケープします。 毎に &amp; 本番環境には、そのジョブをめぐって争う 2 つのコンポーネントのマップがあります。そして、エスケープされていないすべてのユーザー文字列は、コード レビューを待っている格納された XSS ですが、それは起こらない可能性があります。ほとんどそうでした't.
を保持します HTML エンティティ エンコーダ/デコーダ 兄弟と一緒にデバッグをローテーションすると、 URL エンコーダ/デコーダ パーセントエンコーディング コンテキスト ( URL エンコーディング ガイド 通り抜ける %2520、パーセントエンコーディングのいとこ &amp;)、 Base64 コンバーター ラップされたペイロードの場合、 ケースコンバーター 識別子を変更するためのグラントは、それらの間で機能します。 ザ・ コーディング ツール ガイド セット全体を歩きます。
そして、あなたがデバッグする文字列は、そう頻繁にsomeone& #39; s実際の名前や電子メールであるので: 上記のすべてがクライアント側を実行し、何もアップロードされていない、あなたのネットワークタブで検証可能なこと& #39; sマーケティングではありません - it& #39; s私がこれらのツールを構築した理由 私がやったように. その哲学については、もっと データ プライバシー ガイド。


